上周有读者在群里贴了一段 vLLM 的启动日志,问为什么 24GB 卡跑 8K 上下文还行,跑到两万 token 就开始 OOM。
他压了 4-bit 权重,盘算得很清楚:27B 的模型压到四分之一,17GB 上下,24GB 卡绰绰有余。剩下的几个 GB,他以为够放上下文了。
不够。而且他漏算的那部分,跟参数量的关系不大。
Qwen3.8-27B 的模型卡里有一句很容易读过去的话:preserve_thinking 对所有 workload 默认开启。它的意思是,你多轮对话里每一轮模型想过的那些东西——<think> 里的内容——默认会被原样塞回上下文。这个默认值同时改动了三笔预算:上下文窗口、KV cache 容量、前缀缓存命中率。三笔账各算各的,但都被同一个开关拴着。
这篇文章就干三件事:把默认值到底做了什么说清楚,把 64 KiB 这个数字推一遍,然后告诉你什么情况下该关、什么情况下别关。
先说结论,方便你先判断要不要往下读:开关本身不是重点,重点是你的回传链路是否一致。全局开或全局关都能跑,最糟糕的是同一个会话里中途切换。
默认值不是“多想一会”,是把上一轮的草稿纸留在桌上
很多人看到“保留思考”,第一反应是模型会想得更深。不会。它想多深由 reasoning_effort 管,那是另一回事。preserve_thinking 管的是过去:前几轮已经想完的内容,要不要在下一轮请求里再喂一遍。
官方模型卡把默认行为写得很直白,大意是 Qwen3.8 会保留所有历史消息里的 thinking 块,在整个对话中维持一条完整的推理轨迹。真正定义行为的其实是 chat template 里的一行 Jinja:
|
|
三态,读一遍就够:
- 不传这个参数 —— 走
is undefined那一支,历史 thinking 全部渲染; - 显式传
True—— 同上,全部渲染; - 传
False—— 只有loop.index0 > ns.last_query_index的 assistant 消息(即最后一条用户消息之后产生的那条)保留思考,更早的都被剥掉。
默认开启的准确含义是“模板默认渲染历史思考”,不是“你的历史思考一定会被渲染”。中间的差别,在客户端。
这里有个容易被跳过的前提:模板只负责渲染,它不负责保存。reasoning_content 得由你的客户端存下来、放进下一轮的 messages 里,模板才有东西可渲染。如果框架在解析响应时只取了 content,把 reasoning_content 丢了,那开不开 preserve_thinking 完全等价——模板渲染出来的是空字符串,<think>\n\n</think> 里什么都没有。
这个故障最麻烦的地方是它不报错。请求成功,回答也正常,只是那条“保留的推理轨迹”从头到尾都不存在。
我这边的做法是先打印一次请求体,看清楚再说别的。不用装工具,十行代码:
|
|
跑第二、第三轮的时候看输出。全是 NO-REASONING,说明你的调用链在某处把字段丢了,这时候调 preserve_thinking 是白费功夫,先修回传。
字段确实在,再往下算钱。
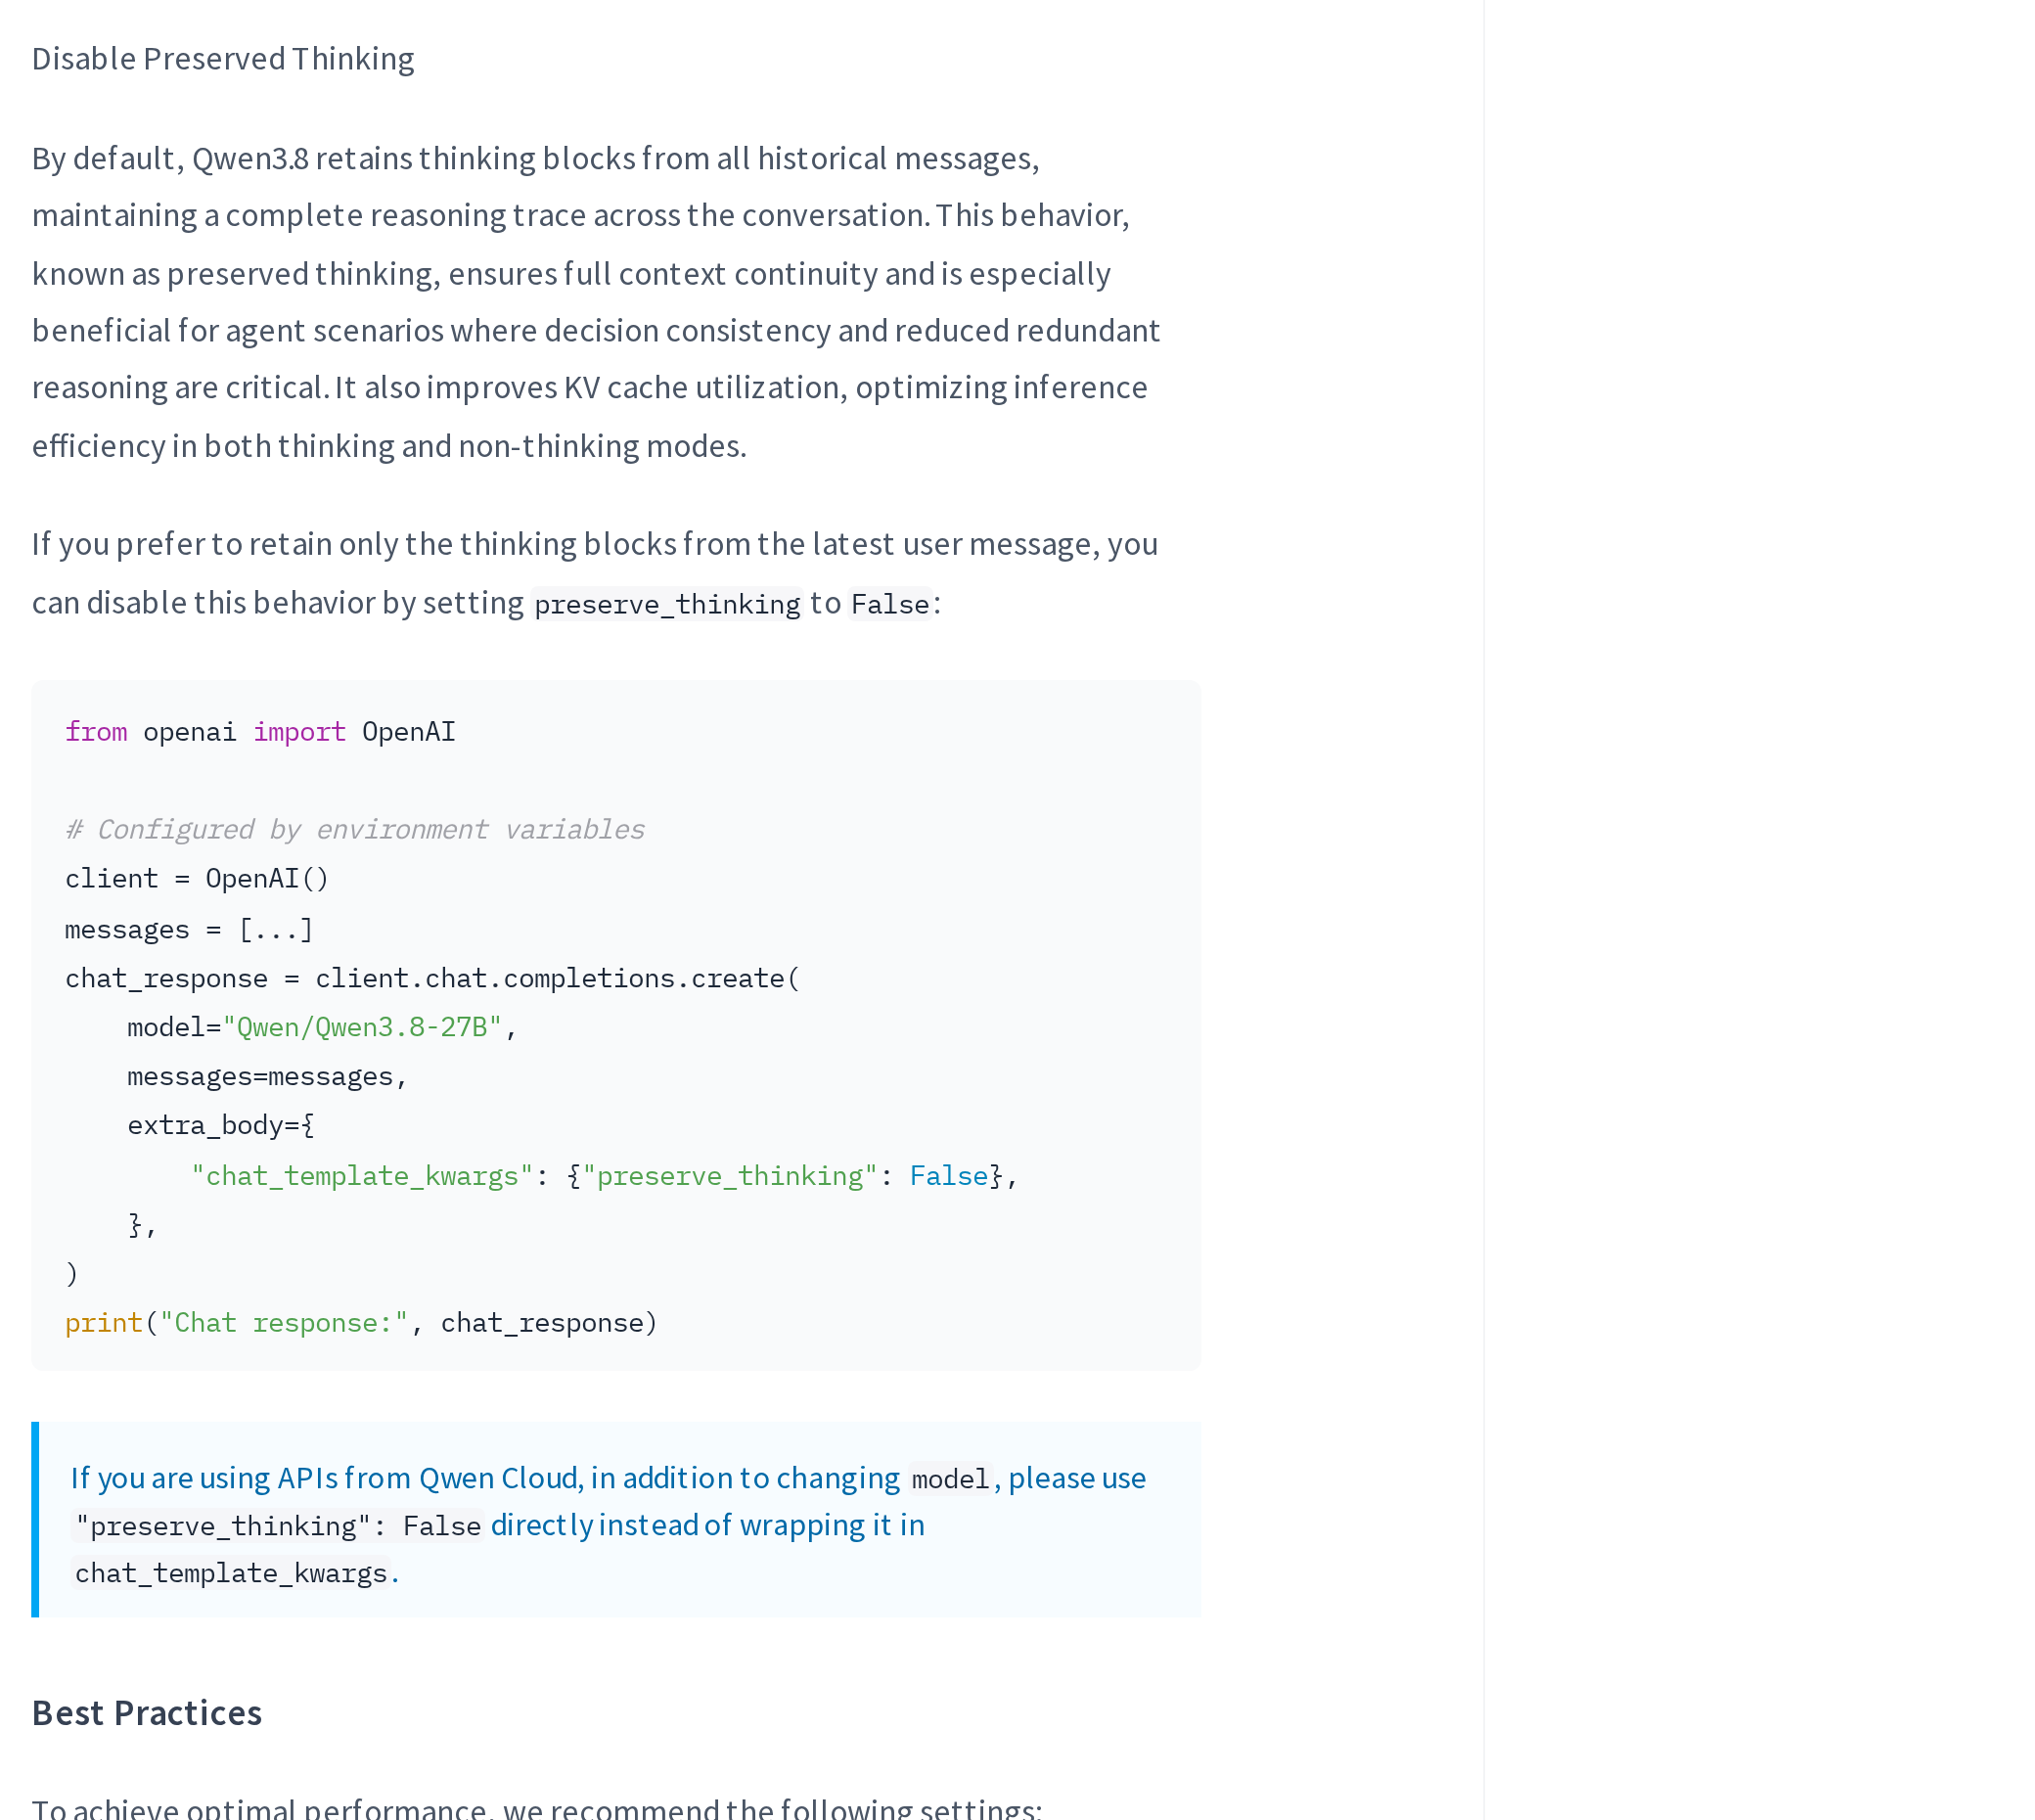 官方模型卡原文:默认保留全部历史 thinking 块,并称其能改善 KV cache 利用率;关闭写法在自托管与托管 API 上不一致。图源:Qwen 官方模型卡,访问于 2026-10-19
每 token 64 KiB:省显存的是那 48 层,不是这个开关
模型卡说保留思考“改善 KV cache 利用率”。这句话没错,但它说的是命中率,不是容量。两者被太多人混成一句“开了更省显存”。
先把容量这块拆开,因为它有确定答案。
模型卡里的结构描述是 16 × (3 × (Gated DeltaNet → FFN) → 1 × (Gated Attention → FFN)),总共 64 层。其中 48 层是 Gated DeltaNet——线性注意力,只维护一个固定大小的递归状态,不管你上下文多长,它的状态大小不变。剩下 16 层是 Gated Attention,真正的完整注意力,KV cache 只在这 16 层产生。
这 16 层的配置是:Q 头 24 个,KV 头 4 个,head dim 256。用 GQA,所以 K 和 V 各只有 4 个头。
于是每 token 的 KV 字节数可以一行算完:
|
|
2 是 K 和 V 两份,4 是 KV 头数,256 是 head dim,bytes 是每个元素的字节数(BF16 两个字节,FP8 一个字节)。乘上上下文长度:
- 3.2 万 token:2 GiB(FP8 1 GiB)
- 12.8 万 token:8 GiB(FP8 4 GiB)
- 26.2 万 token 原生上限:16 GiB(FP8 8 GiB)
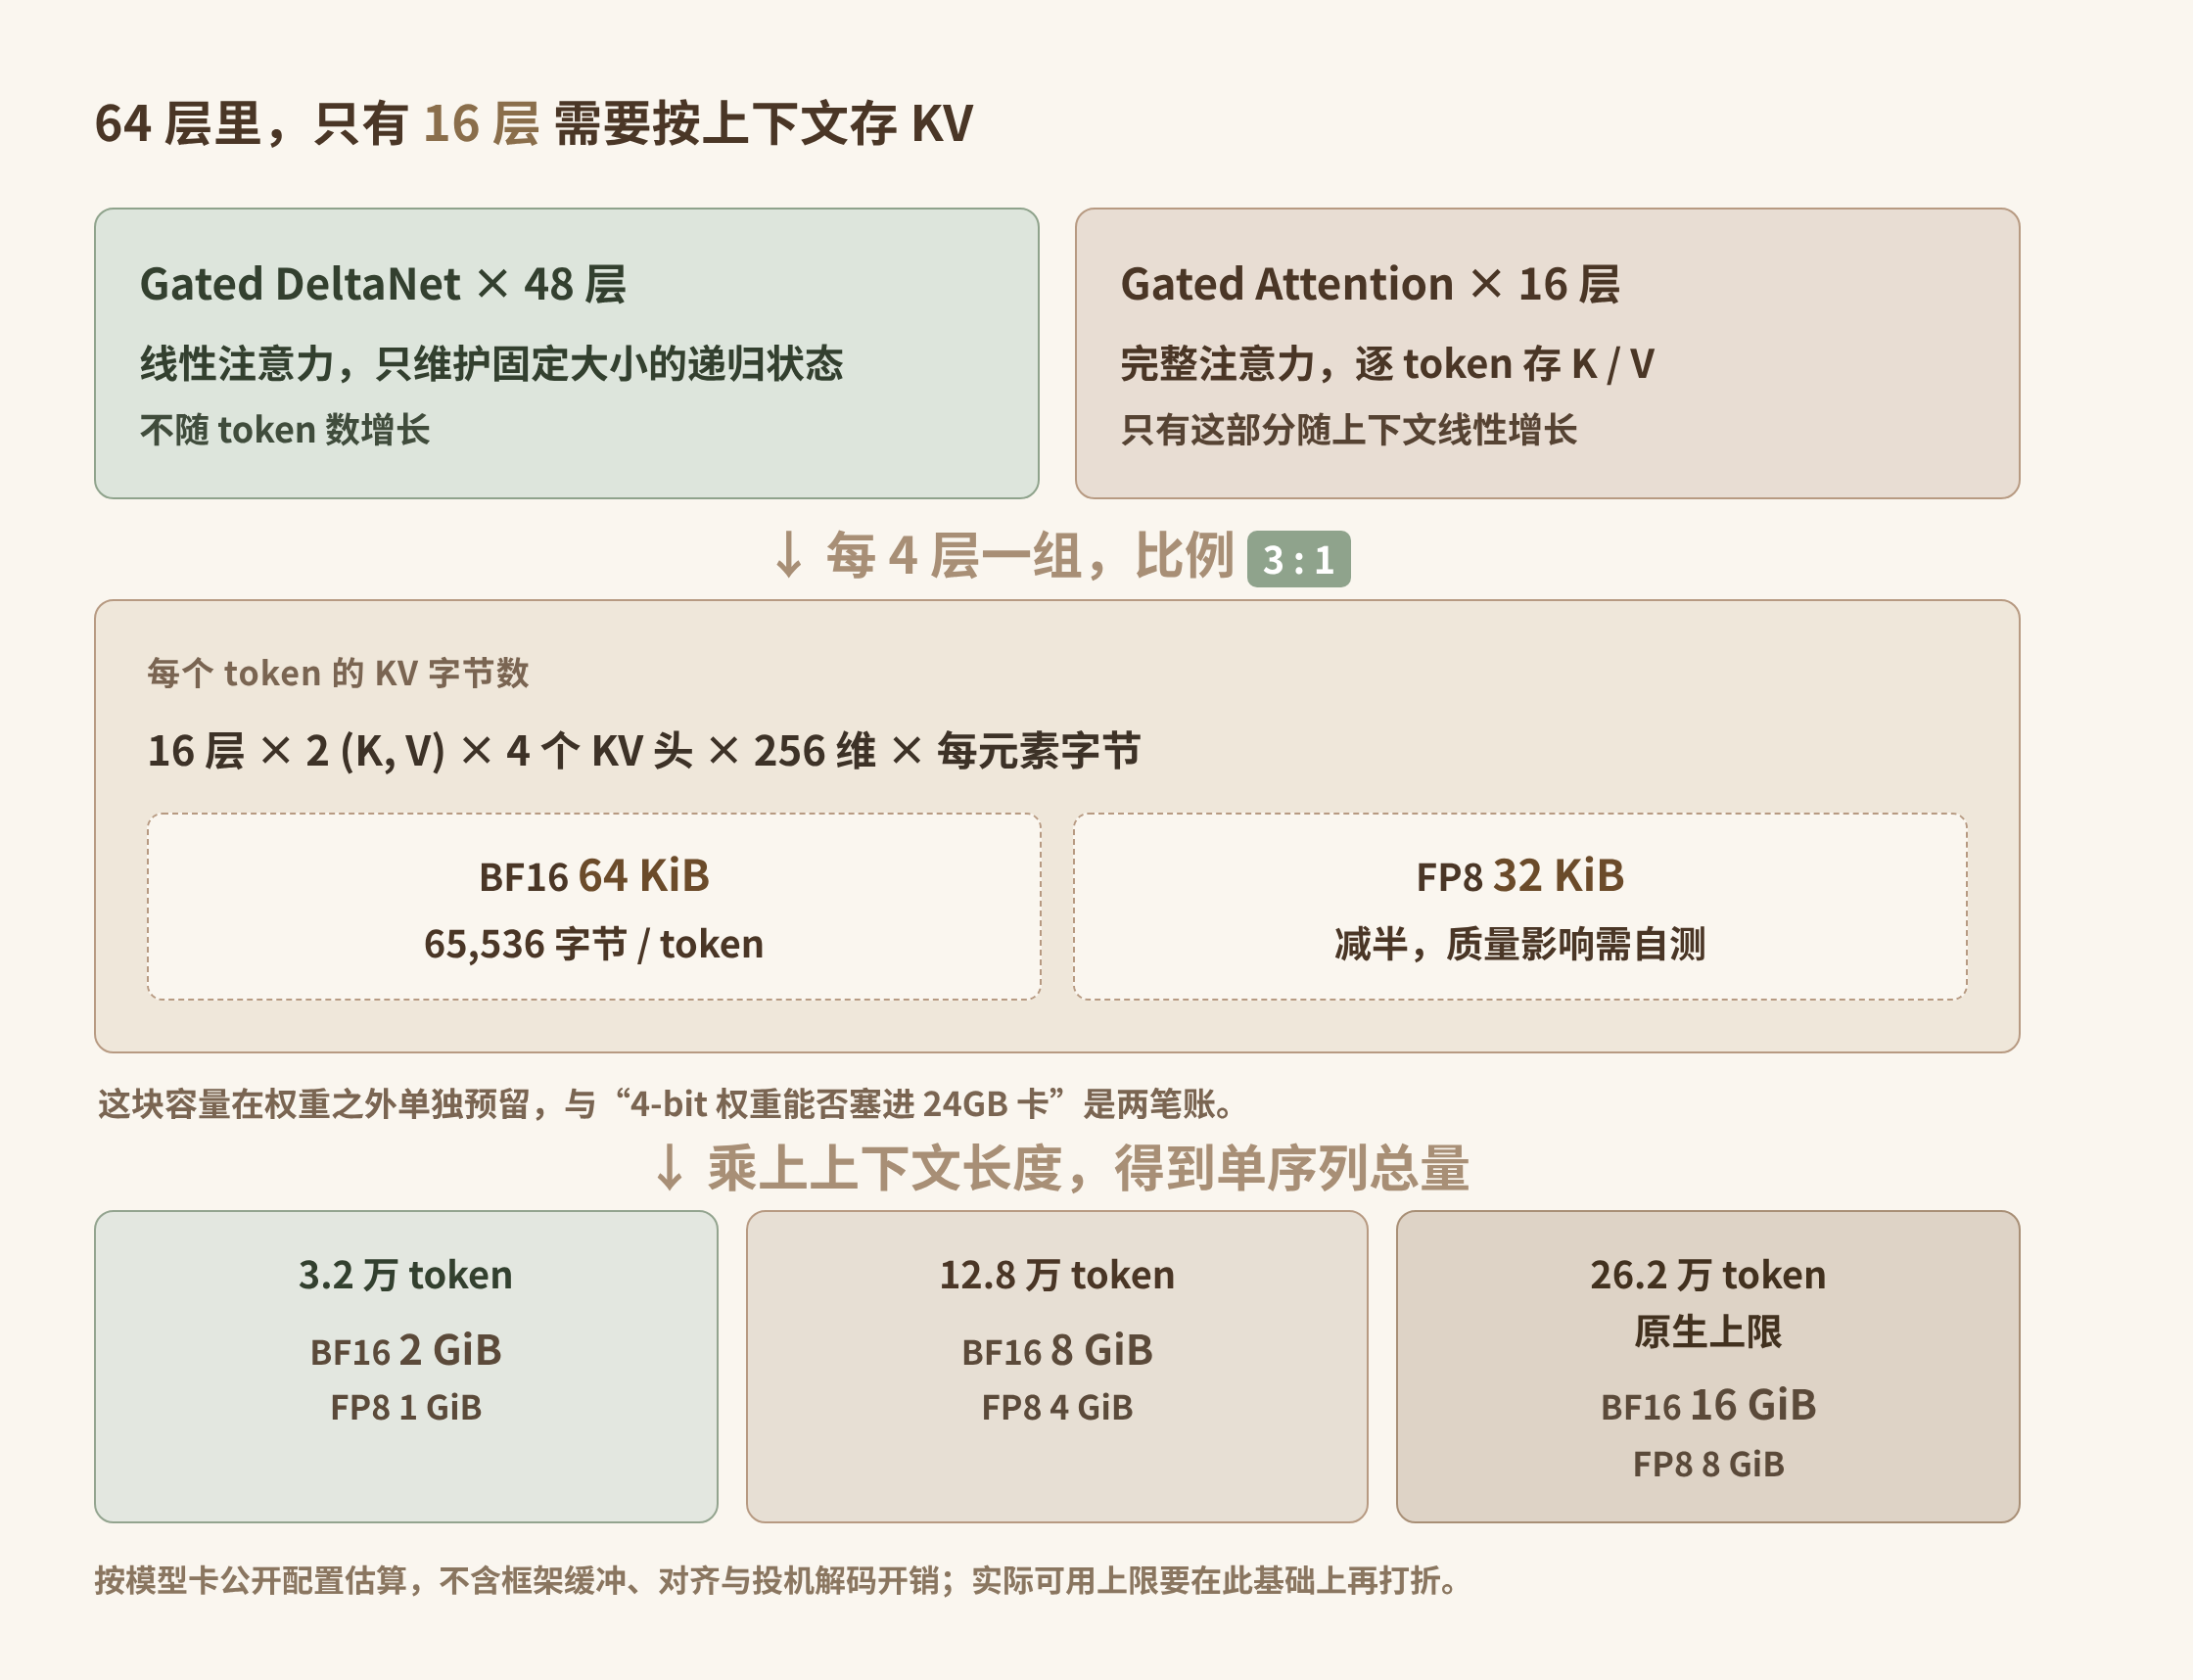 按模型卡公开配置推算的单序列 KV 占用,不含框架缓冲、对齐与投机解码开销。
回到开头那位读者:17GB 权重 + 26 万 token 的 16 GiB 缓存 = 33 GiB,24GB 卡根本装不下;即便他只用 8K 上下文,也还有运行时、CUDA graph、对齐填充这几项没算。所以“4-bit 权重能塞进 24GB”这句话本身没错,但它只回答了问题的一半。
这里我得诚实说一句:上面是按公开配置做的算术,不是实测。估算值不含 KV 分块对齐、Mamba 状态块、投机解码草稿和框架缓冲,真实占用一定比这个大。有第三方按整卡档位给的参考更保守——低比特量化下 8K 到 32K 上下文大概落在 19 到 21GB,跑到 26 万上下文约 34GB。方向是一致的,具体数字按你自己的框架实测。
反过来,这套 3:1 结构确实削弱了一个老经验。以前我们说“上下文越长越吃显存”,在纯 Transformer 上这条经验几乎线性成立;在这里,增长的只有那 16 层,48 层线性注意力的状态是常数。这就是为什么 27B 敢标 26 万原生上下文——省显存的是架构,不是这个开关。
preserve_thinking 在这里的作用是间接的:它决定历史 thinking 要不要占 token,而 token 直接乘进上面那个公式。开关本身不改每 token 的字节数,它改的是你有多少 token。
回传不一致的代价:省下的是输入 token,丢掉的是整条前缀
现在说命中率。这一节是全文最该记住的地方。
vLLM 的前缀缓存不是模糊匹配,是块级哈希链:每个块的哈希由父块哈希 + 本块 token 元组 + 额外哈希(LoRA ID、多模态输入等)共同决定。父块一变,后面所有块的哈希全变——这不是实现细节,是链条的定义。
也就是说,前缀里任何一个位置的内容不同,从那个位置往后的缓存全部作废。
于是“多轮时把历史 reasoning 删掉省 token”这个流传很广的写法,在开启保留思考的服务上会撞上同一个坑:第一轮你回传了 thinking,第二轮你把 thinking 删了,第二轮的 prompt 前缀和第一轮跑出来的前缀不一致,缓存命中率直接归零。
你省下了历史 thinking 的 token,丢掉了整段历史的重算。哪个更贵,取决于两件事的比例。
用变量写清楚临界点,别用某家报价,因为各家差得太远:
|
|
命中折扣越大,丢缓存越亏。现在主流厂商的缓存命中价通常是输入价的一到四分之一,这意味着一百个被复用的历史 token,价值大概相当于二十五到一百个新 token。历史 thinking 撑到几百 token 的时候,你省的那点钱,很快就被断链吃掉。
一个会踩的坑:删除历史 reasoning 的动作发生在“会话中途”。前半段开了、后半段关了,等于每一轮都在重算。要么全程原样回传,要么从头就不回传,别混。
这条机制不是 Qwen 独有的推理,行业里已经有产品把它写成硬约束。Z.AI 的保留式思考文档要求必须把完整的、未经修改的 reasoning_content 回传,所有连续的 reasoning 块必须与模型最初生成的序列完全一致,明说不得重排或编辑,否则性能和缓存命中率都会受影响。Kimi 的文档则从计费角度把同一件事讲明白:reasoning_content 计入 token 消耗,开启保留式思考后历史思考会持续占用上下文长度并计费。
两家说法不同,指向一个事实:保留思考的经济性建立在“逐字回传”上。省 token 和省缓存,在这里是对立的。
还有一个容易被当成结论的数字要打个问号。有第三方在 Qwen3.6 上做过一次三轮 A/B:开与不开 preserve_thinking,prompt 分别是 55 和 51,completion 分别是 355 和 382。看着像“保留思考能省生成”,但这是 n=1、单任务的观测,样本小到不能外推。我自己也不会拿它当结论——Qwen3.8 上任务复杂度一变,方向完全可能反过来。
按轮次决策,而不是给整个应用一个布尔值
到这里三笔预算都清楚了。最后落到怎么用。
先说一条硬规则,比任何精细调优都重要:同一个会话内,回传方式保持一致。 这不是优化建议,是正确性边界。中途切换会让你既拿不到“推理连贯”的好处,又付掉断链的代价。
在这条规则之下,按轮次分档是划算的:
首轮。没有历史,开关无意义。这里真正要设的是 reasoning_effort 和输出上限。顺带说一个模型卡明确提醒过的点:在多轮 agent 任务里,降低 reasoning_effort 不一定减少总耗时。单轮响应可能更快,但分析不足会带来更多失败和重试,总延迟和总 token 反而上升。所以别为了省钱一上来就压到 low。
探索轮(读文件、试命令、翻目录)。历史思考的复用价值低。这一阶段模型想的是“先看看这个文件写了什么”,结论在两三轮后就没用了,留着只是占窗口。这是最值得考虑不回传的时段。
执行轮(改代码、连续工具调用)。这是保留思考真正有价值的地方。模型上一轮已经确认了“这个函数签名在哪、为什么不能动那个字段”,这些决策链如果被剥掉,它会重新推一遍,或者推出一个不一样的结论——后者更糟。
收尾轮(写总结、生成最终答复)。几乎不需要历史思考,但注意:你的总结质量依赖前面执行轮的结论,所以别在这一轮删前面的 thinking 来省窗口,那等于让模型凭记忆复述。
分档策略定好了,接下来是两套环境的写法差异。这个坑不报错,只是悄悄不生效:
- 自托管 / OpenAI 兼容接口:
extra_body={"chat_template_kwargs": {"preserve_thinking": False}},参数要包一层; - Qwen Cloud:直接传
"preserve_thinking": False,模型卡明确说不要包进chat_template_kwargs。
同一个坑在 enable_thinking 上重复出现,模型卡两处都提了。我的建议是把这两个参数写进同一份配置注释里,别让它们分散在两个模块。
自托管这边,把服务端默认值显式化,比依赖“默认开启”更安全:
|
|
--kv-cache-dtype fp8 把上面那 64 KiB 砍成 32 KiB,代价是质量影响得自己测——文档没说可以无损,我也不打算替它背书。--max-model-len 则是把缓存容量钉死,避免某天一个长会话把整卡吃光。
代码/配置/网关改动,做之前按这份清单过一遍:
- 参数位置对不对:自托管包
chat_template_kwargs,Qwen Cloud 直传 - 请求体里
reasoning_content字段在不在(打印一次就知道) - 同一会话内没有混用“删/不删”
- 中途从别的模型切进来时,历史消息结构有没有被改写(不同厂商对回传要求不同,切模型是高危时刻)
-
reasoning_effort没有被当成纯粹的省钱旋钮
聊到这儿,把话收回来一点。这篇的适用范围是多轮、带工具调用的 agent 场景。单轮问答、把思考对终端用户完全隐藏的客服机器人、纯离线的批处理评测——这几类保留思考没有收益,只是多付输入 token,缓存本来也不命中,关掉干脆。
还有一个二手说法我保留态度:有报告称长会话里窗口被旧计划占满后,会出现“看起来无关的空输出”。这是别人的描述,我没复现过,写在这儿只是提醒你留意这个失败形态,别当结论。
真正该做的一件事,是去看一眼你自己的请求体。跑一次,打印 messages 里每条 assistant 消息的字段名,看 reasoning_content 到底在不在、有多长。这个数字比任何估算都准——它是你这套系统里,思考到底占了多少上下文的第一手答案。
拿到这个比例之后,再决定你的探索轮要不要回传。剩下的,交给监控。