上周有个团队在群里发账单截图:他们把分类和抽取两条流水线切到新出的 Haiku 5.5,单价表看下来省了九成,结果月度账单只降了两成。他们没做错什么,只是那条「省 90%」的规则,前提是你的单条请求不超过 10 万 token。
Haiku 5.5(model id claude-haiku-5-5)是 2026-10-07 发布的小模型。官方定价页写得很清楚:≤100,000 token 的请求,input $0.10 / output $0.50 每 MTok;越过 100,000,全部单价×5,变成 $0.50 / $2.50。注意「全部」两个字——不是阶梯计价,不是只有超出部分涨价,是整条请求按同一档结算。
这篇文章不谈它跑分多强,只解决一件事:在你把生产流量的默认模型换过去之前,怎么量出你自己那条最长请求落在 100K 哪一侧,以及量出来之后要动什么。
便宜是按「单条请求多长」定价的,不是按 token 单价
先看这张图。左边是 100,000 token 的请求,右边是 100,001 token 的请求——只差一个 token。
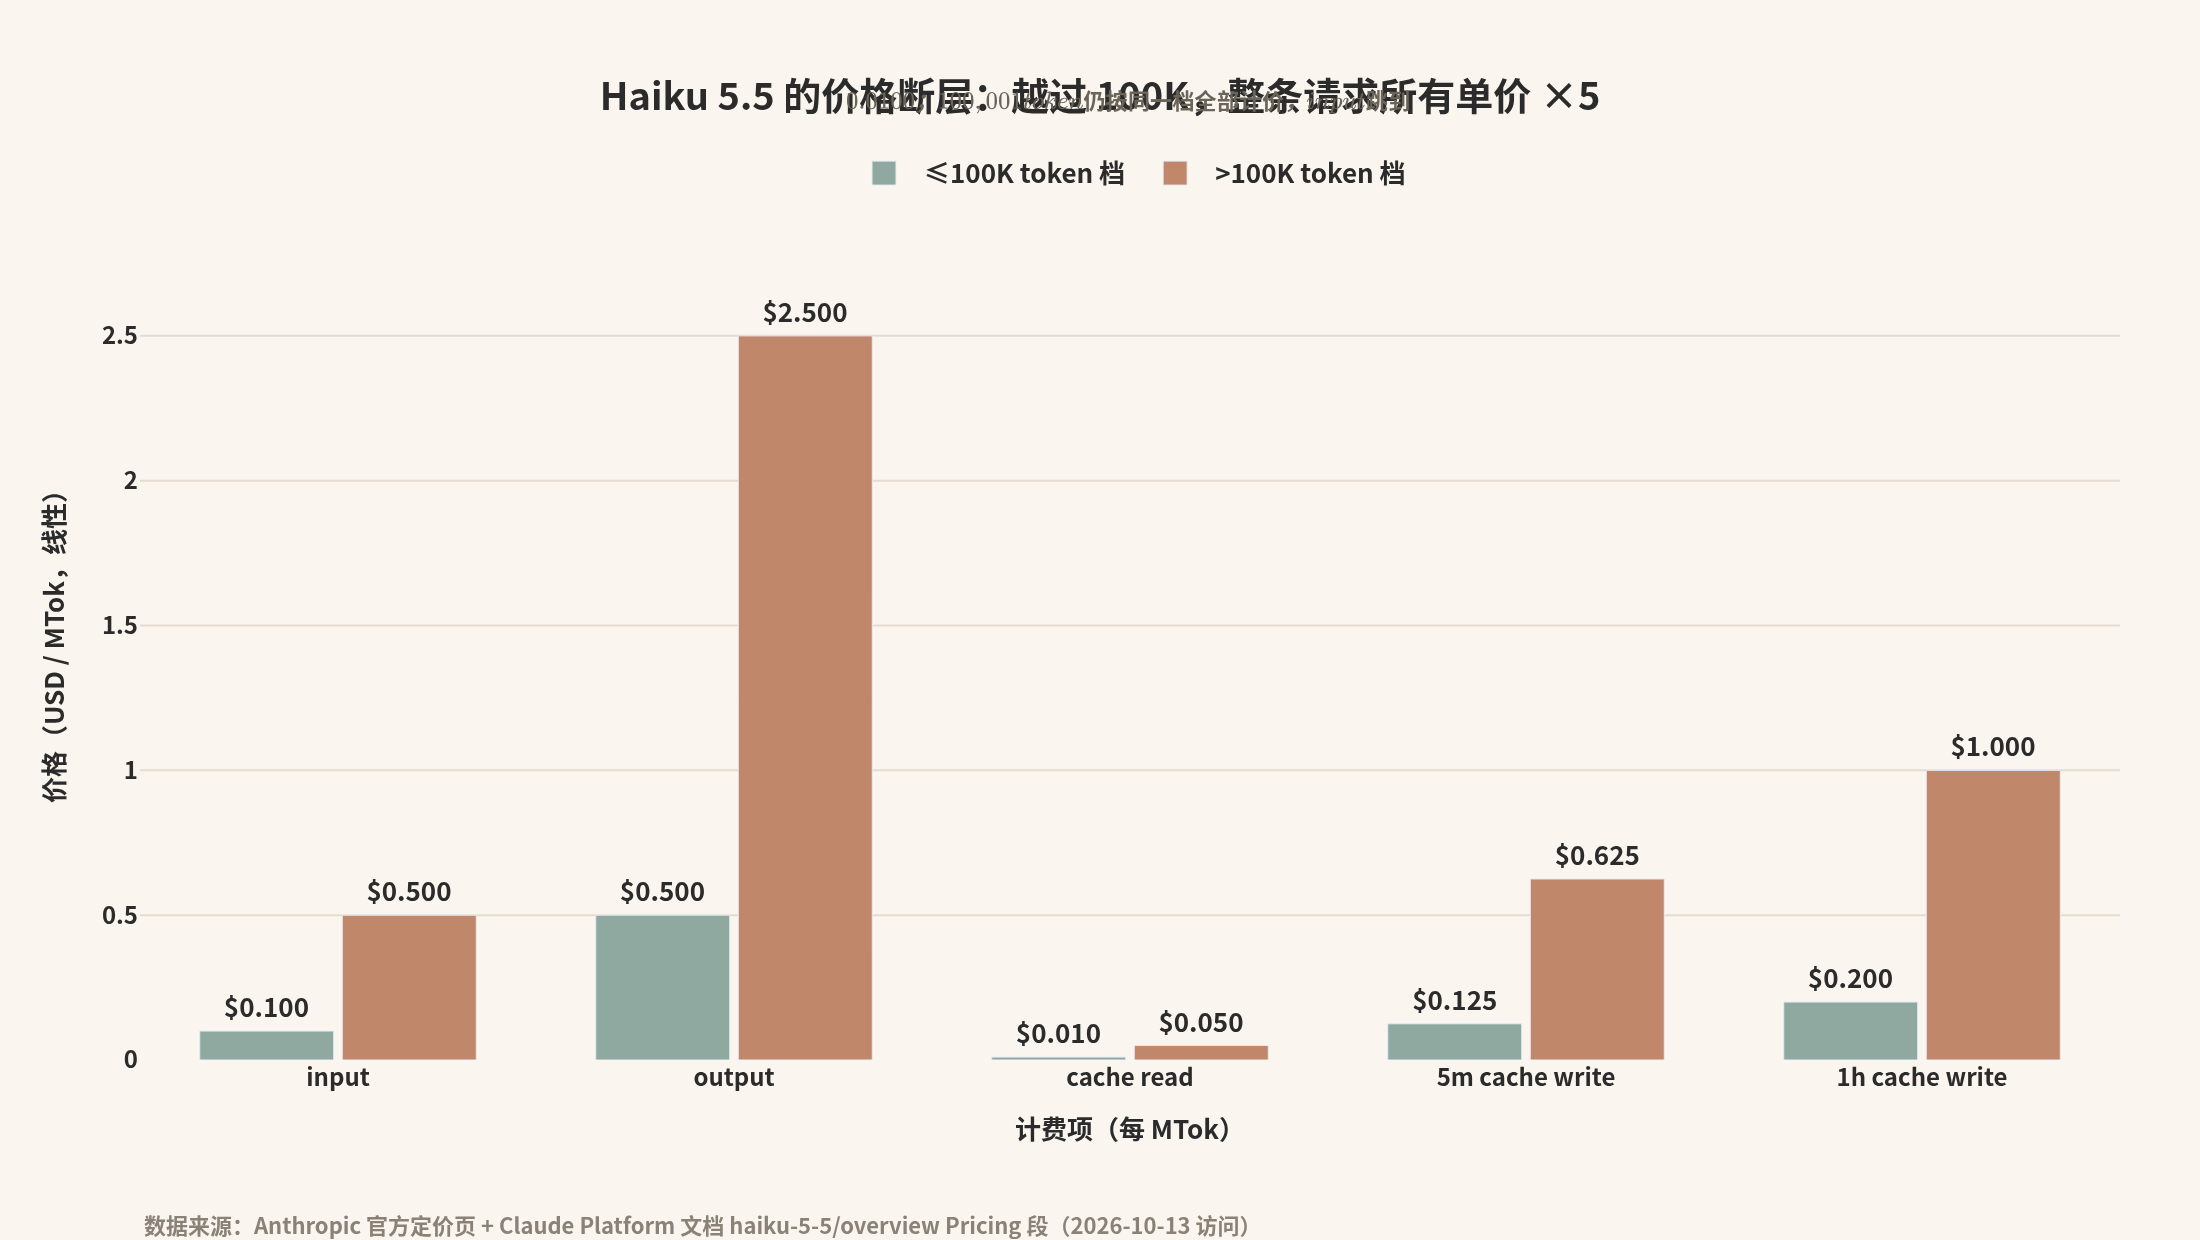
图源:据 Anthropic 官方定价页与 Claude Platform 文档 haiku-5-5/overview 的 Pricing 段数据自绘,2026-10-13 访问。
两档的完整价目是这样(每 MTok,单位美元):
- ≤100K 档:input $0.10、output $0.50、cache read $0.01、5m cache write $0.125、1h cache write $0.20
- >100K 档:input $0.50、output $2.50、cache read $0.05、5m cache write $0.625、1h cache write $1.00
- Batch API 在两档都给 50% 折扣
算一遍就明白那条线为什么重要。100,000 token 的 input 花 $0.0100;100,001 token 花 $0.0500。多一个 token,input 账单跳 5 倍,output 也同步跳 5 倍。
便宜是按「单条请求有多长」定价的,不是按 token 单价。定价表上写的 $0.10,是一条带条件的价格。
还有一个容易被忽略的事实:Haiku 5.5 是当前 Claude 家族里唯一按 prompt 长度分档的模型。官方定价页明确写着,Claude 4.6 及之后的其他模型(Haiku 5.5 除外)与 Claude Mythos Preview,整个 1M 上下文窗口都按标准价计费,没有这道断层。也就是说,你从别的 Claude 模型迁过来时,不会带着「越线涨价」的肌肉记忆——这正是踩坑的地方。
这一节的结论:别再把 Haiku 5.5 当成「单价 $0.10 的模型」,把它当成「单价 $0.10 或 $0.50、由单条请求长度决定的模型」。
把你自己最长那条请求,放到新 tokenizer 下重新量一遍
现在有个新问题:你要拿什么数去判断有没有越线?
网上已经有人写了「价格闸门」的代码片段,思路是估算 token 数、超阈值就换模型——但那些实现有个共同的洞:token 数常常是手填的,或者用旧模型量出来的。而 Haiku 5.5 换了 tokenizer。
官方迁移指南(whats-new-haiku-5-5)里有一句原话:同样的输入文本在 Haiku 5.5 上产生的 token 数约为 Haiku 4.5 的 1.30 倍,官方同时注明「实际增幅取决于内容」。第三方在 2026-10-08 做过一次独立测量,取 6 类文件各 2 万字符,得到的比值在 1.11x(JSON)到 1.36x(英文散文、YAML) 之间,代码文件约 1.29–1.35x。
把这两个数字叠起来看:在 Haiku 4.5 上量着 80,000 token 的 prompt,换到 Haiku 5.5 上大约就是 104,000 token——你一个字都没改,就已经越线了。 粗算一下危险区:旧 tokenizer 下大约 77,000 到 100,000 token 的 prompt,都属于「可能被推到线外」的范围。
所以要做的第一件事是量,而且要用对方法和素材:
第一步,用官方的 count_tokens 端点。 它免费、只返回计数不产生推理费用,返回体里的 input_tokens 就是这条请求会走哪个价档的依据:
|
|
第二步,用你日志里真实的 prompt,不要用一条测试句。 因为增幅随内容变(JSON 只涨 11%,英文散文涨 36%),拿一句「Hello world」测出来的比值对你的业务毫无意义。从线上日志里捞 10–20 条最长的真实请求,逐条量。
第三步,同一段文本在两个 model id 下各量一次,取比值。 这才是你自己的真实增幅,比官方那个「约 30%」更贴你的负载:
|
|
(count_tokens 这里指代上一步那个 curl 的封装函数,你可以直接用官方 SDK 的 client.messages.countTokens()。)
量完你会拿到两样东西:你自己的 token 增幅倍数,以及在 Haiku 5.5 视角下你最长请求的实际 token 数。拿这个数去对 100,000 这条线。
这一节的结论:闸门的输入不是猜的,是量的。而量必须在新 tokenizer、用真实日志、取你自己的比值——三件事少一件,闸门就是假的。
缓存很便宜,但它可能正把你的请求推进高价档
缓存是这里最有迷惑性的一层。Haiku 5.5 的 cache read 是 $0.01/MTok,只有 input 的十分之一。看起来缓存前缀越长越划算。
但如果决定档位的是整条请求的全部输入 token,包括从缓存读到的和写进缓存的,那么一个「95,000 token 的缓存前缀 + 6,000 token 的新问题」= 101,000 token 的 prompt,即使绝大部分是缓存命中、只花 $0.01 那一档的钱,它依然整条按 >100K 的高价档结算。缓存省了单价,却没能把你留在线下。
这里我必须把话说清楚:这一条的证据状态不如前面几条硬。 有分析文章转述 Anthropic 的长上下文定价说明,称规则是「按整条请求的输入判定档位,缓存命中和写回的 token 也算,且每条请求独立计价、已按低档结算的请求不会事后重算」。但 Anthropic 官方的定价页和上下文窗口文档里,没有逐字写出「缓存 token 计入档位判定」这句话——官方只写了「缓存 token 计入 context window」。也有第三方明确表示在官方文档里找不到这个表述,因此不作判断。
所以别把它当成已确认的定价规则,而是当成一条必须自己验证的假设:
- 发一条真实请求,读响应里的
usage对象,看三个字段:input_tokens、cache_read_input_tokens、cache_creation_input_tokens - 把这三个数加起来,看它是不是决定档位的总量
- 对齐账单行项,确认这条请求落在哪一档
跑通一次,你就有答案了,不用信任何人的转述。这也顺便解释了一个反直觉点:Haiku 的缓存便宜,是因为它的 input 本来就便宜($0.01 是 $0.10 的十分之一),不是缓存折扣力度更大。 对比之下 Opus 5.5 / Sonnet 5.5 的 cache read 是 input 的 5%。换句话说,Haiku 便宜的根子还是那条 100K 分界线。
顺带一个对照:Sonnet 5.5 同期把 cache read 从 $0.20 降到了 $0.10。如果你有些请求注定要越线、又必须用大模型兜,那部分成本模型要一起重算。
这一节的结论:缓存前缀能降单价,但可能不降档位。上线前用 usage 三字段跑一次真实请求,把这条假设变成你账上的事实。
把 effort 当成本旋钮,而不是「越高越好」
第三个隐藏变量是 effort。Haiku 5.5 是第一个带这个参数的 Haiku,支持 low / medium / high / xhigh / max,而且 API 和 Claude Code 的默认值都是 medium。
同时,adaptive thinking 默认开启,thinking token 按 output 计费,还占用 max_tokens 配额。output 在低价档是 $0.50、高价档是 $2.50——thinking 开着的长推理任务,成本会从你看不见的地方涨起来。
几个可操作的分档动作:
- 分类、抽取、路由、压缩这类判定任务 → 用
low,成本与延迟都最低 - 短、固定格式的输出任务 → 可以关 thinking:
thinking: {"type": "disabled"},但注意这个参数只在high及以下 effort 有效,xhigh/max传了会直接返回 400 - agentic coding 这类长程任务 → 官方自己的建议是留在 Sonnet 5.5 / Opus 5.5,别为了省钱硬压到 Haiku
关于「高 effort 是不是更好」,有一条第三方证据值得看,但必须限定范围:computingforgeeks 在 2026-10-08 做了一次独立测试,8 个 Python 任务、用隐藏 assert 判分——Haiku 4.5 得 4/8;Haiku 5.5 在 low / medium / high 三档都拿到 8/8,成本从 $0.0034 到 $0.0056 差异不大;而 max 反而只拿到 7/8,耗时 538 秒(是 high 的 11 倍以上),成本 $0.0664——比 Haiku 4.5 还贵,其中一个任务烧完 32,000 output token 却没写出代码。
这是一次 8 题的小样本实验,不能说成「max effort 总是更差」。它能支持的结论是:高 effort 不保证更高正确率,但成本非线性上升。 另一侧的证据是官方的:官方公布的 benchmark 高分(GDPval-AA 1620、OSWorld 72.4%、Terminal-Bench 39.2%)全部是在 max effort 下取得的,同一来源指出同模型在 medium effort 下 GDPval-AA 掉到 1277。也就是说官方用最高成本换来了最高分,而你要判断的是「为你的任务多花那份钱,值不值」。
这一节的结论:effort 和 thinking 是两个没写进单价表的成本项,默认值(medium + thinking 开)是偏贵的一端,按任务类型往下调,往往比换模型省得多。
什么时候不该切过去
把前面三件事拧成一条可执行的路径,就是这样:量最长请求(新 tokenizer)→ 判断 ≤100K?→ 按任务定 effort → 越线就压缩前缀或改走 Sonnet 5.5。
但有几个场景,答案是不该切:
长文档摘要省不了多少。 15 万 token 的文档本来就落在高价档,第三方按 1.3x token 重算的例子是:这类任务成本只从 $155.00 降到 $100.75,约 35%,远不是标题上的 75%。而且那个 75% 本身是 Anthropic 对真实流量加权的平均宣称值——官方脚注写的是「Haiku 4.5 上 90% 的请求落在 ≤100K」,并已扣掉 tokenizer 带来的额外 token。它不是你的工作量。
要记住「请求级」三个字。 档位判定不是按会话累计,是按单条最大请求。Agent 每轮都要重发上下文,会在长任务跑到中途的某一轮突然越线,之后每轮的 input(含缓存命中)全部×5。你测的应该是「单轮最大请求」,不是「会话总共发了多少」。
内存/知识密集任务不是它的强项。 Artificial Analysis 的独立测试里,Haiku 5.5 的 AA-Omniscience 是 36%,低于 Gemini 3.8 Flash 的 55% 和 GPT-6 Luna 的 44%。省钱的前提是它能一次做对,做不对要重试的话,「便宜但要重试的调用不便宜」。
还有几个迁移期的硬坑:需要 temperature / top_p / top_k 的代码会收到 400;assistant prefill 返回错误;Priority Tier 不支持 Haiku 5.5。另外 Haiku 4.5 的退役下限已经不早于 2026-10-15,继续跑旧模型等于没有明确的跑道——这也决定了你早晚要迁,问题只是这次迁移前量不量。
三个 grep:旧 token 数、你的新比值、usage 里的三个字段
不用重写架构,先做这三件:
- 从线上日志捞 10 条最长请求,用
count_tokens在claude-haiku-5-5和claude-haiku-4-5两个 model id 下各量一次,算出你自己的 token 增幅倍数和你最长请求的新 token 数。 - 对着 100,000 这条线看结果。超过、或落在 77K–100K 的危险区,就先别切,或者把缓存前缀裁到线下留出余量。
- 发一条真实请求,读
usage里的input_tokens/cache_read_input_tokens/cache_creation_input_tokens,和账单行项对齐——验证「缓存 token 是否计入档位」这条至今没有官方逐字确认的假设。
三件事加起来不到一小时,但它决定你那笔「省 75%」的账到底是省的还是赔的。差不多对应着三个 grep:旧的 token 数、你的新比值、以及 usage 里的那三个字段。