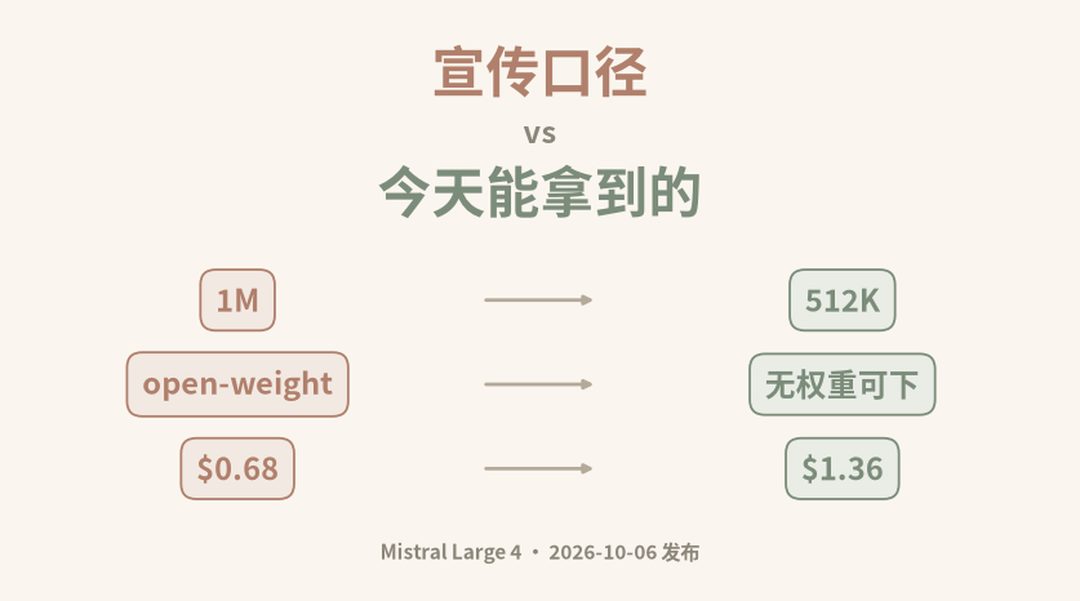
10 月 6 日 Mistral 发了新旗舰 Large 4,内部昵称 le Chonk。发布页的卖点很整齐:开放权重、1 万亿参数、1M 上下文、“显著超越欧美所有开源模型”。如果你正在维护一个跑在现有模型上的 agent 或代码助手,看完的第一反应大概是——既便宜又强,是不是该换了。
先别动。这篇把官方口径和你今天实际能拿到的东西之间的四处落差摊开:上下文是 512K 不是 1M、预览期没有权重可下、价格有两张脸、跑分漂亮不等于能塞进 agent 循环。适用对象:正在评估是否把 agent / 长文档 RAG 迁到 ML4 的 Golang / 后端 / AI 工程师。
「1M 上下文」是官网自己的两种写法,能调到的那个是 512K
同一家公司的两页文档,给了两个数。Mistral docs 的模型卡上,Context 一栏写的是 1M;而 OpenRouter 的模型页和第三方评测站 Vals AI 的字段都是 524,288(512K),输出上限 262,144。发布博客里的原话是 “frontier performance”,没给 token 数。
这不是笔误级别的分歧——它直接决定你的架构。一个需要把整本技术手册塞进单次请求的 RAG,按 1M 设计就是能过,按 512K 设计就要先做分片;一个多轮 agent 循环,512K 意味着大约跑到一半就得开始考虑压缩历史。
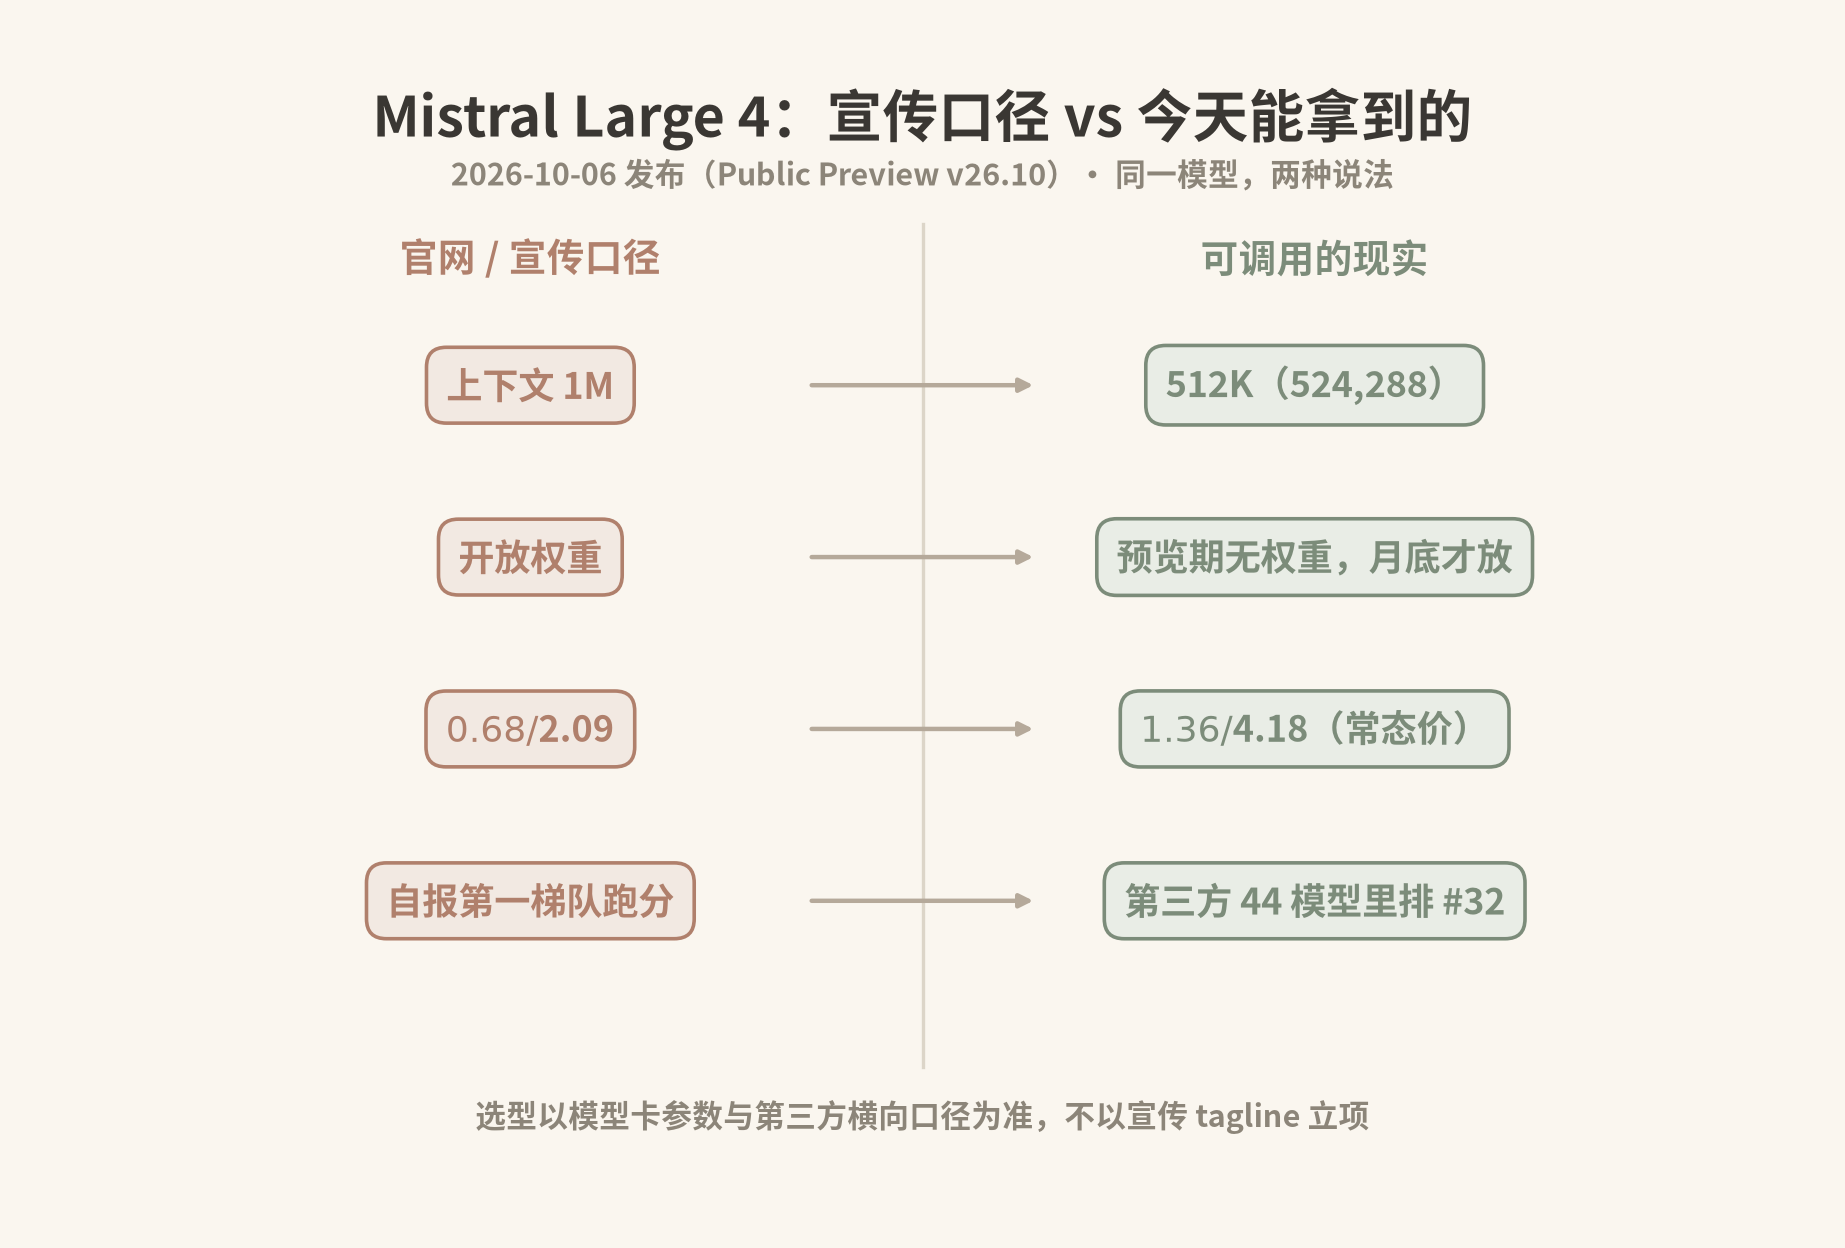 四处落差:上下文 1M 对 512K、开放权重对预览期无权重、折扣价对常态价、自报跑分对第三方横向排名。数据来源:Mistral docs 模型卡、OpenRouter、Vals AI,2026-10-08 访问
按能调用的 API 参数来算,把 ML4 当"1M 上下文模型"立项,是个会中途返工的假设。选型时以模型卡下方的参数、而不是页面顶部的宣传 tagline 为准。
预览期没有可以下载的权重,数据主权团队现在只能等
“Open-weight” 是这场发布最响的词,也是今天最用不上的词。发布博客写得清楚:这是 public preview(v26.10),今天能在 Mistral Studio 上试 API,权重本月底才放(多家媒体引 Reuters 的口径指向 10 月 27 日前后,官方博客只给"月底")。预览期他们还拉着网络安全客户和政府机构做红队测试,给的是降低审核、放开 cyber 能力的同一个模型。
对绝大多数团队,这不是问题:调 API 就行。但如果你的立项理由里有一条是"数据不出内网"“上线前要能在自己机器上跑一遍安全评估”——那这条理由今天不成立,最快也要等到月底,而且要注意的是,权重放出来时架构细节、更多 benchmark 和后训练方法也会一并公布,届时才是真正的验收时点。
OpenRouter 给这个模型的许可标注甚至不是 open-weight,它当前的托管属性是专有的。这不是矛盾,只是提醒一句:“承诺开放权重"和"现在能自部署"是两件事,中间隔着一个月。
价格有两张脸:$1.36/$4.18 是常态,$0.68/$2.09 是折扣价
Mistral docs 的价格栏同时列了两组数——输入 $1.36 / 输出 $4.18 / 缓存读 $0.14(每百万 token),旁边一列是 $0.68 / $2.09 / $0.07。OpenRouter 那边直接标了 “50% off”。
也就是说,打折那一档是限时状态,不是定价。用折扣价立项,等于把一个临时状态写进你的单位成本模型——三个月后折扣结束,你的成本表直接翻倍,而这时候代码已经上线了。
财务上稳妥的做法只有一种:用 $1.36 / $4.18 这一档算上界。举个可核对的例子:某任务每轮输入 40 万 token、输出 2 万 token,按常态价一轮就是 0.4 × 1.36 + 0.02 × 4.18 ≈ $0.63,折后约 $0.32——这个数字是照着官方价目表算的推演,不是实测。差价看着不大,但 agent 循环跑十轮、每天几千次调用,量级就出来了。真要压成本,关键在缓存读($0.14)能不能命中,而不是赌折扣还在不在。
跑分漂亮,但第三方排名和厂商自报差着一个量级
发布页给了六张 benchmark 图,成绩很漂亮:Cybench 93%、Cyber Index 单测 82%、DeepSWE 61.7%。这些都是厂商自报。第三方评测站 Vals AI 把它放进 44 个模型里排,结果是 第 32 名(Quad Index 48.05%);Terminal-Bench 4.0 一项 Vals 记的是 22.73%,20/44,发布页给的是 28.3%。唯一站得住脚的高位是 Harvey 法律 Agent benchmark,第 6/75。
两个数都是真的,只是它们量的不是同一件事。厂商给的是精挑过的单项(它最强的那几项),第三方给的是横向可比的口径。发布页还有一句"显著超越任何美国或欧洲开发的开源权重模型”——按 Vals 的横向排名,这句话在综合口径上很难成立。
真正需要警惕的是接下来的信号。多篇上手报道提到,把 ML4 接进 OpenCode 这类 agent harness 时,推理 token 会跑飞、快速耗干上下文,而且不报错。这是媒体报道和用户反馈,Mistral 官方没确认,所以别当成定论;但它和你本来就要防的风险指向同一处——1T 参数的推理模型,输出里混着大量看不见的思考 token,长循环下最先耗尽的不是钱而是上下文窗口。
迁移前先跑一遍这张四行验收表,再接流量
把上面四处落差收敛成一张能在半天内跑完的清单。任何一项没过,都不要切生产流量。
- 每任务 token 中位数:拿你现有模型跑同一个真实任务集,记录单任务的输入/输出 token 中位数。这是你算成本上界和判断上下文够不够的唯一依据。ML4 的推理 token 藏在输出里,务必按
usage里的 output 数取,不要按界面看到的回答长度估。 - 上下文耗尽率:统计有多少任务的实际用量逼近 512K。超过 20% 的任务顶到上限,说明这个模型不适合你这条链路,换更长的上下文模型或先做历史压缩。
- 工具调用成功率:ML4 支持
tools/tool_choice和response_format的 JSON schema 结构化输出,但结构化输出的合规率要在你的 schema 上实测——尤其在多轮里,一次格式漂移就会让整条流水线返工。 - 缓存命中后的真实单价:缓存读 $0.14 和输入 $1.36 差近十倍,但只有前缀稳定才命中。把你实际的命中率乘进去,算出真实单价,再和现有模型比。
接入本身不难,它是 OpenAI 兼容口径:换 base URL,模型 slug 用 mistral-large-4-0。但顺手要加三道硬约束,否则高上下文模型的默认行为会让你在账单和上下文两边同时失控——给每次调用设 max_tokens、设请求超时、并在 agent 循环上挂一个 token 熔断(跑到 N 万 token 就中断)。
最后是三类不该切的情况,说在前面:要满足数据主权、坚持本地自部署的——本月不行;单次任务真的需要超过 512K 上下文的——这个模型给不了;日常只是一批低延迟的小请求(分类、抽取、短问答)——1T 的 MoE 在这个场景下不如 Small 系列,为用不上的上下文付溢价不划算。
所以动作很简单:先别改代码,把现在这条 agent 链路的 usage 日志调出来,按验收表第一项算一遍每任务 token 中位数。就这一个数字,能告诉你 ML4 该进选型清单,还是直接划掉。