Anthropic 昨天(9 月 28 日)发布了 Claude Sonnet 5.5:价格不动、官方说快 30%+、多数任务成本低最多 30%。但它同时带了五个会让现有代码直接返回 400 的破坏性变更,外加一个不报错、却让界面"变哑"的响应结构陷阱。跑在 Sonnet 5 上的 agent 和抽取流水线,请先别急着改 model ID——这篇给你一张上线前的排雷清单和 effort 调档的账本。适用对象:在生产环境调用 Claude API、做 coding agent、RAG 或批量 JSON 抽取的后端同学。
同价 ≠ 即插即用:官方 whats-new 页其实是一张迁移工单
发布页看着像跑分喜报,但打开 platform.claude.com 的 migration guide 就会发现,这次发布的重心是一份相当长的 breaking changes 清单。“改一行 model ID 白捡升级"的直觉,在这五处会被 400 invalid_request_error 打回:
thinking:{"type":"disabled"}不再接受。想关前置思考,要改成新的between_tools。而且这个新类型只在 low/medium/high 三档 effort 下可用——xhigh/max 下发between_tools照样 400,得回到 adaptive。- forced tool use 没了。
tool_choice为any或tool一律拒绝,连 token counting 端点都不放过。官方给的替代是auto+ 工具标strict:true(Bedrock 上没有 strict,只能 prompt 约束加代码校验)。靠强制工具调用来保 schema 输出的老代码,这不是改参数,是重构。 - thinking blocks 绑定了。Sonnet 5.5 读不懂 Opus 5 / Opus 5.5 / Fable / Mythos 产生的推理块,跨模型路由时这些块被静默丢弃(好消息:丢掉的块不计费,请求仍返回 200)。更阴的是账号维度:2026 年 8 月 31 日之后创建的账号默认强制 block_binding,回放历史时改动早先消息会直接 400,会话必须 append-only。
- computer use 工具版本换了。Claude API 和 Google Cloud 上
computer_20251124被拒,要迁到computer_toolset_20260801;Bedrock 还收旧版——同一个错误在不同云上的表现不一样,多云部署的要分别回归。 - advisor tool 的配对名单缩了。Opus 4.8/4.7/Sonnet 5 当 advisor 会 400,只剩 Opus 5.x、Sonnet 5.5、Fable/Mythos 5/5.1;而且建议内容加密成
advisor_redacted_result,日志里读不到明文了。
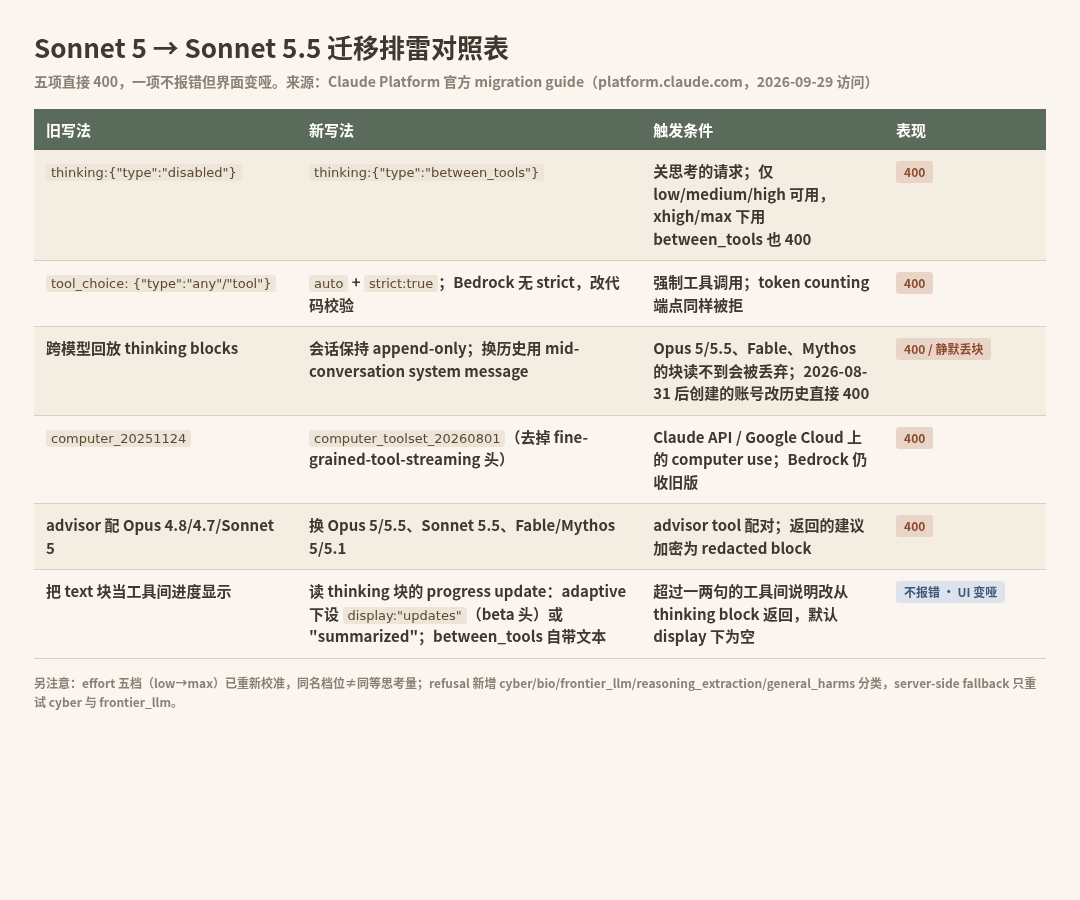 六项变更的旧写法、新写法与触发条件对照。数据来源:Claude Platform 官方 migration guide
一个自查小技巧:把这五个词扔进你的代码库 grep——"disabled"、tool_choice、computer_20251124、advisor、以及所有回放历史消息的路径。命中哪几条,心里就有数了。
最阴的那个坑:不报错,但你的进度文本会变哑
五处 400 反而不是最危险的——报错至少会来找你。真正容易漏网的是这条:工具调用之间的进度文本,从 text 块改到了 thinking 块里返回。
官方的规则是:超过一两句的工具间说明,以 progress-update thinking block 返回,而 Sonnet 5.5 默认的 display 是 omitted——块还在,文本是空的。短的一两句备注仍是 text。于是线上症状非常迷惑:API 全部 200,日志一切正常,token 计费正常,只有用户界面上那些"我正在读取文件…““接下来运行测试…“的中间说明消失了。如果你的 agent 产品把 text 流直接渲染给用户,切流量的当天就会"变哑”,而监控面板上一片绿。
修法两条:adaptive thinking 下设 thinking.display 为 "updates"(beta 头 thinking-display-updates-2026-08-18)或 "summarized",渲染每个非空 thinking 块;或者用 between_tools,它的工具间文本自带返回。另外 refusal 处理也要补——Sonnet 5.5 的拒绝类别比 Sonnet 5 多,stop_reason:"refusal" 带 cyber/bio/frontier_llm/reasoning_extraction/general_harms 五种分类,server-side fallback 只重试其中 cyber 和 frontier_llm 两类。安全审计类负载上线前值得专门压一轮。
这类"成功响应但行为变了"的变更,靠异常捕获是接不住的,只能靠回归用例:写一条断言"多轮工具调用后,用户可见文本非空"的用例,放进 CI,比任何告警都管用。
effort 才是这次的钱包:1/10 成本超过上一代满分是怎么来的
排完雷,才轮到这次更新真正的红利。Sonnet 5.5 有 5 档 effort(low→max),Claude API 默认 high,而且档位经过重新校准——同名档位不等于 Sonnet 5 上的同等思考量,所以官方 migration guide 的建议第一条就是 re-run your effort sweep。
Anthropic 发布页的 accuracy-vs-cost 曲线给了一个很扎眼的结论:多个评测上,Sonnet 5.5 低/中档 effort 的成绩超过 Sonnet 5 的最好成绩,成本约 1/10(CursorBench low effort、Terminal-Bench medium effort、AA-Briefcase medium effort 都是这个句式)。早期测试方 CodeRabbit 的说法可以对上号:Sonnet 5 那种"动不动就 web search、输出 token 巨多"的毛病在新模型上收敛了。注意这是 Anthropic 公布的厂商自测与客户引语,不是独立实测——但方向可信:effort 现在是继"选哪个模型"之后的第二个成本旋钮,而且是先拧它、后换模型的关系。
落地做法是把 A/B 测试自动化,而不是拍脑袋定档:
|
|
红线也画一下:between_tools 与 xhigh/max 互斥(400);between_tools 会话中 effort 不能中途变更;想逐轮变档就用 adaptive thinking。组合约束这些细节,官方文档写得比大多数三方评测清楚。
$7.60 每任务与 410M tokens:独立评测为什么和官宣不打架
社区这两天流传一种说法:“Sonnet 5.5 比 Sonnet 5 贵了 50%"。这个数字有出处,但被张冠李戴了一半。
Artificial Analysis 给 Sonnet 5.5 的独立评测是 Intelligence Index 56 分(max effort、default fallback,仅次于 Opus 5.5 的 58),每任务成本 $7.60;而 Sonnet 5 自家五档的 AA 数据是 $0.51 / $1.00 / $1.79 / $2.87 / $5.09。拿 $5.09 对 $7.60,确实”+49%"——但那是两代模型各自 max effort 的对比。Anthropic 官宣的"便宜最多 30%“说的是默认 effort 下同任务成本。两边测的根本不是同一个开关位置,却都没说谎:新一代在顶格烧钱时更贵(也更聪明,56 对 38),在日常档位上更省。评测里还有个值得警惕的数字:Sonnet 5.5 在整个 Index 上吐了 410M output tokens,同类中位数才 88M——max effort 下的冗长程度可见一斑。
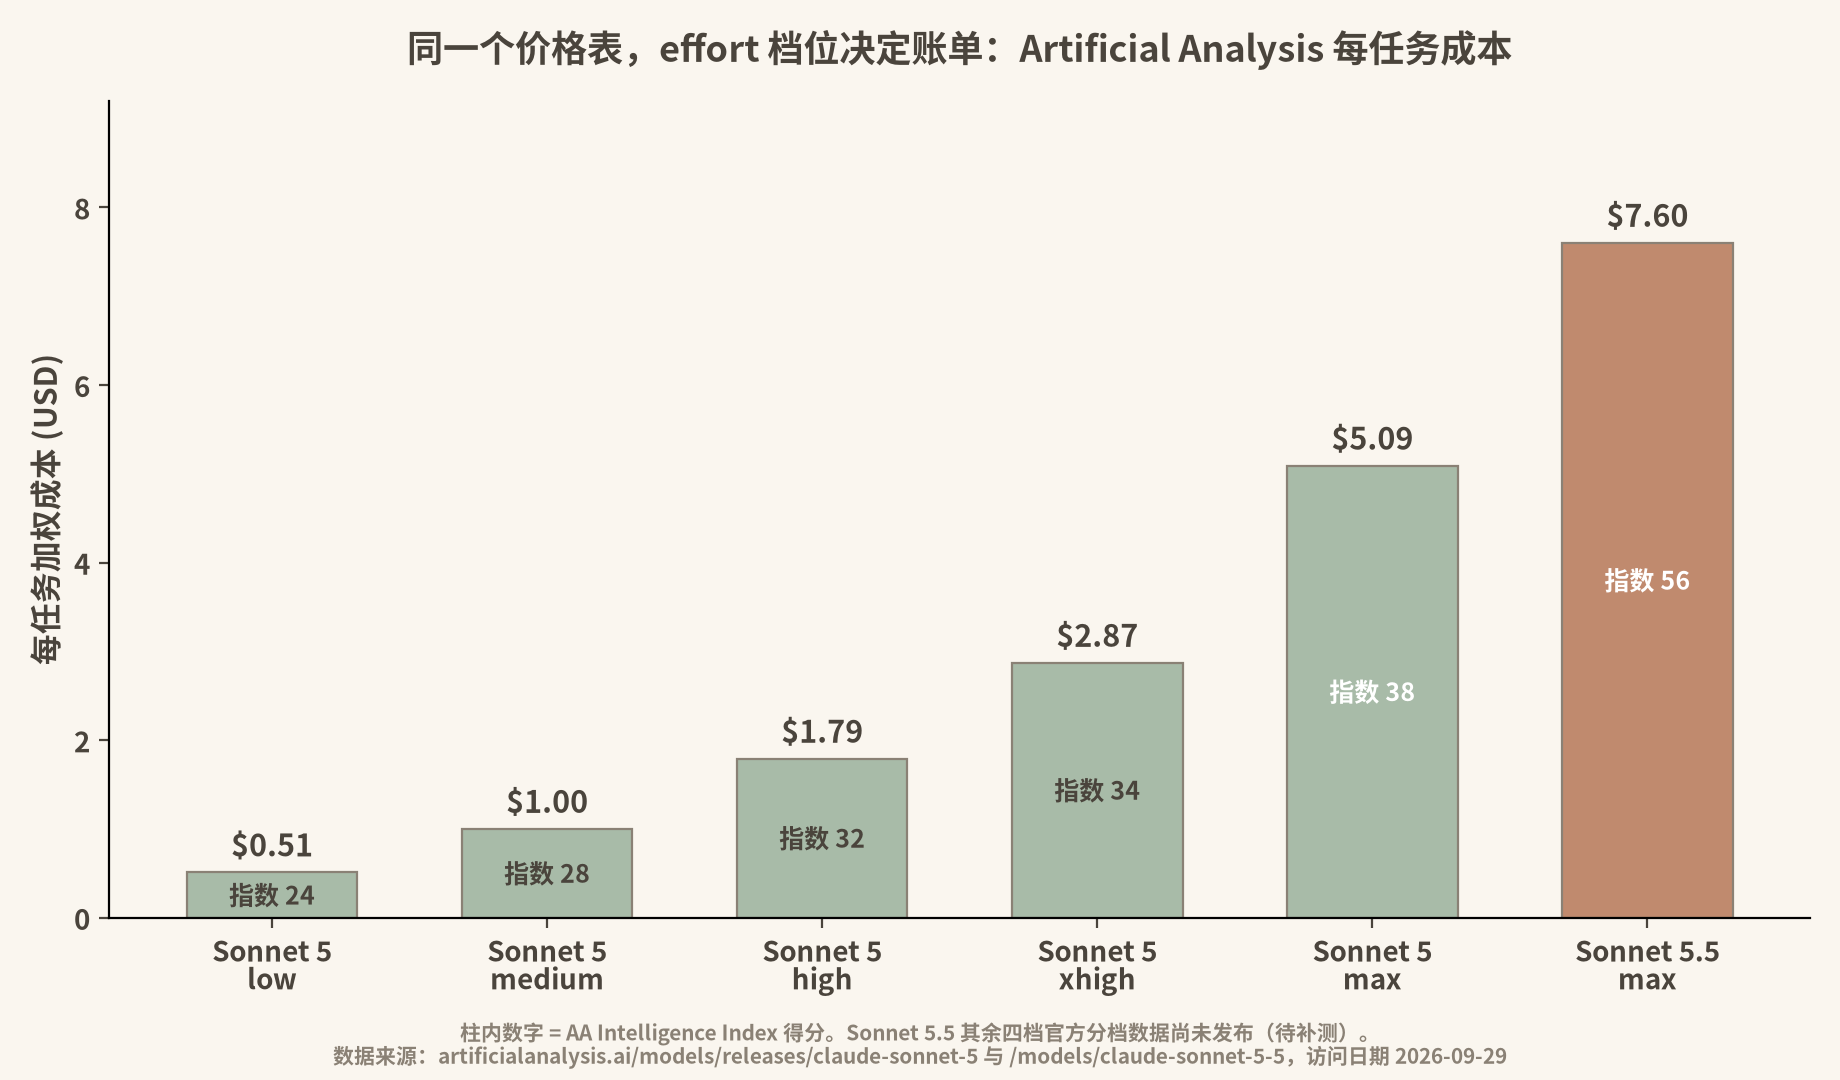 同一价格表下 effort 档位带来的数量级跨度。数据来源:Artificial Analysis 两个模型页,访问日期 2026-09-29
所以读任何模型评测,养成"三看"习惯:看每任务成本而不是单价,看 effort 设置,看有没有开 fallback。顺带一提,Anthropic 自己在脚注里承认 AA 用的预发布部署存在 structured outputs 降质 bug(称已修复)——第三方数字也会带出厂时间戳,这不是谁骗谁的问题,是评测生态的常态。
还有一点容易被沿用旧模板的文章写错:这次 tokenizer 没变,Sonnet 5.5 与 Sonnet 5 完全一致,同一段文本的 token 数不变。三个月前 Sonnet 5 换 tokenizer 涨 30%+ 账单的故事,这次不适用(但如果你从 Sonnet 4.6 及更早直升,那 30% 的账还是要算的)。
切流量之前:grep 五个词、盯一次工具调用、重跑一遍档位
把上面的东西压缩成动作,顺序是这样的:
- grep 五个词:
"type": "disabled"、tool_choice、computer_20251124、advisor 配对、历史回放逻辑。命中的按第一节清单逐条改。 - 盯一次真实的多工具调用:检查响应里工具间的长文本是不是空 thinking 块,是就设
display或切between_tools,并给 CI 加"用户可见文本非空"的断言。 - 重跑 effort 阶梯:先假设 high 太贵,用第二节的流程测 low/medium 能不能保住质量——官方曲线暗示大部分日常负载的答案可能比你预设的低一档。
- 加一条监控:400
invalid_request_error单独分类告警,output tokens/task 做环比——切流量后 24 小时内这两个指标最能暴露问题。
不建议动的场景也说清楚:强依赖 forced tool use 且来不及重构 schema 校验的、跨 Opus 5.x 与 Sonnet 5.5 做会话路由的(thinking 块会被丢)、以及老账号与新账号行为不一致的混合团队——这三类要么等生态稳定,要么先在影子流量里跑一周再说。
单价相同从来不等于成本相同。这次更新真正的杠杆不在 model ID 那一行,而在 effort 旋钮上——先排雷,再调档,最后才谈升级。