上周五你为了省成本,在 agent 里写了一行 thinking: {"type": "disabled"},把模型的思考关掉,只让它调工具。这周一 Opus 5.5 上线,你把 model ID 改成 claude-opus-5-5,跑第一次请求——400 invalid_request_error。
不是变慢,不是变贵,是请求根本发不出去。官方 migration guide 里列了 4 处会直接返回 400 的请求形态,还有 1 处不报任何错、但你的流式进度条会静默变哑。这篇不做跑分搬运,只做一件事:把升级动作从"改模型 ID"改成"审计你自己的调用代码和成本结构",并说清 40% 到底从哪来、哪些工作流吃不到。
适用人群:在 Go/Python/Java 后端里用 Claude API 或 Claude Code 跑 agent 的工程师,尤其是手上已经有一套按 Opus 5 写的请求代码、打算这周升级的人。
先别改 model ID:四个会让请求直接 400 的形态
这四处有个共同点:它们不是"性能退化",是硬失败——只要代码里有,升级当天就会断。而且错误串是分得清的,照着 grep 一遍就能定位。
第一处,关闭思考。 thinking: {"type": "disabled"} 直接 400。同一处还有 thinking: {"type": "enabled", "budget_tokens": N}——手动指定思考预算的写法也不再接受。Opus 5.5 的 thinking 是恒开的,接受的值只有 adaptive 或者干脆省略字段。控制思考深度的唯一旋钮换成了 output_config.effort。
第二处,强制工具调用。 tool_choice: {"type": "any"} 和 tool_choice: {"type": "tool", "name": ...} 都返回 400,错误串写得很直白:tool_choice: type "tool" and "any" are not supported for this model.。如果你习惯用强制 tool_choice 来拿结构化 JSON,这条会命中。替代路径是把 tool_choice 设回 auto,在工具定义里加 strict: true(strict tool use),或者改用 structured outputs,同时在 prompt 里明确写清什么时候该调这个工具——把"强制"从 API 参数挪到指令里。顺带一句:token counting 端点做同样的校验,所以你的预计算 token 那一步也会一起挂。
第三处,编辑历史后重放 thinking 块。 thinking 块现在绑模型也绑会话。Opus 5.5 能读 Opus 5 及更早的 Opus/Sonnet/Haiku 块,读不了 Fable/Mythos 的;反过来,在 Claude API 上只有 Fable 5.1 / Mythos 5.1 能读它的块。更需要注意的是账号时间线:2026-08-31 00:00 UTC 及之后创建的账号,如果 system prompt、tools 或更早的消息被改动过、又重放了 thinking 块,默认返回 400。如果你做的是"多轮里改一句 system prompt 再继续"的批处理,这基本必中。绕过方式是用 thinking-binding-controls-2026-08-01 beta 头配合 prefix_mismatch_behavior: "drop_block",把不匹配的块丢掉而不是报错。
第四处,旧版 computer use 工具。 computer_20251124 在 Claude API 和 Google Cloud 上被拒,得声明 computer_toolset_20260801 工具集。但 Amazon Bedrock 上旧工具仍然可用——这类平台差异后面还会再出现一次,别用一套配置打天下。
四处 400 的共同修法是同一个动作:把请求形态和模型解耦。别把控制逻辑藏在 API 参数里,参数会被版本改掉,指令不会。
工具调用之间的那行旁白不见了,而这次不会报错
四处 400 好歹会炸给你看。真正该优先排查的是第五处,因为它不报错。
Opus 5.5 把工具调用之间的旁白文本,从 text 块挪进了 progress-update 的 thinking 块。而 thinking 块默认 display: "omitted"——这时候它的文本是空的。结果就是:你的 agent 逻辑一切正常,工具照调,但流式进度 UI 上那句"正在查数据库……“没了,前端静默变哑。日志里没有任何异常,只有用户体验悄悄掉一档。
修法是把 display 显式设成 "updates" 或 "summarized"。这个改动很小,但它暴露了一个容易被忽略的区分:400 是开发期就能发现的错误,静默失效是上线后靠用户反馈才能发现的错误。升级前先跑一遍完整的工具调用循环、盯着流式输出看,比盯着错误日志有用。
顺带说一个连带的写法变化。既然 thinking 块现在绑会话、改历史就报错,那"在历史中间插一句话"的会话操作要改成 append-only:需要中途改指令时,走 mid-conversation system messages,而不是回头编辑早先的消息。以及读响应时别再按位置取块——content[0] 这种写法在块类型会变的模型上迟早出问题,按 type 字段挑。
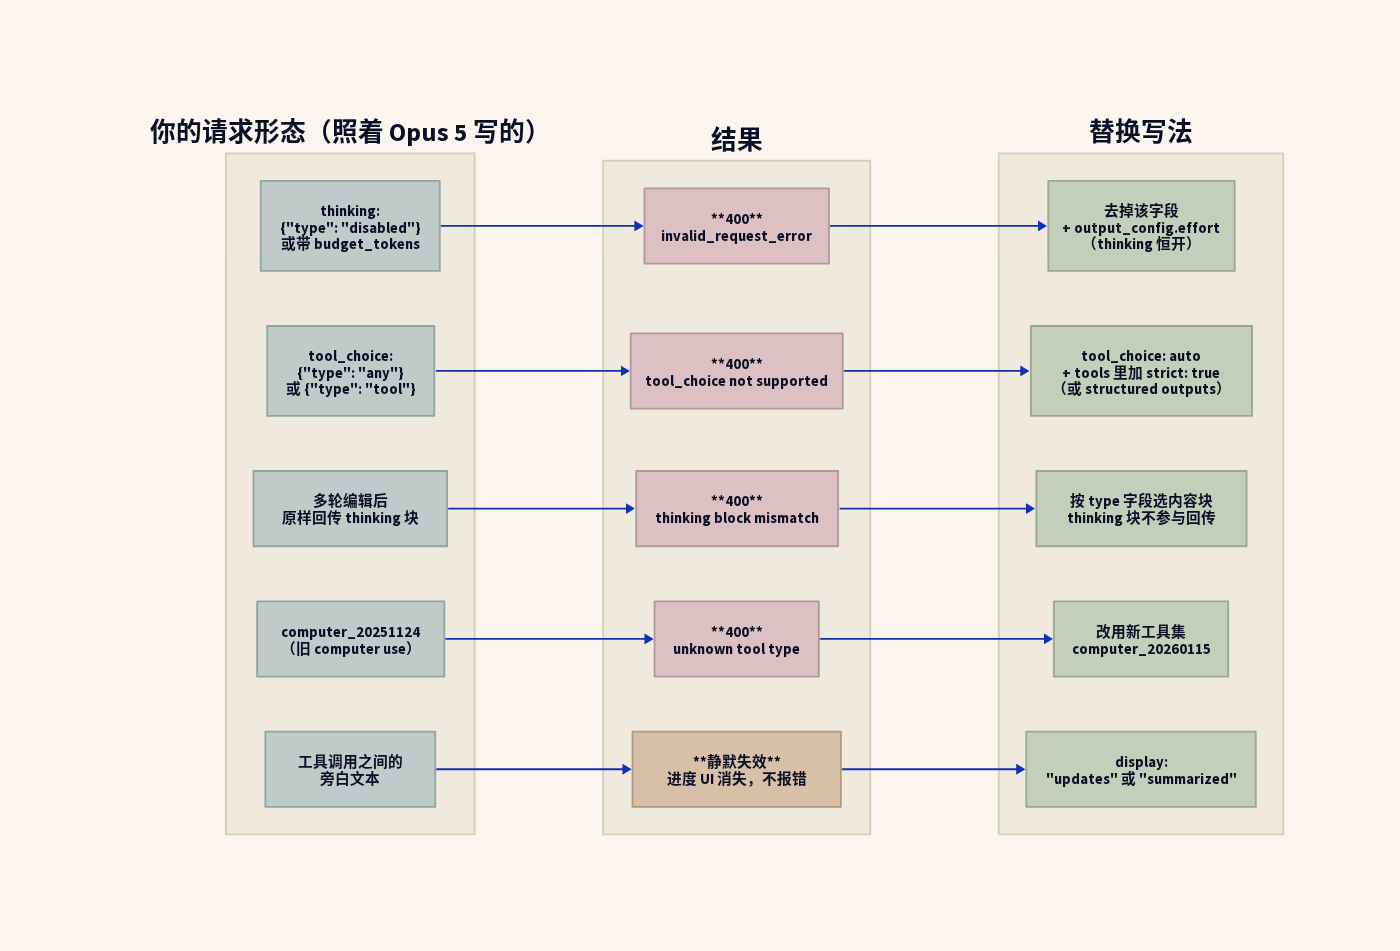
上面这张图把这一节和上一节的内容压成了一张对照表:左边是你照着 Opus 5 写的请求形态,中间是它在 Opus 5.5 上的结果,右边是替换写法。前三行是 400,第四行是平台差异,第五行不报错——只有第五行需要你跑起来才知道。
40% 不是价目表上的数字:缓存读取才是账单大头
说完成本之外的部分,回来说钱。官方发布页上写的是"default settings 下 typical workloads 便宜 40%",但同一页也写着 input/output 降 20%。这两个数字对不上,差在哪?
先把价目表摆出来。Opus 5.5 是 $4 / $20 per MTok(Opus 5 是 $5 / $25),这是 20% 的来源。真正的变化在缓存:cache read 从 Opus 5 的 $0.50 降到 $0.20,降幅 60%,相当于 base input 的 0.05x——而此前各代 Opus 一直是 0.1x。cache write 也降了,5 分钟写入 $5(原 $6.25),1 小时写入 $8。Batch 是 $2/$10,Fast mode $8/$40 且只在 Claude API 和 Claude Code 上有。
40% 的构成,官方没有拆分。官方给出的两句话是"cache reads 占 agentic 与 coding 成本的大部分”,以及"Opus 5.5 每任务用更少 token"。把这两句和上面的乘数放在一起,可以做一个合理推断:综合降幅 = 缓存读取单价腰斩 + 每任务 token 变少,纯单价只解释 20%。这个推断是我的,不是官方口径,写出来是为了让你知道该往哪算,而不是让你引用一个数字。
算给你看。假设一个 agent 会话一天用掉 20M 缓存读取 token、200K 新输入、200K 缓存写入(5 分钟档)、150K 输出:
- Opus 5:20M × $0.50/MTok = $10.00,加 200K × $5 = $1.00,加 200K × $6.25 = $1.25,加 150K × $25 = $3.75,合计 $16.00
- Opus 5.5:20M × $0.20 = $4.00,加 200K × $4 = $0.80,加 200K × $5 = $1.00,加 150K × $20 = $3.00,合计 $8.80
同 token 量下约省 45%——注意这是按官方价目表的推演示例,不是实测,你的实际比例取决于缓存读取占比。
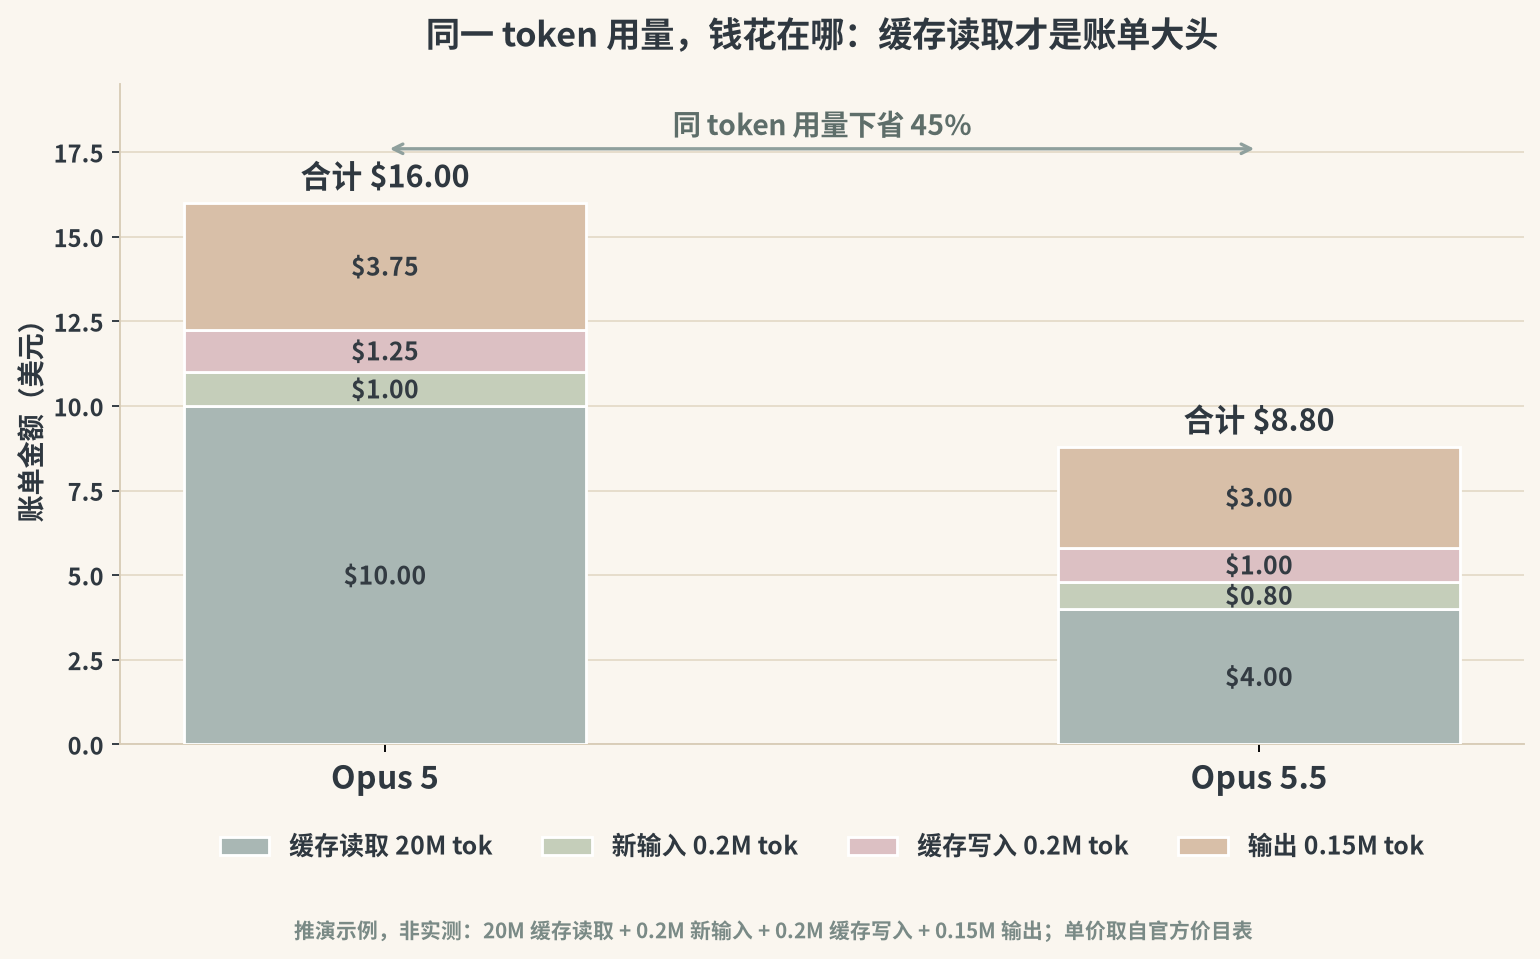
两根柱子的总高度是账单,四段是构成。最下面那段(缓存读取)在两根柱子里的占比都接近三分之二,而它的单价降了 60%——这就是 20% 的单价降幅能变成 45% 的原因。反过来看,如果你账单里最下面那段很短,那这次升级对你就是 20%,跑不掉。
这里就是关键判断:缓存读取占比越高,你离 40% 越近;越低,你就只吃到 20%。 纯 chat、没有缓存复用的工作流,拿到的就是价目表上那 20%。而 agent 场景之所以能吃到更多,是因为系统提示词、工具定义、长历史这些前缀在每轮都被重复读取——它们越稳定,命中率越高。
反过来说,如果你现在的 agent 每次都把变化的上下文塞进前缀(比如把时间戳、随机 ID、用户输入拼在 system prompt 前面),那缓存命中率本来就低,换模型省不了多少。官方定价页给的一个参照是:5 分钟缓存写入在 1 次读取后回本,1 小时写入在 2 次读取后回本——这是判断"该不该开缓存"的硬口径。
这次降价最值得做的动作,不是换模型 ID,是查一眼自己的缓存命中率。命中率低的话,重构 prompt 结构的收益比升级模型大。
默认 effort 掉了一档,而拉满不必然更好:重跑你的扫描
最后一处变化最容易被漏掉,因为它不改代码也能跑。
Opus 5.5 的默认 effort 从 high 变成了 medium,而且同样 effort 下每轮思考更多(官方说这个现象在 xhigh 和 max 档最明显)。两件事叠起来,意味着你的账单和延迟都会变——如果你从来没在代码里显式设过 effort,那这次升级等于静默给你降了一档。这可能让你更便宜,也可能让你的任务质量不达标,取决于你原来靠什么达标。
官方 migration guide 的第一条建议就是"Re-run your effort sweep"。为什么?因为官方自己的数据也不支持"拉满更好"这个直觉。FrontierCode v1.1 main 上,默认 medium 跑出 54.6%,而表里 max 档读数是 54.4%——medium 反超。Terminal-Bench 4.0 那个 66.4% 是 xhigh 档跑出来的,max 反而略低。CursorBench 4.0 的曲线倒是正常(medium 52.5% 到 max 57.8%)。
厂商自测数据得打折看,而且官方自己在同一页写着"benchmark margins have become a less reliable guide to real-world differences",Terminal-Bench 的标准误是 ±2.6 分——意味着上面那些零点几个百分点的差距根本在噪声里。所以这几行数据的正确用法不是"选 medium",而是:这个级别的跑分已经不足以指导选型,你得用自己的任务集重跑一遍。
具体怎么跑:从你线上真实任务里抽 20–30 条,覆盖你依赖的能力(工具调用、长上下文检索、结构化输出、代码编辑),把 effort 设成 low / medium / high / xhigh 各跑一遍,同时记 token 消耗和耗时,然后在"质量达标的最低档"上定住。这样定出来的档位才是你的,不是厂商表格里的。
升级的正确终点不是抄一张跑分表,是在自己的任务集上重新定档。默认值变了,等于你的成本曲线被人悄悄调了参数。
grep 五个词、盯一次工具调用、拆上个月账单
第一件,花十分钟 grep 一遍代码,把会 400 的形态清掉。搜这几个词:thinking、budget_tokens、tool_choice、computer_20251124、以及按位置取内容块的 content[0]。命中 {"type": "disabled"} 或 {"type": "any"} / {"type": "tool" 的,按前面写的替换写法改。
第二件,跑一次完整的工具调用循环,盯流式输出。看工具调用之间那行旁白还在不在。不在就把 display 设成 "updates" 或 "summarized"。
第三件,把上个月账单里的 token 构成拉出来,算一下缓存读取占多少。占比高的,这次升级你能拿到接近 40%;占比低的,先改 prompt 结构——把稳定前缀(system prompt、工具定义、固定指令)和不稳定的动态内容彻底分开,让前缀能命中缓存,再谈升级。
至于升级本身的账,有两点得说全。一是平台差异:旧版 computer_20251124 在 Bedrock 上还能用,Fast mode 只在 Claude API 和 Claude Code 上有,Bedrock / Google Cloud / Foundry 上都没有——同一份代码在不同平台的行为不一样,别按一套配置推。二是安全侧的改派:官方称多数网络安全任务会被改派到 Opus 4.8,生物学与前沿 LLM 开发任务改派到 Opus 5,而且新增了 reasoning_extraction 拒绝类别、服务端 fallback 不会重试这个类别。做这几个方向的团队,升级之后实际拿到的是降级——这条值得在升级前先确认一遍。
文中数字的出处
- Claude Opus 5.5 新特性与破坏性变更(4 处 400、thinking 绑定规则、computer use 工具集变更):https://platform.claude.com/docs/en/models/opus-5-5/whats-new-opus-5-5 ,访问日期 2026-09-23
- 迁移指南(默认 effort high→medium、Re-run your effort sweep、前缀不匹配行为):https://platform.claude.com/docs/en/models/opus-5-5/migration-guide ,访问日期 2026-09-23
- 官方发布页(价格、40% 口径、FrontierCode / Terminal-Bench / CursorBench 数据、安全任务改派):https://www.anthropic.com/claude-opus-5-5 ,访问日期 2026-09-23
- 定价页(缓存乘数、5 分钟与 1 小时缓存写入回本口径):https://platform.claude.com/docs/en/about-claude/pricing ,访问日期 2026-09-23
- 模型概览($4/$20 per MTok、Batch 与 Fast mode 价格):https://platform.claude.com/docs/en/models/opus-5-5/overview ,访问日期 2026-09-23
文中 $16.00 与 $8.80 的对比为按官方价目表与假设 token 用量(20M 缓存读取 / 200K 新输入 / 200K 缓存写入 / 150K 输出)的推演示例,非实测;“40% 主要来自缓存与每任务 token 更少"属基于官方表述与价格乘数的推断,官方未拆分该数字的构成。