如果你线上写的是 deepseek-v4-flash,你的代码一行没改,但请求返回的已经不是那个模型了。
DeepSeek 在 9 月 9 日到 11 日之间三次改动模型名映射与 V4-Pro 的下线计划,最后一次直接把下线撤回了。这期间 V4-Flash 和 V4-Flash-Vision-Exp 两个模型已经下线,旧名字被"出于兼容考虑"路由到新模型——服务端行为,客户端不会报错。
这篇文章不聊跑分。它给你一份调用层审计清单,让你今天就能查清自己受影响没有;再讲清这次 KV 压缩到底让哪类 Agent 负载真的划算。适合已经在生产里调 DeepSeek API、或者正在评估要不要自建的 Go/Python 后端工程师。
deepseek-v4-flash 现在返回的不是它自己了
先把映射关系摆平,这是全文的行动起点。
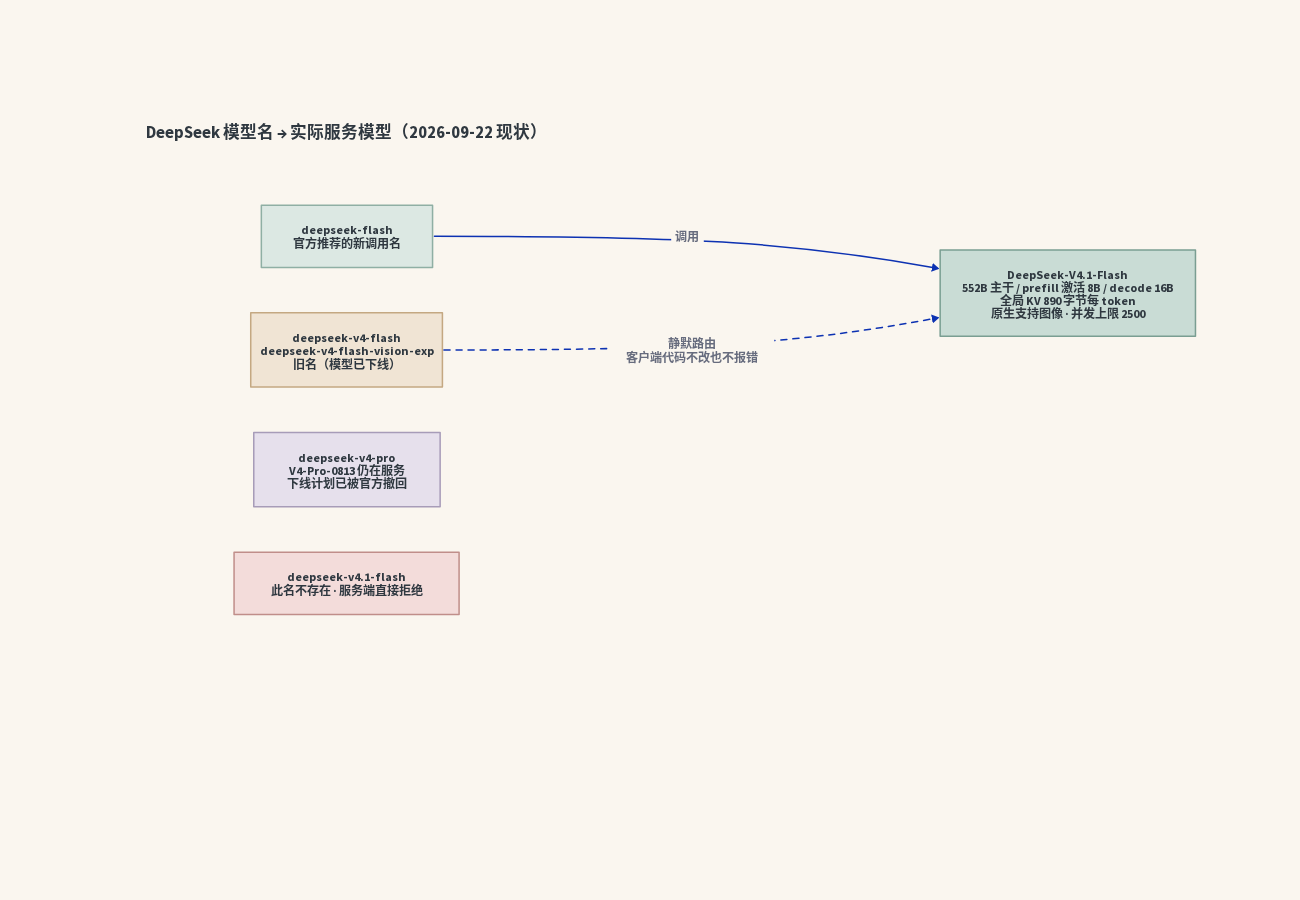
新调用名是 deepseek-flash,不带 v4。旧的两个名字 deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 仍然可以调用——但对应的模型已经下线,请求由 DeepSeek-V4.1-Flash 提供服务,按 Flash 价格计费。官方原文在价格页脚注 (1) 里写得很清楚,这是为兼容而保留的路由,不是模型还在。
有个容易踩的坑:deepseek-v4.1-flash 这个看起来很自然的名字不存在,传进去会被服务端直接拒绝。名字里有 v4 的反而是旧名,没 v4 的才是新的。
另外 V4.1-Flash 原生支持图像理解,而 V4-Pro 不支持。如果你的代码里对 deepseek-flash 做了多模态能力判断,这个字段需要补。
静默路由真正的风险不在"换了个更强的模型",而在于你的提示词、温度、思考强度、输出格式解析都是按旧模型行为调过的,服务端换了底座,客户端一声不响。
5 分钟能做完的审计动作:
|
|
命中的位置要分两类看:只是模型名常量(改个字符串就行)和按旧模型行为调过的提示词/参数(要重新验证)。后者才是真正的工作量——比如你为了让旧 Flash 稳定输出 JSON,在 prompt 里塞了三层约束,现在这些约束可能变成了冗余,也可能和新的思考模式打架。
官方六天内改了三次主意,所以别把任何一版公告当长期契约
把时间线摆出来,你会明白为什么这件事值得单独写一节。
9 月 9 日:DeepSeek 宣布在 V4.1 Pro 上线前,把对 V4-Pro 的请求全部路由到 V4.1-Flash,按 Flash 单价计费。 9 月 10 日:V4.1-Flash 发布,同日宣布推迟至 9 月 14 日 12:00 下线 V4-Pro。 9 月 11 日:宣布"为响应广大用户的需求,决定在 2026 年 9 月 14 日之后继续提供 DeepSeek V4 Pro 的 API 调用服务,计费方式保持不变,如有变动将另行通知"。
三次改动,方向变了两次。9 月 14 日已经过去了,V4-Pro 还活着。
这里有个必须点出来的矛盾:价格页脚注 (2) 至今仍然写着"我们计划有序下线 V4 Pro"和 9 月 14 日的路由安排,与 9 月 11 日的撤回公告直接冲突。官方没有同步更新文档。
所以你在网上看到的"V4-Pro 已死"“Flash 干掉了自家 Pro"这类判断,依据的都是 9 月 10 日的旧公告,框架已经过期了。
一个能复用的判断习惯:模型供应商的公告是意图,可观测行为才是契约。 公告会撤回,路由不会骗人——想知道自己实际在调什么,去打一次 API 看响应,别去读文档。
这也不是 DeepSeek 第一次这么干。从 deepseek-chat / deepseek-reasoner 到 deepseek-v4-flash,这套"旧名保留、后台换模型"的兼容策略他们已经用了好几轮。习惯上要默认:模型名是别名,不是版本号。
890 字节/token 换来的不是省钱,是并发数
现在讲架构层真正变了什么——但不是复述那张所有人都画过的柱状图。
先给结论:这次 KV 压缩改写的不是"你能省多少钱”,而是"你一张卡能同时跑几个会话"。
传统推理里,长上下文 Agent 的瓶颈是显存容量:上下文越长,KV 缓存越大,装不下就只能排队。V4.1-Flash 把常驻 HBM 的全局 KV 压到 890 字节/token,约为 V4-Flash 的 1/4、V1 的 1/437;持久 KV 通过 SWA Bounded Replay 压到约 1/8。
怎么做到的,三个机制值得记住名字:
CED(因果编码器-解码器):40 层 Transformer 拆成 20 层 encoder + 20 层 decoder,decoder 的全局 KV 直接从 encoder 的最终隐状态投影出来,而不是各层自己算。结果是 prefill 每 token 只激活 8B 参数、decode 激活 16B——对输入密集的 Agent 负载,这个差别直接体现在账单上。
CSA2(压缩稀疏注意力 2):每层被静态指派 Full / Reindex / Reuse 三种模式之一,跨层共享主 KV 和 indexer K。decoder 里的分层稀疏索引器把深层索引的候选池限制在第一个 Full 层构建的范围里,让更深的索引开销与上下文长度解耦。加上 FP4 主 KV 缓存(E2M1 格式,每 16 通道一个 E4M3 scale),才有了那个 890。
SWA Bounded Replay:滑动窗口的 KV 状态不持久化到 SSD,而是需要时重放最近 n_win 个 token 重建。这是"持久 KV 降到 1/8"的来源。
对你的部署意味着什么:如果瓶颈从容量变成了带宽,那么并发数不再被"装不装得下"卡死,而是被"每个 token 要搬多少字节"卡住。 890 字节/token × 1M ≈ 0.89GB 只是全局 KV 部分——不含权重、不含 196B 的 Engram 表、不含本地状态。所以这个数字的用法不是"我 1M 上下文只要 1GB 显存",而是"同样的卡,我现在能开更多长会话"。
想自己估算,抓这几个量就够:权重 511GB 磁盘占用、Engram 表 196.6B 参数(约 189GiB,必须常驻)、vLLM 给出的 vram_minimum_gb: 614。剩下多少显存,除以(890 字节 × 你的平均上下文长度 × 并发数)就是你能开的会话上限。
想自建,先接受 614GB 和一堆不兼容
如果你读完上一节开始盘算自建,这一节是泼冷水——把门槛摊开,让你当场判断该不该走这条路。
硬件底线:vram_minimum_gb: 614(511GB 权重 × 1.2 余量)。已验证的配置是 GB200 NVL4(TP4)和 8×H200(余约 500GB 给 KV);H100 8 卡 640GB 未验证。单卡、双卡消费级显卡、Mac Studio 现在都跑不了。
没有 pip wheel。vLLM 只提供 Docker 镜像 vllm/vllm-openai:deepseekv41-flash(vLLM 0.30.0+)。第一次加载要很久,官方预设 VLLM_ENGINE_READY_TIMEOUT_S=3600。
Engram 表必须常驻。196.6B 参数、约 189GiB,是除专家权重外最大的体积来源,跳过不了。而且权重本身已是原生 MXFP4/MXFP8 混合量化,二次做 GPTQ/AWQ 会破坏 UE8M0 scale 体系——别再量化一遍。
1M 上下文不等于能满配跑。vLLM recipe 原文明确要求限制上下文或并发,8×H200 上也一样。前面那 0.89GB 只是全局 KV,别把"支持 1M"读成"1M 随便开"。
工具调用格式变了。工具调用包裹在 DSML 标签块里,不是 JSON 围栏;工具结果也有自己的标签。如果你的解析器是按 JSON 写的,要改。
没有 Jinja chat template。模型卡里没有 template,只有 encoding/encoding.py 参考实现和一个 Rust 库 deepseek-recipe。想上生产,你得自己把这层补上。
真要启动,vLLM 侧的关键参数:
|
|
一句话决策:没有 8 卡 H200 或 GB200 级别的机器,别自建,继续走 API。 有机器也要先想清楚——省下的 API 费用,够不够付你的运维人力。
什么时候你反而该留在 V4-Pro
最后一节给决策边界,因为"V4.1-Flash 全面超越 V4-Pro"是个被过度简化的说法。
官方的原话是"在性能、费用、速度、总用时等各项指标上已全面超越"——这是综合口径,不等于逐项领先。翻模型卡自己的基准表就能看到 V4-Pro 仍在多个维度上更强:
- MultiLoKo(世界知识):50.9 vs 45.5
- SimpleQA-Verified:55.2 vs 42.3——这个差距很大
- LongBench-V2(长上下文理解):51.5 vs 45.2
- MATH:64.5 vs 61.1
也就是说,如果你的负载是"世界知识问答、事实性要求高的长文理解",V4-Pro 目前仍是更稳的选择。V4.1-Flash 赢的地方在 Agent 执行类任务——Terminal-Bench 2.1(90.6 vs 87.9)、DeepSWE v1.1(74.2 vs 62.7)、CyberGym(88.1 vs 83.3)、AutomationBench(54.8 vs 43.2),以及代码竞赛(Codeforces 3471 vs 3348)。注意 ProgramBench 这类指标上 V4.1-Flash(20.3)也高于 V4-Pro(15.5),真正的天花板是 Opus-5.0 的 37.0——别把别人的分数记成自家 Pro 的。
另一个反直觉的点:图像理解是 V4.1-Flash 的新能力,但"能看图"和"看得准"是两件事。V4-Pro 在复杂图像细节和深度科学推理上仍是更成熟的选择。如果你的业务是文档 OCR + 精细版面理解,别因为"新模型支持多模态"就无脑切过去——先拿真实样本对比。
还有一个纯浪费的场景:低难度任务用 max 档。V4.1-Flash 的思考强度是 1–100 的连续值,官方报告自己建议 max 只留给最难的任务。高 effort 会显著增加输出 token,把省下来的钱又花回去。
决策分界线其实很清楚:Agent 执行、代码、长上下文成本敏感 → 切 V4.1-Flash;世界知识、事实准确性、复杂图像 → 留在 V4-Pro。 而图像能力不要靠推断,靠样本测。
明天可以做的两件事
回到最实际的。你现在能立刻做、成本最低的两个动作:
第一,跑那条 grep,先搞清楚自己在调什么。 命中的每个位置标上"改个字符串就行"还是"要重新验证行为"。这件事半小时内能做完,做完你就知道自己有没有被静默路由影响。
第二,去价格页对一遍峰谷时段。 高峰时段是北京时间周一至周五 9:00–12:00、14:00–18:00,其余为空闲时段,空闲价格是高峰的一半。deepseek-flash 空闲时段输入(未命中)1 元/百万 token、输出 4 元;高峰翻倍。如果你的批处理任务不是强实时的,把调度挪到空闲时段,是这次变更里唯一零风险、立刻见效的省钱动作。
至于要不要迁移、要不要自建——先把上面两件事做完,你手上的数据会替你回答。
参考与验证(访问日期:2026-09-22)
- DeepSeek API 更新日志(2026-09-10 条目,模型名变更与 V4-Pro 下线安排):https://api-docs.deepseek.com/zh-cn/updates
- DeepSeek 模型与价格(脚注 (1) 旧名路由、脚注 (2) V4-Pro 下线计划、峰谷时段):https://api-docs.deepseek.com/zh-cn/quick_start/pricing
- DeepSeek 思考模式文档(effort 映射、默认开启且为 high、
reasoning_content回传规则):https://api-docs.deepseek.com/zh-cn/guides/thinking_mode - DeepSeek-V4.1-Flash 模型卡(552B 主干、CED、CSA2、890 字节/token、SWA Bounded Replay 1/8、基准表、MIT 许可、无 Jinja template):https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash
- 技术报告 PDF:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/blob/main/DeepSeek_V41_Tech_Report.pdf
- vLLM Recipe(
vram_minimum_gb: 614、511GB 权重、Engram 196.6B/188.8GiB、Docker 镜像、DSML 工具调用、1M 上下文需限配):https://recipes.vllm.ai/deepseek-ai/DeepSeek-V4.1-Flash - DeepSeek V4-Pro 下线计划撤回(IT之家 2026-09-11):https://roll.sohu.com/a/1074927581_114760 ;第一财经:https://wap.eastmoney.com/a/202609113872244492.html
关于本文的边界:文中所有性能与容量数字均来自 DeepSeek 官方模型卡、技术报告与 vLLM Recipe,属官方自测口径,本文作者未做独立复现。890 字节/token 与 1/8 持久 KV 压缩是官方声明值。vLLM/SGLang 对 V4.1 的支持目前均为预览镜像,正式版参数可能变动。本文属公开资料分析,非实测。