浏览器 Agent 慢,多数人的第一反应是换一个更快的模型。
jev-ultrafast 给出的数字,值得看的其实不是"7 秒",而是它顺手测出来的另一个数:单次任务的浏览器协议调用,中位从 1092 次掉到 101 次。模型没换,任务没换,只是把"观察—决策—执行"这条链路的耦合方式改了。
这篇文章拆它到底砍了哪一层,以及你怎么给自己手里的 Agent 做同样的延迟归因。适合已经在用 Playwright / Browser Use / CDP 自建 loop、被模型往返和账单拖住的后端与 AI 工程师。
1092 → 101:被砍掉的不是模型,是浏览器往返
先立一个归因框架,不然优化全是盲打:
一次 Agent 任务的墙钟时间 = 模型决策耗时 + 浏览器协议往返耗时 + 页面自身加载耗时。
大部分人只盯着第一项,因为它是唯一"看起来贵"的一项——打开 LangSmith 看 token 账单,第一反应是换 gpt-4o-mini。但 jev-ultrafast 的 docs/performance.md 里,模型侧的中位延迟是 178ms,即便多次 Jev 请求累计也就 3 秒左右——而原版 loop 光浏览器协议调用就有 1092 次。
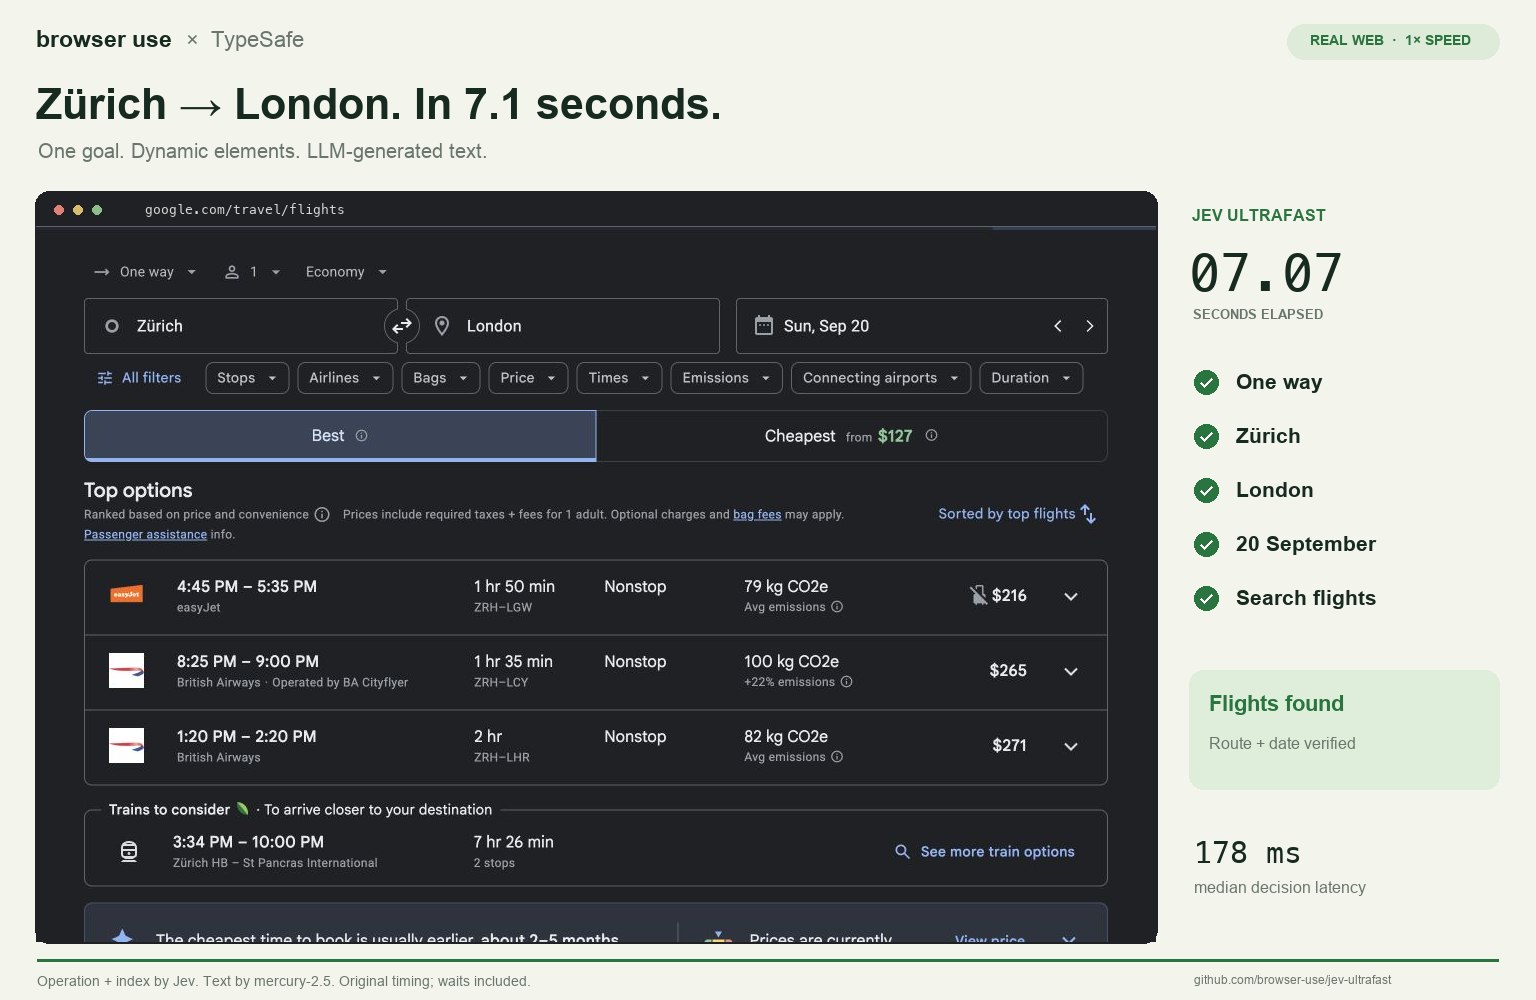
从官方记录的那次看板中能看到两个核心细节:右侧醒目标注了全链路任务耗时 7.07 秒,每一步交互(单程/苏黎世/伦敦/日期/搜索)均通过了独立验证器;而底部实测出的决策模型中位延迟仅 178ms。当模型侧被压缩至这个量级时,真正拖慢整个 Agent 的就是底层协议往返。
官方对原版 loop 的描述是:每次 DOM mutation 都会作废已有决策(包括动画引起的 mutation),反复读取 accessibility tree,解析上百个 DOM 节点。注意"包括动画"这四个字——一个轮播图在转,你的 Agent 就在疯狂重读页面、重做决策。
新版的做法是:一次浏览器调用,原子读取可见控件的名字、值和文本,并且保留对真实 DOM 节点的引用。读取次数从"每次变更一次"变成"每步一次"。
这就是协议调用能掉一个数量级的直接原因。它不是把 1092 次调用变快了,而是把大部分调用变得没必要。
四个核心指标拉通对比,能一眼看出性能杠杆到底撬动在哪:
浏览器协议调用:1092 次 → 101 次(-90.8%)。从"每次 DOM 变更重采样"改为"每步一次原子快照",直接砍掉九成无意义往返。
任务墙钟耗时:9.450s → 7.092s(-25.0%)。剔除动画引发的反复决策与等待抖动,端到端中位耗时稳稳降掉四分之一。
决策模型请求:22 次 → 17 次(-22.7%)。推测式并行合并决策头,原本分两步的问询被压进同一次网络往返。
单次模型延迟:中位仅 178ms。把动作空间封闭压紧之后,专用极速小模型才能真正接管决策层。
换模型优化的是单次往返的成本,重构观测层优化的是往返的次数。次数是一个乘数,成本只是一个单价。
判断你自己的 Agent 卡在哪,先数三个数:单次任务的模型请求数、浏览器协议调用数、单次模型延迟中位。如果协议调用是三位数而模型延迟是两位数毫秒,你该动的是观测层,不是模型选型。
一次请求里塞两个决策头:动作空间的形状比模型选择更重要
动作空间封闭,是这套方案能换掉大模型的前提;怎么把操作和目标合进一次往返,是协议调用能砍掉的原因;fail-closed 校验,是保证执行层安全的底线。三件事都发生在"向模型提问"这一步。
每个观测会生成一张编号元素表:
| |
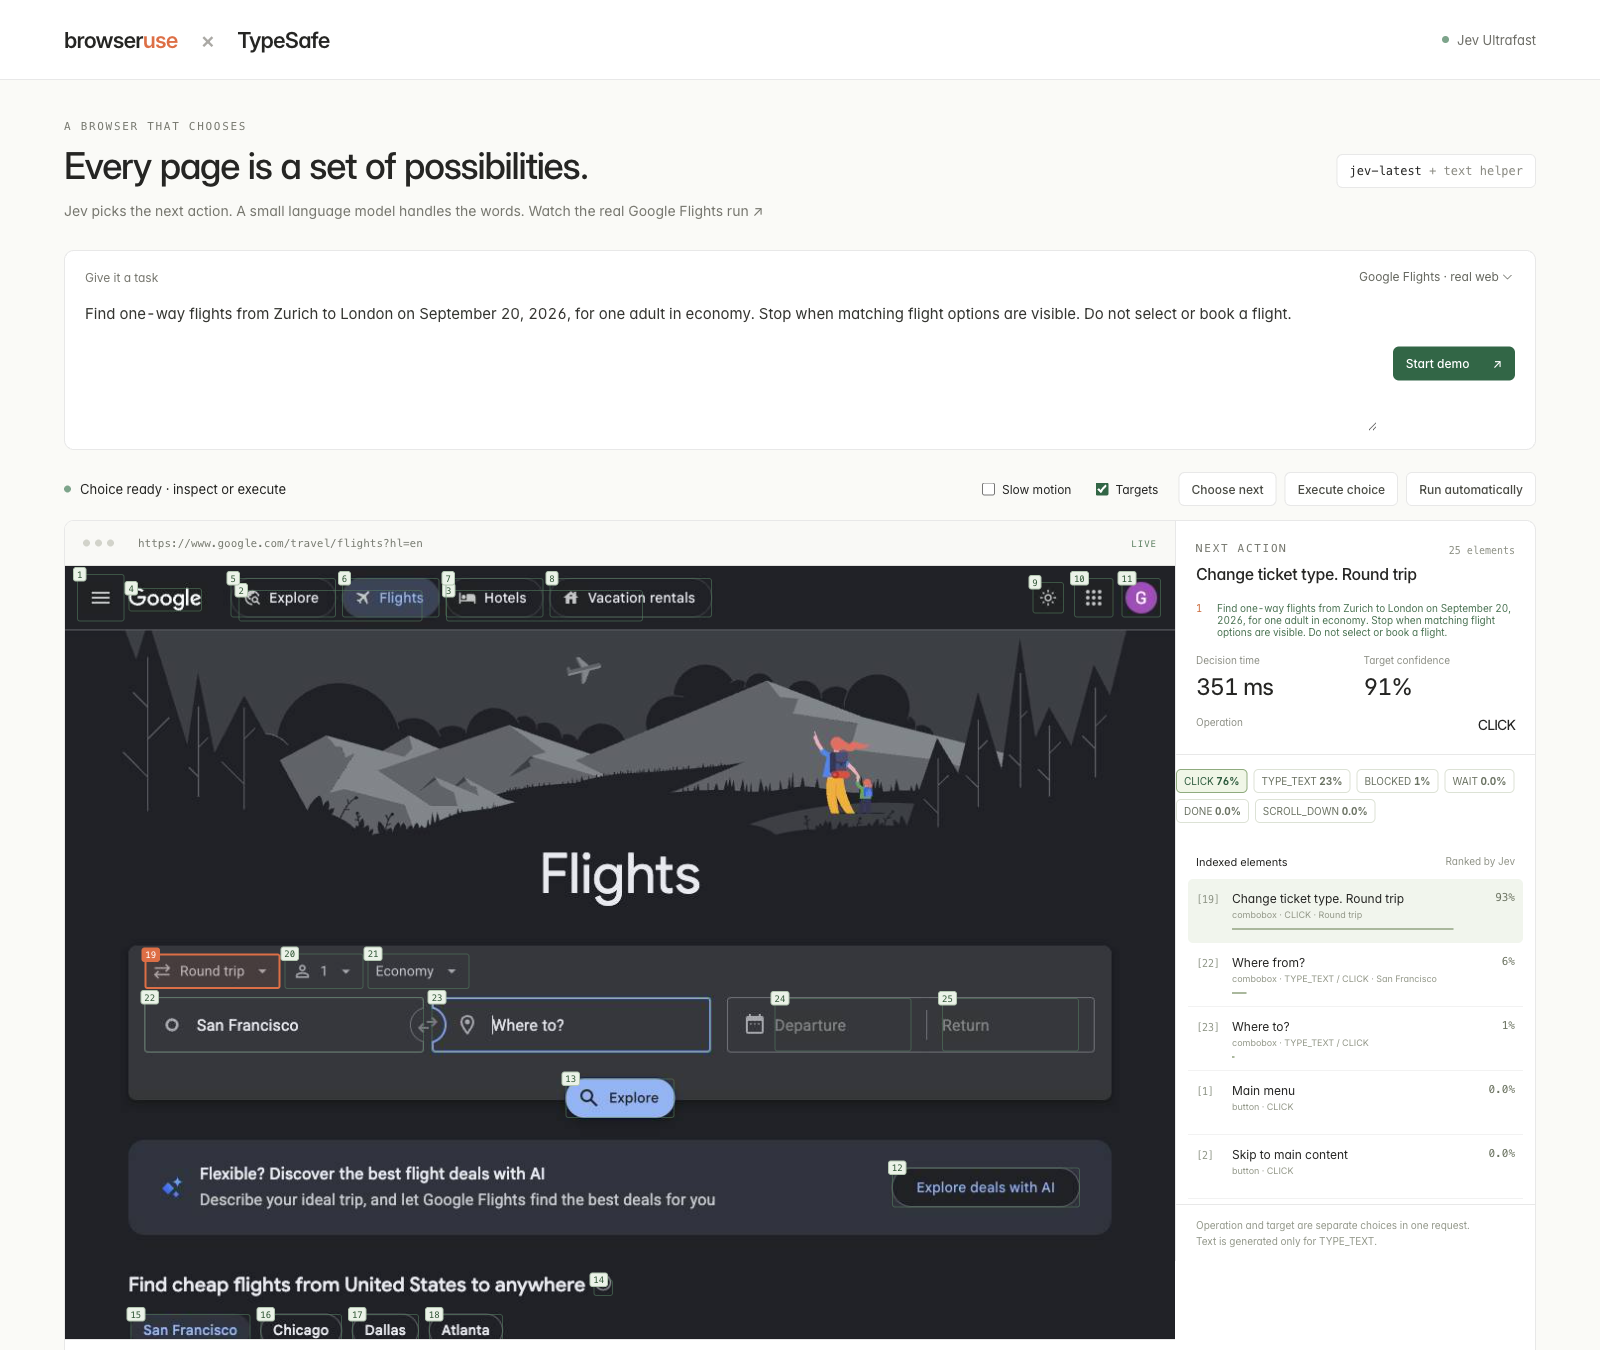
操作集是固定封闭的八个:CLICK、TYPE_TEXT、SELECT、SCROLL_UP、SCROLL_DOWN、WAIT、DONE、BLOCKED。
关键在于它怎么把操作和目标一起问出去。源码 model.py::choose() 里,发往 TypeSafe(底层提供推测式多头预测的推理服务)的请求体包含一个 operation 问题(选择上面八个之一),外加每个操作各自的目标问题——click_target、type_text_target、select_target。所有问题在同一次网络往返里并行回答,这就是官方文档里那个 speculative fan-out(推测式扇出)模式。
而且每个目标头里只放兼容的元素:click_target 的候选里只有可点击元素,select_target 的候选里只有观测到的下拉选项。源码注释写得很直白:
| |
未命中的目标头结果被直接丢弃,永远不会触发动作。这就是"推测式"的代价边界:你多花了一点推理算力去买一次往返,但拿不到执行权限。
落到你自己的项目上,这是个可以立刻自查的判断题:
模型在输出什么? 是自由字符串(CSS 选择器、坐标、JS 片段),还是受限集合里的一个索引?
合法目标的边界在哪? 每个操作是否只向模型暴露合法的目标?
非法输出怎么处理? 是 fail-closed(不执行)还是 fail-open(猜一个执行)?
jev-ultrafast 的答案是 fail-closed,而且比 README 写的更严格。validate_choice() 不只校验 choice 在候选集内,还要求概率分布的键集合与候选完全一致、每个概率在 0~1 之间、概率和与 1 的偏差小于 0.02,以及:
| |
选中的那一项必须同时是概率最大的那一项。任何一条不满足,直接抛 ValueError("Invalid TypeSafe response; no action executed."),一步都不执行。
对照上面的 Inspector 截图就能看得很直观:右侧面板实时展示了当前决策——Operation 判定为 CLICK(置信度 76%),目标元素严格收敛在概率最高的 [19] 选项(93%)。即便模型在同一次推理中也为 type_text_target 计算了概率分布,但因为主操作未中,未命中的头会被 if operation in targets: 这一行直接丢弃,根本进不去执行管道。
这层校验的意义不只是防错。它把"模型输出"和"可执行动作"之间的缝焊死了——模型输出永远不会变成选择器、坐标、shell 命令或可执行 JavaScript,只能变成一个已观测节点的索引。这是把决策层换成小模型/专用模型的前提条件。
决策和生成分两个模型:生成模型只在没有确定答案集合时才上场
正如上面架构流程图所示,整套系统在这一步完成了关键分流:决策与生成被彻底切成了两个模型。
决策层不生成任何文字。只有当选中 TYPE_TEXT 时,才调用一个 OpenAI 兼容的小模型(示例配置用 inception/mercury-2.5,代码默认 base 指向 DeepSeek)来产出字段值。官方记录的那次运行里,两次生成分别是 Zurich 581ms、London 346ms。
这个 helper 的输入输出约束,比很多生产代码都严:
| |
输出必须能解析成 JSON、必须恰好只有 text 一个键、必须是非空字符串、长度不超过 2000。任何一条不满足就抛错,错误信息是 "Text helper returned no valid field value; nothing typed."——宁可什么都不输入,也不输入一个猜的值。
官方在 performance.md 里坦承,早期探针阶段就淘汰过一个把出发地和目的地搞反的模型,以及另一个输出解释性文字而非合法 JSON 的模型。
由此可以提炼一条判定标准,比"哪些步骤该用小模型"更可操作:
凡是有确定答案集合的判断,就不该用生成模型。分类、选元素、路由、打分,这些都不该让 LLM 自由生成文本再解析;凡是没有确定答案集合的(写一段文案、填一个城市名),才需要生成模型,并且必须加结构校验。
分层选型的原则之外,这套架构落地时最隐蔽的挑战在于:极速决策层(178ms)与异步文本生成(300~500ms)解耦后,模型时钟与真实 DOM 渲染极易产生异步漂移。如果前一步点击刚触发、异步事件尚未渲染完毕,下一帧观测到的极可能是陈旧状态。
代码里写着一条关键防御注释——"A stale post-action observation must not erase the action"——执行先记录,再观测;已落地的动作绝不能被陈旧的后验观测所抹杀。围绕这一原则,源码配套了四处工程硬边界,专门防范异步并发下的状态抖动:
步数硬上限 MAX_STEPS = 60,超过就抛错停下,不无限重试。
等待时间有界 输入 combobox 后等待可见建议上限 200ms;其他交互最多等两帧或 50ms。
文本复用条件严格 陈旧页面重试时,只有文本 helper 的全部输入未变,才复用已生成的文本。
焦点模拟 防止后台标签页被降频,但不切换 Chrome 可见标签。
p=0.25、三个 pair、一个任务:数字有多可信,作者自己写清楚了
jev-ultrafast 最容易被忽略的资产,是它的实验设计。它没有只放一个漂亮数字,而是把"我做了什么才算可信"写清楚了。
值得抄的四个动作:
- 冻结基线 commit。原版 loop 固定为
68c077bf79caca4e817b8e8a5854b2efa0c81ff6,不是"优化前的某个版本"。 - 交替运行。六次运行按 pair 交替执行(原版/新版/原版/新版…),避免时间漂移只污染一侧。
- 两侧固定非被测变量。两臂用同一个自然语言目标、同一个独立结果校验器、同一视口 1120×780、同一个 TypeSafe
jev-1.13.0、同一个inception/mercury-2.5、同样的预算,并且都关掉文本推理。原文说得很清楚:两臂都用 Mercury,是为了"不让 helper 模型的变化和代码变化混在一起"。 - 保留全部失败记录。原文写明"All six attempts are included; no provider or verification failures occurred",并且把开发过程中的尝试也留下了——原版 9.302s 通过,两个 accessibility-tree 方案 9.395s / 10.157s,第一个直接读 DOM 的方案 8.697s 但因为 name/value 提取不完整被独立校验判失败。
它自己承认的三个洞:
样本量不够。原文原话:“Three pairs are too few for a strong statistical claim (two-sided sign-test p = 0.25)"。三个 pair、一个任务、一个浏览器 profile,作者自己定性为"a small controlled-input comparison, not a broad agent benchmark”。
计时边界。计时从初始首页观测后的第一次预测开始,不含初始导航和首次观测,也不含跑完后的独立验证。Hacker News 上第一条质疑就冲着这个来的:
“Timing starts after initial page observation” Isn’t this the part that takes most time? (“计时从首次观测后才开始?但这难道不是整个过程里耗时最长的一部分吗?")
这是个成立的质疑,作者也没有反驳——他只是把边界写在了明面上。
成本数字不可复现。performance.md 只给了两次文本 helper 的 OpenRouter 账单 $0.00006272,并明确说这不是任务总成本:TypeSafe 的响应返回 token 数但不返回计费金额,浏览器成本完全没算。
网上流传的"单次 0.0039 美元"来自作者 X 帖和二手报道,仓库里没有这个数字。凡是引用它,都应该标注为"作者在演示中宣称”,而不是当成已验证的成本。
还有几个硬边界值得在选型时先看清楚:
最关键的兼容性限制:Jev 只吃文本,不支持图像输入;DOM reader 不处理 shadow roots、frames、canvas。 如果你的目标站点大量使用 Canvas 或无语义 div 渲染,DOM reader 会直接失效,视觉 grounding 仍然是必要的——这套方案根本用不上。
成熟度问题: 这是 3 次提交、无 release、无 tag 的演示级 MVP。DONE 需要独立结果验证,模型说完成不等于完成;owned tabs 复用现有 Chrome profile,有登录态隔离问题;文件上传、弹窗新标签、嵌套滚动、任意键盘控件暂不覆盖。
不过账得算全。这套方案真正的启示不是"赶紧换 Jev",而是它证明了:动作空间的形状决定了你能不能用便宜的决策层。把模型输出从自由字符串压成受限索引之后,决策层用什么模型才有得选。反过来,如果你的 Agent 还在让模型吐 CSS 选择器,那换什么模型都是在给一个漏水的桶换更快的龙头。
看清别人的局限,是为了把真正有用的武器拿来武装自己。你完全不需要等开源项目把这些边界解完,今天就能做一套针对自己 Agent 的轻量延迟归因。
明天加三行埋点,先把自己的 Agent 量出来
不用换模型,也不用接 TypeSafe。打开你现在跑的 Agent,加一行埋点,把一次任务里的三类数字打出来:
| |
跑三个真实任务,把这三类指标对照下面的诊断逻辑排查:
协议调用上百、模型延迟数十毫秒(乘数爆炸) → 瓶颈在观测层。去看有没有"每次 DOM 变更都重做决策"的逻辑,尤其是动画引起的 mutation。优先把全量重读页面收敛为每步一次的原子快照。
模型请求数远大于交互步数(单步重复交税,接近 2:1 甚至更高) → 瓶颈在网络往返。你正在为"选操作"和"选目标"付两次网络开销。看看能不能用 Speculative fan-out 把操作头与目标头合并进同一次请求并行回答。
模型单次延迟占整体耗时大头(单价过高) → 这时换模型才有收益。但先确认输出是不是自由字符串;如果是,先把它改成已观测节点的受限索引。动作空间的形状封闭了,极速决策层才有得选。
顺手验证一个最小命令,确认这套思路在你机器上能跑通(不调模型、不花钱):
| |
这个脚本存在的意义本身就是一个信号:点击守卫、控件状态、遮挡判断这些东西,是可以在不调用任何模型的情况下单独验证的。如果你自己的 Agent 里这些逻辑和模型调用缠在一起没法单独测,那可能才是最难改的那部分。
参考链接与项目地址
- jev-ultrafast 开源仓库:https://github.com/browser-use/jev-ultrafast
- 性能测试对照与计时边界:https://github.com/browser-use/jev-ultrafast/blob/main/docs/performance.md
- 决策模型与动作空间源码:https://github.com/browser-use/jev-ultrafast/blob/main/jev_ultrafast/model.py
- 步数上限设定源码(MAX_STEPS):https://github.com/browser-use/jev-ultrafast/blob/main/jev_ultrafast/questions.py
- TypeSafe speculative fan-out 模式文档:https://docs.typesafe.ai/patterns/fan-out
- Hacker News 讨论帖:https://news.ycombinator.com/item?id=49735979