你花三倍预算把单 agent 拆成「规划 / 执行 / 写作」三个角色,跑了两周,报告完成率反而掉了,而且每次卡住的地方都不一样。
第一反应通常是去调 prompt、换 worktree、加个 reviewer agent。但有一篇刚被 COLM 2026 接收的论文给了另一个解释:你挑模型的依据(榜单跑分)和多 Agent 团队真正需要的能力(协作性),是两个几乎不重叠的维度——而后者可以用六个行为经济学小游戏、在不到 1K token、约一分半钟里测出来。
适用对象:正在搭或准备搭多智能体流水线的 Golang / AI / 后端工程师、AI 平台负责人。结论先给:部署前先给你的候选模型跑一遍协作筛查,不及格的别放进需要共享预算的流水线。
越大的模型不一定越会协作,而榜单根本不测这个
先说结论里最反直觉的一条。论文对 41 个开源权重模型(12 个家族,0.6B–70B)跑了六个博弈,回归结果里,模型规模的 log10 每增加 1,离 Pareto 最优的距离就增加约 0.058——也就是说,平均而言模型越大,行为越偏向自利策略而非合作最优。效应量不大,别读成「大模型一定自私」,但方向是明确的,论文自己把「模型规模」列为协作性的主导预测因子。
更值得注意的一格是 thinking 变体。有一派流行说法是推理模型更爱「搭便车」——但在这个更新的版本里,thinking 变体的系数是 0.021,95% 置信区间 [−0.067, +0.110],跨过零,也就是没有可信差异。论文甚至专门注了一句,这与近期认为「推理模型更倾向策略化、更会 free-ride」的研究结论相左。这条要当成悬念读,而不是当成结论:关于推理模型协作性的证据,目前学界自己还没对齐。
关键在最后半句:协作性在控制住 IFEval、MMLU-Pro、MATH-500 和模型规模之后,对下游任务结果仍然有可信的预测力——论文的措辞是「not reducible to general ability」(不能还原为通用能力)。翻译成选型语言就是:你手上那张通用能力榜,测不到这个维度。
 六个博弈各自隔离一种协作失败机制,中间是它在真实流水线里对应的病症,右侧是该盯的指标。博弈定义与主指标取自论文正文
六个游戏各测一种「散伙方式」,你大概率会栽在其中一种
论文选的六个博弈不是随便挑的,每个都隔离一种协作机制。把它们的 payoff 结构对照成工程问题,就得到一张排查表:
- Weakest-Link(最弱环协调):全队收益取决于 10 个人里最低的那个努力值。对应——你的流水线里只要有一个环节摆烂,整条链的产出都被拖到那个最低水位。主指标:平均努力。
- CPR(公地资源):10 人共享一个 100 的资源池,各自提取有个人收益、但会耗竭公共资源。对应——多个 agent 共享一个 token 预算或 GPU 时间。主指标:平均提取量。
- CPR + 惩罚:在提取之后,组内可以花代价惩罚过度提取者(罚 1、被打 2)。对应——你有没有给系统装真正的「超支惩罚」,还是只写了句「请节约」。主指标:平均提取量。
- Collective Risk(阈值公共品):要凑够总贡献(阈值 100)才能避免全员损失,否则有 50% 概率全输。对应——需要集体达标才能通过的任务,比如四个团队依次产出、缺一环就不完整。主指标:每轮平均贡献。
- O-Ring(乘法团队生产):团队产出是乘法结构,任何一个人质量塌了,整体产出归零;同时从共享池里的提取会挤占别的组。对应——乘法依赖的流水线,一环质量崩了全盘皆输。主指标:平均退让量。
- Public Goods(公共品):钱可以留给自己、投组内池(×2 组内分)、或投全局池(×1.5 全员分)。对应——同一份资源,投本组还是投全局,agent 会怎么选。主指标:平均组内池贡献。
对应关系本身比逐个数字有用:你不是在问「多智能体行不行」,而是在问「我的这条流水线最像哪一种游戏」。 共享预算的多团队协作最像 CPR;一环质量决定成败的最像 O-Ring;需要集体凑数达标的像 Collective Risk。想清楚这一点,才知道该盯哪个指标。
两个最该看的指标,指向两个相反的修复动作
论文在 AI for Science 流水线上(四个团队串行、共享一个预算池、每个团队 2–3 个 agent、用 LangGraph 实现)做了 3,473 个配置、41 个模型的下游回归,最稳的两个预测因子是:
第一,O-Ring 的退让量,和三项结果全部负相关,且对「完成度」影响最强(β = −0.232,置信区间 [−0.254, −0.210])。 含义非常直白:一个不愿投入共享资源去打磨自己那部分质量的团队,会让整条流水线跑不完。 论文的原话是「a single disengaged team can prevent the pipeline from finishing」。
换句话说:决定你的多 Agent 系统能不能跑完的,往往不是最聪明的那一环,而是最不肯出力打磨的那一环。
第二,Weakest-Link 的努力度,和「准确性」正相关。 在最低努力决定产出的游戏里愿意投高努力的模型,产出的科学报告更准。有意思的是它和「质量」「完成度」是负相关——这类模型报告更准,但完成的阶段更少、写出来更粗糙。这不是矛盾,是一种取舍:过度投入协调会挤占完成进度。 你不能同时指望一个模型既当最可靠的协调者、又当最快的执行者。
这两个指标指向的动作正好相反:O-Ring 退让高 → 该给那一环设硬门槛(不允许它只做最低投入);Weakest-Link 努力低 → 该给它加预算或换人。 换成架构语言:流水线里质量决定全局的那一环,要用 O-Ring 表现好的模型;需要死磕协调一致的那一环,用 Weakest-Link 表现好的模型。
真正反直觉的一格是 CPR 的对照实验。CPR 提取量低,准确性更好但质量评分更低;而 CPR+惩罚的提取量,和准确性、完成度正相关,和「质量」负相关。 也就是说,在明确有惩罚机制的条件下,模型仍会继续激进提取——论文的判断是:真正有区分度的信号不是「提取了多少」,而是「是否对惩罚机制敏感」。 这条对你设计预算控制很有用:加一条「超支扣分」的规则,比反复写 prompt 求它节约更能筛出可用的模型。
一个前提必须说清楚:这些是「预测性关联」,不是因果。论文明确否认了因果识别,作者也写了存在潜在能力混杂因子。所以正确的用法是「相关性筛查」,不是「改了指标就变好」。
一场不到 1K token 的部署前考试,半天能跑完
现在把上面的结论变成你今天能做的动作。
成本账先算清楚(这是本文最硬的一组数): 论文附录实测,跑一次完整的多智能体科研流水线,中位数 164,005 token/次(41 个模型从 33,302 到 668,172 不等,含 thinking token)。而六个博弈全套扫一遍的中位时间是 1.5 分钟,一次完整的 AI for Science 实验是 10.4 分钟;博弈输出只有几十到几百个 token(thinking 模型几百),论文确认 约 20 次模拟就能收敛出稳定的行为指标。综合下来是约 67 倍更快、38 倍更少 token。换句话说,跑一轮博弈筛查的代价,约等于跑 3 次完整实验。
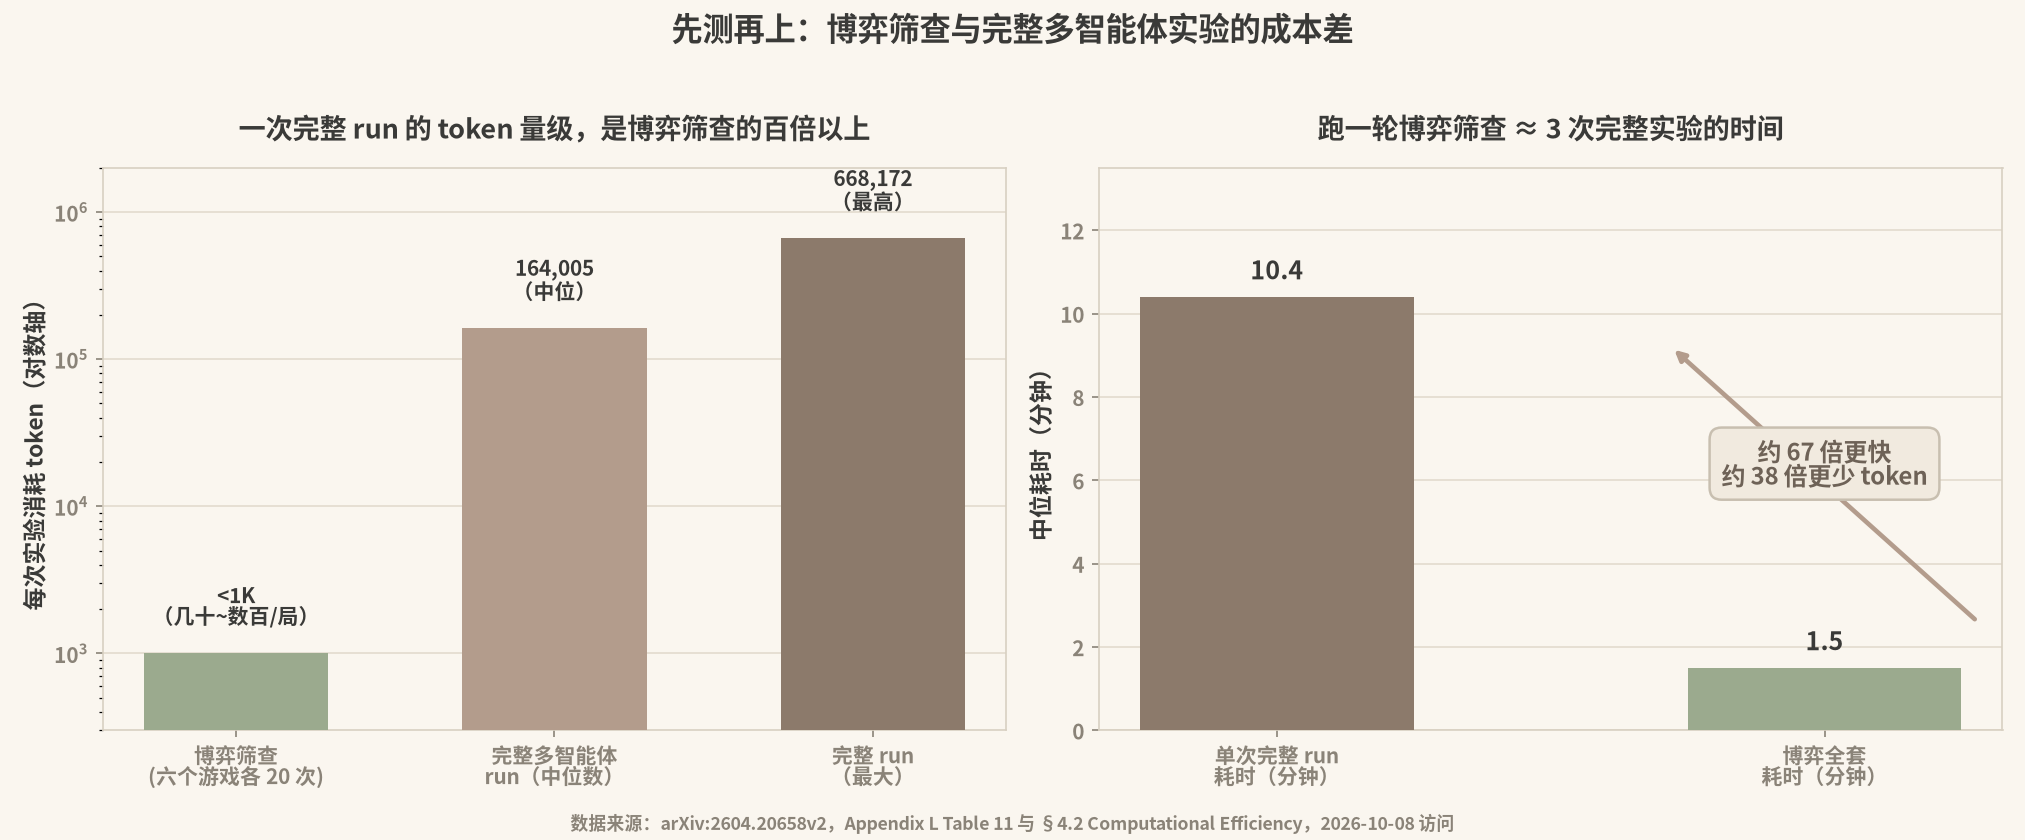 左边是每次实验的 token 消耗(对数轴),右边是单次实验的中位耗时。一次完整 run 的 token 量级(中位约 16 万)比博弈筛查(不到 1K)高出约两个数量级。数值取自论文附录 L 的实测表
筛查 SOP(可直接照做):
- 圈定候选池,最多 5 个模型——你正在纠结的那几个 + 现在在用的那个作基线。
- 每个模型跑六个博弈各约 20 次模拟。论文的默认配置是 2 组 × 5 人、5 轮/局,可以让 agent 用结构化 JSON 输出决策,直接复用论文 Appendix B 的 prompt 模板。
- 只先看两个主指标:O-Ring 平均退让量、Weakest-Link 平均努力值。不要一上来就看全套六维,噪声会淹没信号。
- 设及格线(按你候选池的相对位置定,比如退让量在池内后 1/3 的一律剔除),只放行及格者进多智能体。
- 没通过的解,回退到单 agent + 强工具链——论文的整套实验都在共享预算约束下做,而共享预算正是多智能体最容易翻车的地方。
一条最小判断式,可以直接写进你的选型文档:
|
|
关于 ToM 提示词,这里有个容易踩的坑:ToM 提示在博弈里确实能让模型更靠近 Pareto 最优(系数 −0.035,置信区间 [−0.040, −0.030],是这个版本里仅次于模型规模的最强策略效应),但在真实的科研流水线里,它只对「完成度」有微弱帮助,对质量和准确性都没有可信效果。 论文的推测是:博弈太简单,真实任务复杂到「模型没法一边想别的任务一边做心智推理」。交互结构分析也证实——加了 ToM 之后,团队间的交接模式没有显著变化。别把博弈里的好成绩直接外推成「加一句 ToM 提示词就能提升协作」。
这四条会让筛查失效,别照抄
一、这是相关性,不是因果。 论文自己在「识别挑战」一节写明了:博弈指标在同一模型内是常数,只能做模型间比较,存在潜在能力混杂。他们因此把结论定义为 predictive association。所以筛查的定位是「便宜的排除工具」,不是「改了这个就一定变好」。
二、样本边界很硬:只有开源权重、0.6B–70B。 论文全部 41 个模型都是开源权重、≤70B,全部用 vLLM 本地部署。你如果在用闭源旗舰 API,这套结论对你是外推,不是套用。 想在自家闭环里用,得自己搭游戏环境重跑。
三、任务域是「AI for Science」合成任务,不等于你的生产场景。 四个任务是生态种群动态、多传感器异常检测、临床生物标志物发现、空间资源制图,都用合成数据 + 确定性 ground truth。你的后端微服务编排、代码生成流水线未必落在同一个分布里。 越接近「多团队串行 + 共享预算 + 一环质量决定全局」的场景,这套结论越适用。
四、博弈分数高,不等于你的领域一定行。 论文里最会协作的家族是 Gemma 4 和 OLMo,离 Pareto 最远的是 Granite 4 和 Nemotron——但这是在它的任务和 prompt 设定下的观察。换任务、换提示词模板、换预算约束,排名都可能变。 论文自己做了 prompt 不变性检验(Appendix E,换一套散文式 prompt 无影响),但那只证明了他们的模板稳健,证明不了跨领域稳健。
还有一处要主动规避的坑:论文声明代码和数据在 GitHub 上公开(github.com/davidjurgens/agent-cooperation),但我这次访问没能打通这个仓库,所以别把「可以直接下载复现」写进你的立项依据——论文原话是 code and data are available,具体可用性要你自己打开确认。
至于要不要现在就上多 Agent:如果你的场景是单文件改代码、单轮问答、能靠一个强模型 + 工具搞定的事,协作筛查这套东西根本不用跑——直接单人干更省。 只有当你确实在做多阶段、多角色、共享预算的流水线时,这笔一分半钟的筛查才划算。
下一步先做这一件事:把你手上候选的 2–3 个模型拉出来,只跑 O-Ring 和 Weakest-Link 两个博弈、各 20 次,看退让量和努力值的相对排序。排序和你按跑分排出来的顺序不一致的那一格,就是你今天最该看的地方。