先别急着惊叹——Prism ML 把 Qwen3.8-27B 的权重压成了 {-1, 0, +1} 三个值,语言塔 5.95 GB,官方报告保住 FP16 基线 98.2% 的成绩。这意味着 24GB 显卡第一次能常驻一个 27B 级推理模型做本地 Agent。但这不是免费的:你必须交出 llama.cpp 生态位改用它的 fork,而掉的那 1.8%,恰好掉在最要命的地方。
1.72 bits/weight 是怎么凑出来的
先说清楚这不是"又一个 K-means 换皮的 PTQ"。
常规 2-bit 量化的思路是把权重挤进 4 个格子(2^2=4)。三值量化走得更狠:每个权重只剩 -1、0、+1 三个状态,信息论下限是 log₂3 ≈ 1.585 bit。听起来比 2-bit 还少,但裸三值没法用——所以每 128 个权重共享一个 FP16 scale 做反量化缩放,摊下来实测 1.72 bits/weight。27B 参数乘一遍,就是那个 5.95 GB(PQ2_0 打包为 7.21 GB,对照 FP16 约 54 GB)。
真正让它区别于普通低比特量化的是 Hadamard 旋转基:量化前先把权重矩阵旋转到误差更均匀的坐标系里,三值的表达力被重新分配。这个设计带来一个工程上很硬的约束——运行时要么精确匹配旋转流程,要么直接拒载。官方模型卡 Quickstart 里写得很明白:stock llama.cpp 会拒绝加载 PQ2_0/PTQ1_0,更危险的是它可能把文件当成 Q2_0 静默加载,然后输出乱码。不报错、不警告、结果全错,这是所有做推理服务的人最怕的事故形态。从这个角度看,“强制绑 fork"反而是种诚实:它宁可让你装不上,也不让你悄悄跑错。
代价也在这里:你用的不再是社区主干的 llama.cpp,而是 PrismML 维护的分叉(依赖 github.com/PrismML-Eng/llama.cpp)。这个后面算总账。
98.2% 的另一面:它卖掉了哪 1.8%
均分只掉了 1.54 分,但分数不是均匀掉的——这恰恰是使用说明书。
模型卡给了 14 项 thinking-mode 基准的对照,把它按能力类别拆开看:
| 能力 | Bonsai 2 | FP16 基线 | 结论 |
|---|---|---|---|
| 数学 | 96.57 | — | 基本无感 |
| 编码 | 89.42 | 略低于它 | 反超基线 |
| 指令跟随 | 略超 | — | 工具调用安全 |
| 知识推理 | 79.86 | 85.55 | 掉 5.7 分 |
| 视觉 | 66.19 | 71.36 | 掉 5.2 分 |
编码和数学是被保住的资产,知识记忆是被卖掉的部分。这符合三值量化的直觉:数学和代码是过程性能力,靠的是推理链结构;事实问答是存储性能力,靠的是权重里记住的具体参数——1.585 bit 的格子最先挤丢的就是后者。
更有警示意义的是对照组。模型卡同页列了常规 IQ2_XXS"2-bit"量化:均分只有 72.59,而且塌得极不均匀——MMLU 这类知识题还能拿 88.9,一到 AIME26 数学竞赛直接崩到 57.5。也就是说,如果你随手拿一个常识问答测测 2-bit 模型,它会"看起来没问题”;等你把它接进数学或代码链路,才发现地基是空的。这种选择性塌陷解释了为什么很多团队对低比特量化有信任危机:不是量化不行,是单点测试根本测不出来。
由此得到一张迁移判断表——哪些云端流量值得搬回这台 5.95 GB 的本地模型:
适合迁本地:代码补全与 review、数学/逻辑推演、结构化指令跟随(工具调用编排)、对延迟敏感的高频小任务。 别迁:企业知识库问答、事实型客服(幻觉风险放大 5.7 分的知识缺口)、多模态业务(视觉塔本身另计 ~0.63 GB 且掉分最狠)、需要超长上下文的场景——OpenRouter 上架版本 context 只有 262K,远小于 Qwen3.8-27B 托管版的 1M。
注意边界:这套基准是 PrismML 自测(EvalScope + vLLM/H100),第三方复现还需要时间沉淀。上线前用自己的任务集重测,没有商量余地。
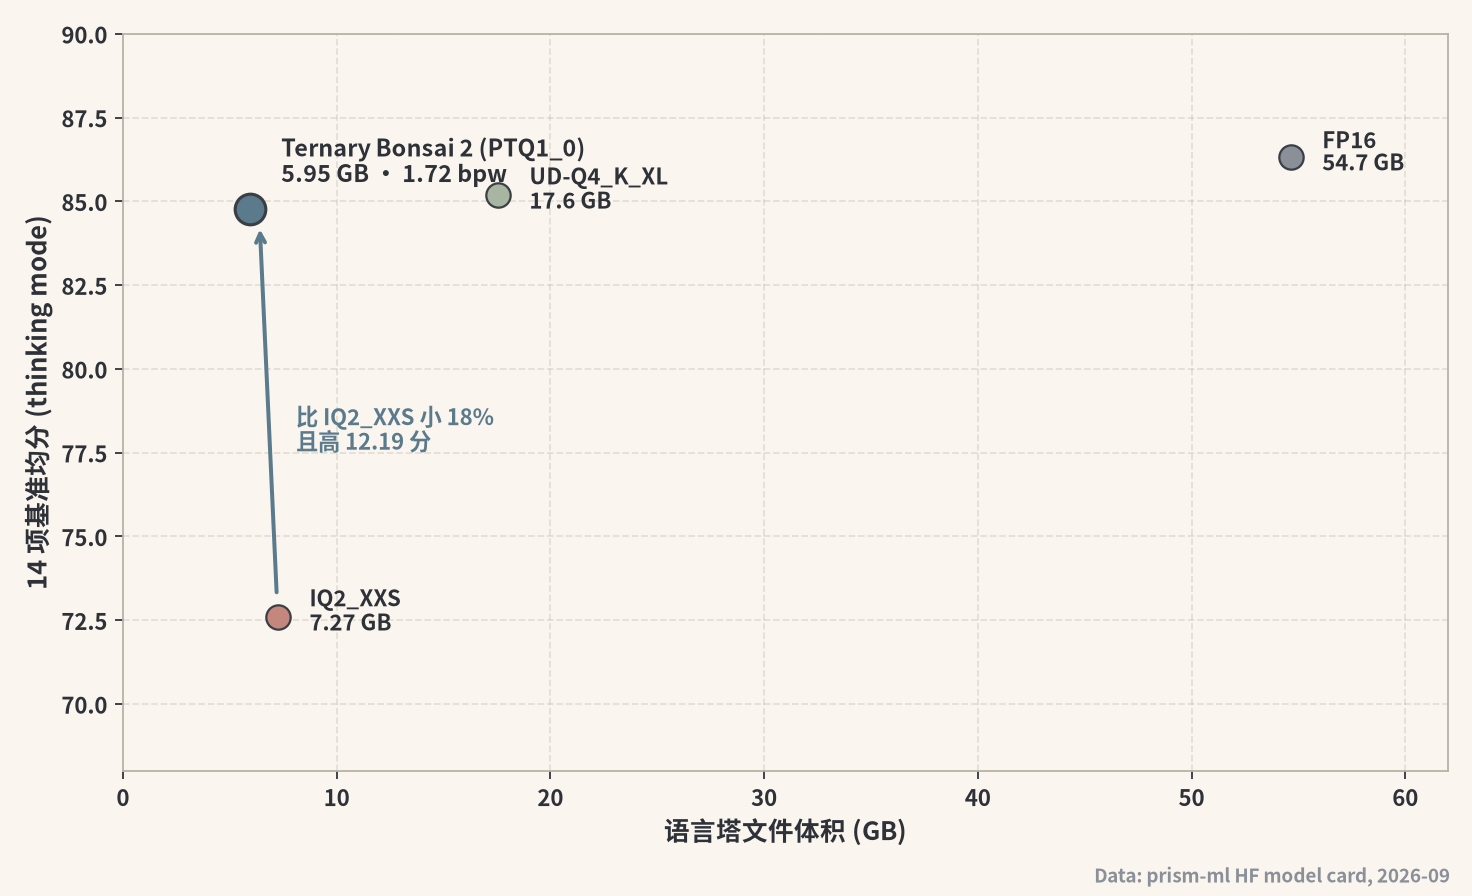
这张散点图是全文主张的核心:横轴体积、纵轴 14 项均分,数据全部取自官方模型卡。Bonsai 2 落在一个此前不存在的区域——比 IQ2_XXS 还小 18%,却高出 12.19 分;距离体积近三倍的 UD-Q4_K_XL(17.56 GB)只差 0.4 分。“更小且更好"在量化史上第一次同时成立,这才是它上 Hugging Face Trending 的原因。
你的卡该拉哪个包:PTQ1_0 还是 PQ2_0
同一个模型给两种 GGUF 打包,选错等于白亏一截吞吐。模型卡的 Cross-Platform Throughput 表(batch size 1、无视觉塔)给出了明确分工:
- H100 / A100 / Blackwell(HBM 大卡):选 PQ2_0。解码更快,且 prefill 在所有平台上都是 PQ2_0 占优——长上下文 Agent 首 token 延迟敏感的场合无脑选它。RTX 5090 上跑到 129.9 tok/s。
- Ada 代卡 / L4 / 内存紧张的机器:选 PTQ1_0(5.95 GB 那个)。在这批卡上解码反而反超 PQ2_0,RTX 4090 达 91.1 tok/s。
- 笔记本:官方给的参照是 M5 Pro 上 PTQ1_0 跑出 28.1 tok/s @ 34.1W(整机 CPU+GPU 口径,背景负载可致约 4% 波动,Apple 平台缺少独立的 DRAM 轨电能测量)。日常 Agent 对话够用,代码补全的体感也已经过了"等得起"的门槛。
一条可以直接抄的启动命令(从 PrismML fork 的 release 页下载对应平台的二进制后):
|
|
两个参数有讲究:-n 16384 是给 xhigh 思考链留的输出空间——这是个 reasoning 模型,采样上限给 256 token 会把思考过程拦腰截断,答案直接废掉;-c 32768 则是因为老脚本里的 -c 0(自动占满)会按 262K 全量分配 KV cache,直接把内存打爆,这个坑在官方 demo 仓库 README 里有明确记载。顺带一提,这模型不支持 low reasoning effort,配置里选了也近似 xhigh,token 成本要按最长思考链预算。
真正的账单:fork 锁定 vs $0.075/M
把话题从玩具评测拉回生产决策,桌上其实有两笔账。
第一笔:供应链赌注。 跑这个模型的前提是 PrismML 的 llama.cpp fork 持续跟进上游。评估它而不是喊"注意风险"的方法有三个:看配套仓库 Bonsai-demo 的活跃度(自称 source of truth,3.1k star、50 贡献者、最近一次提交 2026-09-24——发布三天内仍在动);看社区是否收录了你的硬件组合实测;以及最实际的一条——pin 住一个 known-good 版本的二进制,别让 CI 每天拉 latest,fork 项目的破坏性变更不会给你 deprecation 期。
第二笔:混合部署的分界线。 OpenRouter 已上架 prism-ml/ternary-bonsai-2-27b,输入 $0.075/M、输出 $0.50/M(访问日期 2026-09-27,下单前以实时页为准);同门 Qwen3.8-27B 托管版是 $0.10/$1.80。输出价砍到不到三分之一,意味着"迁回本地"这件事本身也有了比价基准:本地机器的真实成本 = 电 + 折旧 + 运维,折算到每百万 token 再和 $0.50 比。高频、短输出、隐私敏感的流量走本地;知识密集、超长上下文、多模态的长尾留在云端——反正那三类本来也不该迁。
这篇的结论浓缩成一句话:三值量化第一次让"本地跑旗舰"在经济和工程上同时成立,但它成立的边界(fork 锁定、知识塌陷、262K context)和它的卖点一样清晰。选型的人现在该做的不是惊叹,而是拿自己的任务集去测那 5.7 分的知识缺口会不会砸到你的业务上。
如果你的机器是 24GB 显存或 16GB 内存的笔记本,花二十分钟从 fork 的 release 页拉一个 known-good 二进制,按上面的速查表选打包格式,跑一轮自己的 eval——重点只看两类题:事实问答和数学。这两类的得分差,就是你这家公司的"能不能迁"判决书。