同事上周把一条「写完整迁移方案」的流水线切到 Gemini 4 Argon,配置里就改了一个数:max_output_tokens 从 32K 拉到 900000。他以为终于可以一句话让模型把十万行文档写完。
结果是任务在 6 万 token 处停了,日志里躺着 finish_reason=CONTINUATION,前面写的内容没丢,但也没回来。
这不是 bug。Argon 的「100 万输出」不是一个更大的单请求上限,而是一套跨请求的续接协议。 单请求默认只给 65,536 token(非流式直连 REST 只有 32,768),超出部分要靠客户端带着 continuation_token 反复重发原请求,一段段拼起来。这篇写给正在把 Argon 接进生产流水线的后端和 AI 应用工程师:要不要接、接了要改哪四处代码、以及为什么评估必须赶在 11 月 30 日之前。
百万输出是被切成段拼出来的,不是一次吐完
先纠正最容易错的那个心理模型。
官方开发指南里写着两个不一样的数字,而且都对:对外宣传的是 1,048,576 token 的能力上限,而单请求实际能产出的上限是 65,536 token(流式)/ 32,768 token(非流式直连 HTTP)。两者差着 32 倍,中间那座桥就是 long decode。
机制本身很直白。你把 max_output_tokens 设成大于 65,536,请求跑到单请求上限还没写完时,API 不会报错,而是返回:
finish_reason = CONTINUATION- 一个加密的
continuation_token,里面装着原始 prompt 的哈希和到此为止的生成状态
然后你带着这个 token 重发原始请求(注意:是原始的 contents、system_instruction、tools,不是把已生成的内容拼回对话历史),拿到下一段,如此循环,直到某次响应里不再有 continuation_token、finish_reason 变成 STOP。
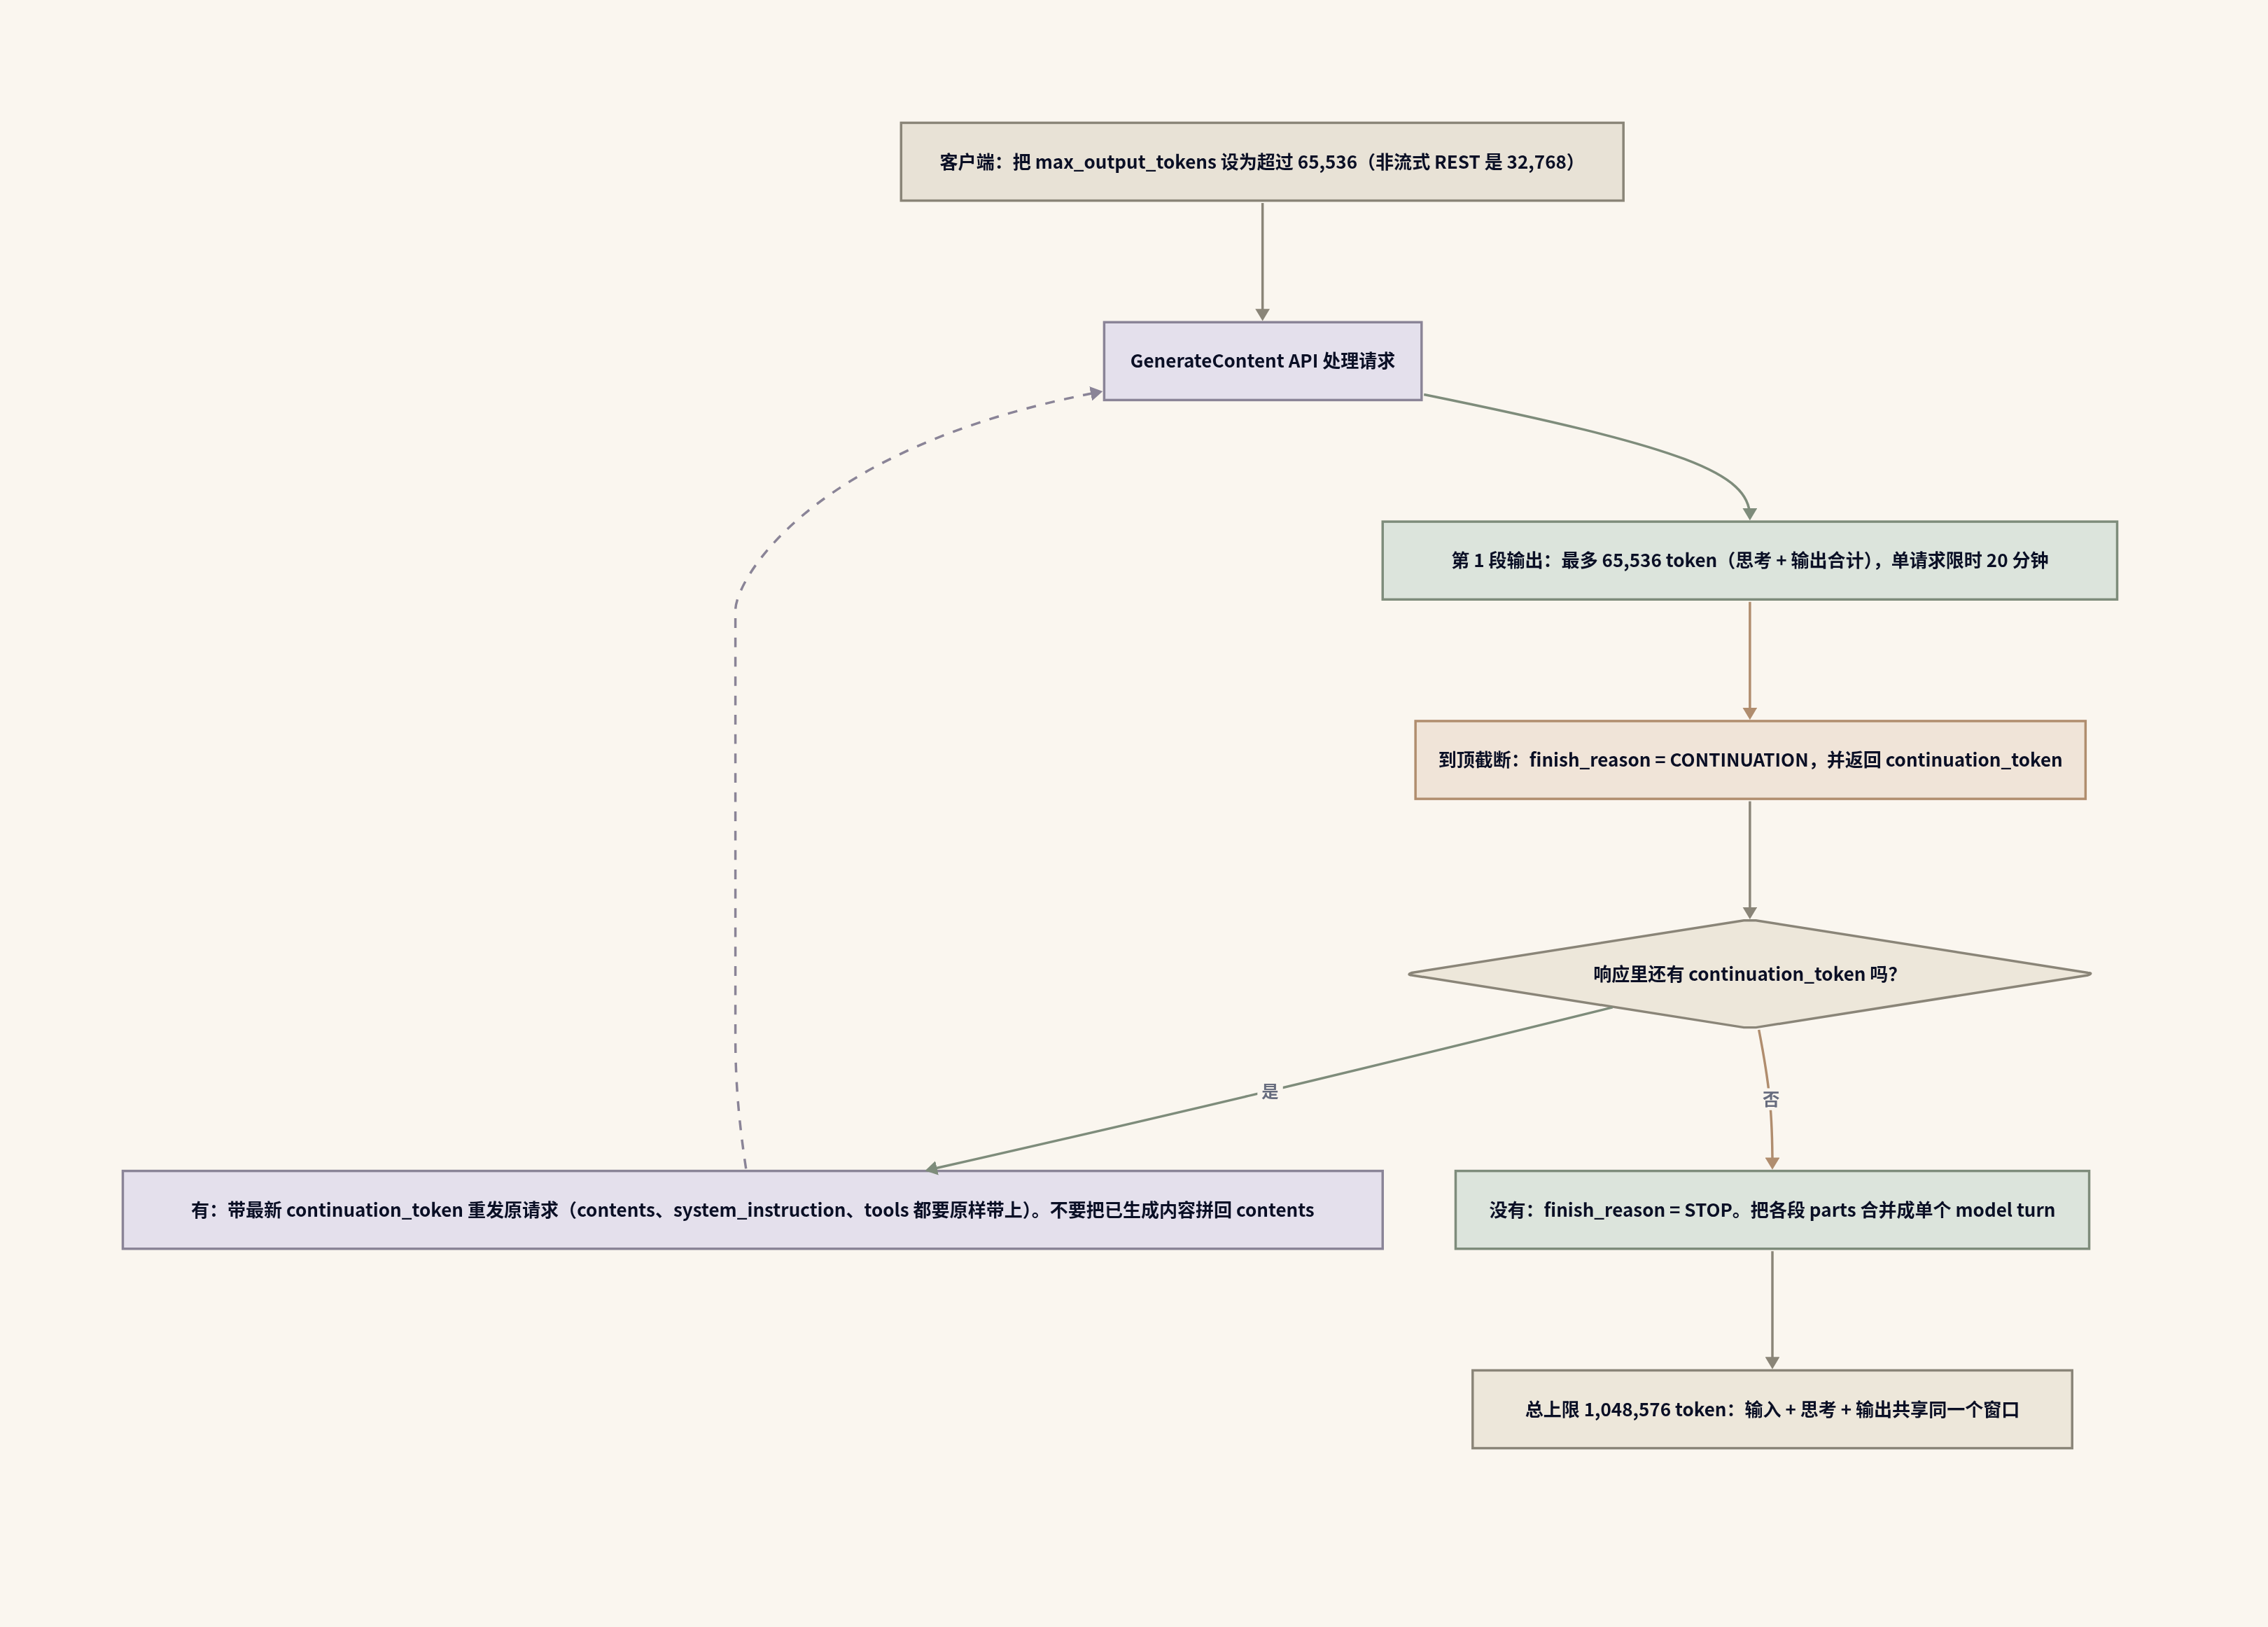
图源:依据 Google Cloud 官方 Developer’s guide 的 Long decodes 节文字描述自绘,2026-10-14 访问。
三个必须记住的硬约束:
- 每段都限时 20 分钟。 不是整个任务 20 分钟,是每一次请求 20 分钟。你的客户端超时如果设成「总任务 15 分钟」,长解码开到第三段就被你自己掐断了。
- SDK 版本有门槛。 Python 要
google-genai>=2.30.1(Go>=1.74.0,JS>=2.29.1)。官方明确写了:旧版 SDK 和 OpenAI 兼容层拿不回长补全——因为它们不认continuation_token。这是最容易踩的坑,你的迁移分支上大概率还锁着旧版本。 - 上限是共享的。 1,048,576 这个数字是输入 + 思考 + 输出共用一个窗口。你输入塞了 90 万,输出就只剩十几万。
「100 万输出」的真相是:它把一次生成拆成几十次请求,让你的客户端去当那个拼接的人。你不实现这个循环,那个数字对你就是零。
这一节的结论:这不是「把 max_tokens 调大」的升级,是「你的客户端要参与生成过程」的架构变化。没有续接循环的客户端,接 Argon 只会拿到一堆被截断的半成品。
续接循环会同时改掉你的超时账和 token 账
知道了循环长什么样,接下来把机制翻译成两个你运维面板上真实存在的数字:超时和 token 计数。这两个都会因为续接而变得反直觉。
超时不再是「一个 deadline」,而是「每段 20 分钟」。 如果你的 agent harness 用的是 requests 默认超时或一个全局 300 秒的硬 deadline,长解码任务一定失败——而且失败得很难看:前面几段已经生成、已经计费,任务却在中间被你自己判死。正确做法是把 deadline 挪到整个续接循环上,而不是单次 HTTP 调用;单次调用的超时按 20 分钟留余量。
更隐蔽的是 token 计数。 官方文档专门用一段警告这件事:
- 续接请求会把之前已经生成的部分重新 prefill 一遍,当成输入 token 计费。所以随着续接推进,
prompt_token_count会累积增长——它不是「你这次请求的输入有多大」,而是「到目前为止总共喂进去多少」。 - 官方原话是:不要用
prompt_token_count触发上下文压缩。很多 agent 框架的压缩逻辑就是「prompt 超过阈值就摘要一下」,直接照搬到 Argon 上,会在长解码跑到一半时被一个虚高的数字骗到,把上下文提前压缩,任务质量直接崩。 - 该读的是
initial_prompt_token_count(在usage_metadata里),它才是你这次请求真正的输入规模。 - 而且要等
continuation_token消失之后再压缩——生成没结束时动手,等于在别人写文章时抽走他的草稿。
至于钱:续接会把历史输出反复当输入 prefill,这是长解码的直接成本,不是意外。官方给的省钱杠杆是隐式缓存——请求背靠背跑、在 15–20 分钟的缓存 TTL 内,能吃到 95% 的输入折扣(缓存前缀要求 6,144 token 起)。所以同一个长解码任务的续接段之间不要插入别的工作,否则缓存 TTL 过期,你每段都在付全价。
排查路径记住三步:读 usage_metadata → 看 initial_prompt_token_count 而不是 prompt_token_count → 等 continuation_token 消失再压缩。
五个参数你带过来,不是报错就是被吞掉
从 gemini-3.1-pro-preview 迁过来的人,配置里基本都揣着这几个字段。Argon 的态度分两种:要么直接拒绝,要么静默无效。
静默无效(最危险,因为你不会收到任何信号):
temperature、top_p、top_k—— 后端直接忽略你传的值。你的 A/B 测试会得到一堆「设了不同温度但输出完全一致」的诡异结果,很容易误判成模型不稳定。
直接报 HTTP 400(这个至少会告诉你):
frequency_penalty、presence_penalty、candidate_countthinking_budget,以及thinking_level="MINIMAL"—— 官方明确说thinking_budget不再映射到思考档位,直接报错
已经不存在的能力:
- 显式上下文缓存(explicit context caching)不支持了。改成靠隐式缓存:把静态内容(system prompt、工具声明、长文档)前置到 prompt 开头,达到 6,144 token 就自动命中。这个改动不小——原来用显式缓存 API 管理生命周期的代码,整块要重写。
- 预填 model turn 不再支持,对话历史也不能以
model角色结尾。
推理深度改由 thinking_level 控制,三档:
LOW—— 分类、摘要、元数据抽取MEDIUM——gemini-4-argon的默认值,覆盖一般编码、工具调用、文档问答HIGH——gemini-4-argon-cyber-permissive的默认值,对应多文件软件工程、形式化证明、架构设计、漏洞挖掘
迁移清单可以直接拿出来对照改:升级 SDK 用错(旧 SDK 拿不回长补全 → 必须先升 google-genai>=2.30.1);删掉被忽略的温度参数(别再拿它调行为 → 该用 thinking_level 控制推理深度);删掉会 400 的参数(frequency_penalty / presence_penalty / candidate_count / thinking_budget);重写缓存层(显式缓存 API → 静态前缀前置,吃隐式缓存);清掉预填 turn 和结尾是 model 的历史。
静默忽略比报错可怕。报错你五分钟就改完了;静默忽略会让你花一周去查一个根本不存在的「模型不稳定」问题。
什么时候根本不该开长解码
上面讲的都是「怎么开」,但官方文档里最有价值的部分其实是那张「什么时候别开」的表——因为长解码被过度使用的概率远高于被漏用。
官方自己的判据,可以当决策表直接抄:
该开:
- 高难数学、科学、研究、形式化证明 —— 模型需要超过 65,536 token 去探索和检验推理
- 最难的编码与 agentic 任务 —— 有些任务确实需要一段响应里塞进 6 万 token 以上的思考和代码(官方补了一句:多数编码和 agentic 任务其实在 65,536 以内就结束了)
- 会被输出上限截断的评测 harness —— 防止模型把整段 65,536 预算全花在思考上、答案被切掉
不该开:
- 聊天、问答、摘要、分类、抽取 —— 这些任务远在 32,768 token 以内就完了
- 要求固定长度(比如「写一本 70 万字的书」)—— 官方原话是模型不遵守长度目标,你开多久都没用
- 多轮短工具调用的 agent —— 每一轮都很短,每轮的大输出会迅速填满那个共享的 1,048,576 窗口。这是最容易搞反的一类:你以为 agent 长跑需要长解码,实际它反而最不需要
- 输入已经接近 1,048,576 —— 输出能用的余量 = 上限 − 你的输入,输入占满了,长解码没有空间可开
- 延迟敏感请求 —— 官方直言长解码可能跑好几分钟
有一句话我认为是整篇文档里最重要的,值得单独拎出来:
长解码给的是「推理空间」,不是「更长的答案」。想控制答案长度,用的是别的旋钮。
换句话说,你为一个「输出 100 万 token」的营销数字付出的复杂度(续接循环、累积计费、缓存 TTL 管理),只有在「模型真的需要更多 token 想清楚一件难事」时才回本。用它来批量生成长文本,你买到的是账单,不是结果。
这一节的反例:把长解码当成「更可靠的自动化」是方向性错误。上下文越长,成本、延迟和错误累积越难控——续接段数越多,中间任何一段失败都要整条重来,而前面每段都已经计过费了。
11 月 30 日之前,这次评估要按标准价预算
最后一个决策点是钱,而且它有截止日期。
Argon 现在跑的是引入价:$2 / 百万输入 token、$10 / 百万输出 token,官方博客写明优惠到 2026 年 11 月 30 日。之后恢复标准价 $4 / $20——单价直接翻倍。
这里有个容易写错的细节,我特地回官方原文核了一遍:官方博客只写了 cached input tokens priced at 95% off,没有给出缓存输入的具体美元单价。网上流传的「$0.10/百万」是按 $2 × 5% 推出来的算术结果,不是官方标价。你要拿这个数字做预算,得自己标清这是推算值。
所以现在到 11 月 30 日这段时间,做评估有个明确的算术优势:同样的工作负载,现在跑一遍的钱是以后的一半。 具体动作:
第一,用真实工作负载在窗口内跑一遍,而不是跑 benchmark 样例。要记的四个数是:每个任务的中位 token 消耗、上下文耗尽率、工具调用成功率、以及缓存命中后的真实单价。这四个数决定了你接不接。
第二,把成本按标准价外推一遍再决策。 引入价下「划算」的结论,在 12 月 1 日可能反过来。如果一项工作负载在 $4/$20 下算不平账,那它就不是「限时薅羊毛」的机会,是「根本不该上」。判断线很简单:按标准价算,每任务的产出价值能不能覆盖它的 token 成本。
第三,注意续接的隐性成本:思考 token 计费、grounding 时内部工具指令与函数声明也计费、以及前面说的「历史输出反复 prefill」。按官方价目表推演一遍你的长解码任务——这不是实测,是根据官方定价页做的算术,但足以让你看清量级。
11 月 30 日不是一个营销日期,是你评估窗口的截止线。过这条线,之前算平的账要重算一遍。
结论其实只有一句:Argon 的「1M 输出」是一个需要你的客户端配合的协议,不是一次配置改动。 所以在切生产流量之前,先跑一遍这四处,都不用写生产代码:
- 在迁移分支上 grep 五个词:
temperature、top_p、top_k、thinking_budget、frequency_penalty。前三个会被静默忽略(你以为在调参,其实没生效),后两个会直接 400。这一条查下来,你会知道自己有多少「以为在生效其实没有」的配置。 - 量一次你自己的最长任务:把它拆成几个 65,536 的段,看看需要几轮续接、几轮乘上 20 分钟,你的超时设置扛不扛得住。
- 检查 SDK 锁的版本:
google-genai>=2.30.1(Go>=1.74.0)。低于这个线,长补全根本拿不回来,而且是静默拿不回。 - 拆一次上个月的账单:把最贵的那个长文本任务挑出来,分别按 $2/$10 和 $4/$20 算两遍。第二遍的数字才是你 12 月之后要付的。
四处里任何一处对不上,就先别把生产流量切过去。这个数字很大,但它给你的不是更大的桶,是一根需要你自己一节节接起来的管子。