你给 agent 挂了一个逆向工程 MCP,207 个工具,装完也就 25MB。你随口问一句"OK 收到了吗",它回了个 OK。
这一轮对话,上下文里塞进了约 40 万 token。按作者自己的账,这一句 OK 花了 1.6 美元。
这个场景出自 leanrea 的基准测试。它是一个 8KB 的 SKILL.md,不装 MCP、不注册任何工具,只是告诉模型"这类目标该用哪条命令、要避开哪些坑",然后让 agent 自己敲 Bash。作者拿它跟 REA(Reverse Engineer Anything,一个把 asar、otool、nm、jadx、Ghidra 打包成 MCP 的逆向工具集)正面对比:36 次运行,总墙钟时间少 38%、成本低 35%、轮次少 56%。
这套数字最近被转得到处都是。但我把仓库里的 bench/results/final.jsonl 拉下来,36 条原始记录逐条重算了一遍,看到的结论比"skill 打败 MCP"要窄,也更有用。
真正决定成本的不是工具条数,是工具定义有没有一次性塞进上下文。 而 skill 方案在四个测试任务里只赢下了一个,另一个还输给了什么都不装的裸模型。
写给正在给自研 agent 平台做 tool 层取舍的人。
那 40 万 token 来自一个环境变量,不是来自 REA
先把最容易被误传的数字钉住。
leanrea 仓库的 bench/BENCHMARK.md 里有一张「Context overhead」表,测的是同一句 Reply with exactly OK. 在不同配置下的上下文占用:
- 什么都不加载:31.4k token
- 调用 leanrea skill:34.5k(+3.1k)
- REA MCP,按需检索开着(Claude Code 的默认行为):34.9k(+3.5k)
- REA skill 和 MCP 同时启用:42.7k(+11.3k)
- REA MCP,把
ENABLE_TOOL_SEARCH设成 false、207 个工具全部加载:400.7k(+369k)
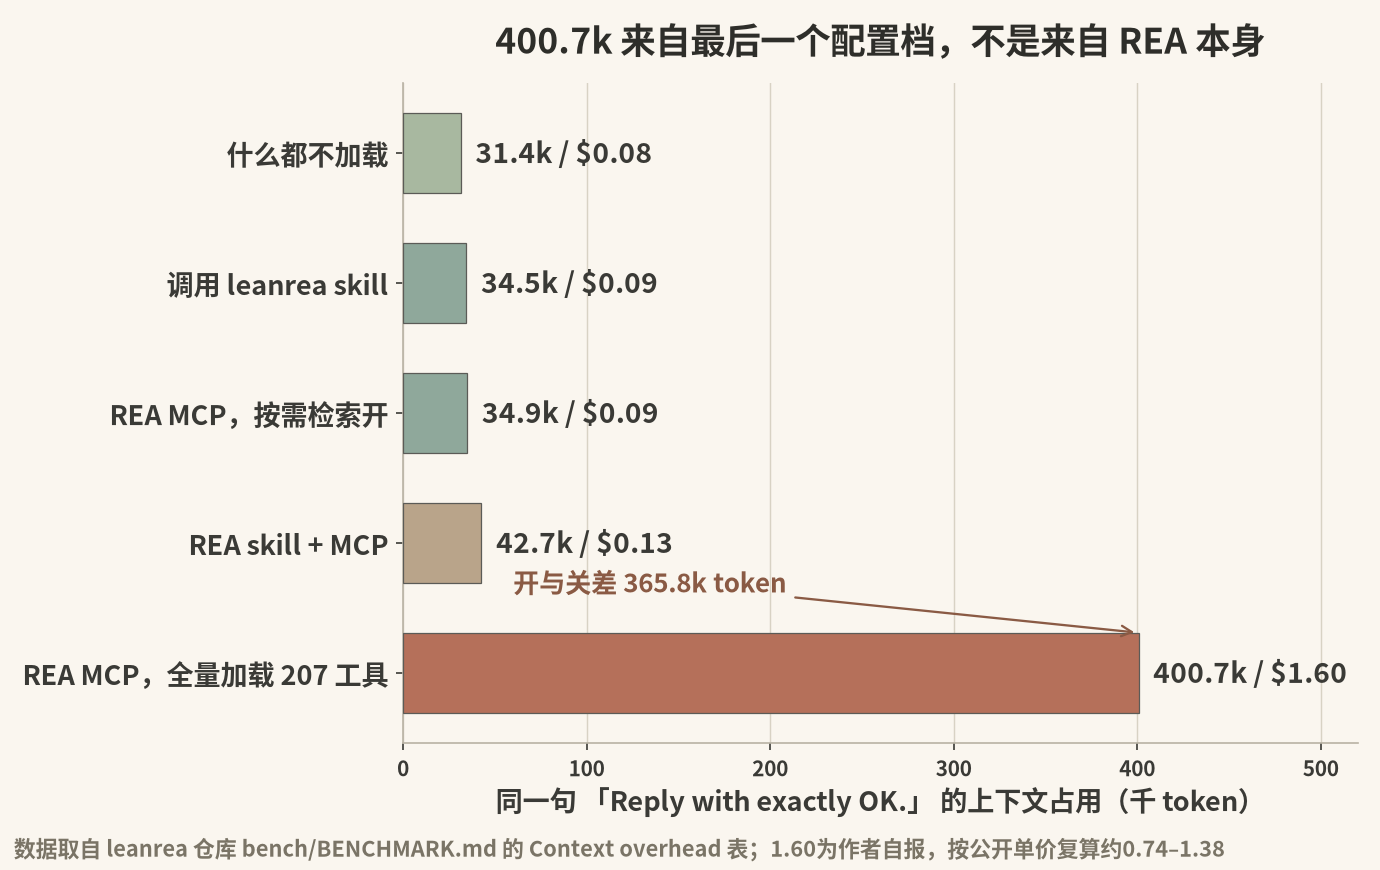
同一个 MCP server,开不开按需检索,差了 365k token。这个开关在 bench/ctx.sh 里就是一行环境变量,命令是 ENABLE_TOOL_SEARCH=false claude -p ...。
所以第一件事要说清楚:REA 的默认用法并不贵。 在 Claude Code 里跑,它只多占 3.5k,比一份 8KB 的 skill 文档(3.1k)多 400 token。把"400k"当成 MCP 的原罪,是拿一个被人为关掉的开关去给整个协议定性。已经有英文媒体把这笔账写成了 160 美元(原文是 1.6 美元),这种数字在传播里只会越滚越离谱。
那 3.35MB 是真的吗?是真的。仓库自带一个 bench/mcp_list.py,走 MCP 协议拉一遍 tools/list,把 207 个工具的定义全序列化出来量体积——其中输入 schema 占 745KB,输出 schema 占 2.46MB,描述文字占 90KB。输出 schema 占了七成多,这一条后面有用。
按这张表反推,3.35MB 对应约 369k token,大致是每 KB 工具定义吃掉 108 个 token。这是个粗略的量级,但足够你在自己平台上做估算:把 MCP server 的 tools/list 响应体存下来看字节数,除以 1024 再乘 108,就是"全量注册"这一档要付的上下文税。
这里得留一句话。1.6 美元这个价格我复算不出来:369k token 按 Sonnet 的公开单价,2 美元/百万算是 0.74 美元,3 美元/百万算是 1.11 美元,就算加上 1.25 倍的缓存写入也才 1.38 美元。这个数只能算作者自报,不能当成可复现的报价。但差个两三成不影响结论——这一档的代价就是几十万 token 的量级。
把 36 次运行按任务摊开,胜场只剩一个
总表很整齐:leanrea 388 秒 / $2.17 / 55 轮 / 2.40M token / 74 分;裸模型 479 秒 / $2.21 / 81 轮 / 3.11M / 67 分;REA 627 秒 / $3.36 / 124 轮 / 5.93M / 75 分。
但四个任务的性质完全不一样,混在一起算总账会掩盖掉真正的分界线。我从 final.jsonl 里按任务取中位数重算了一遍:
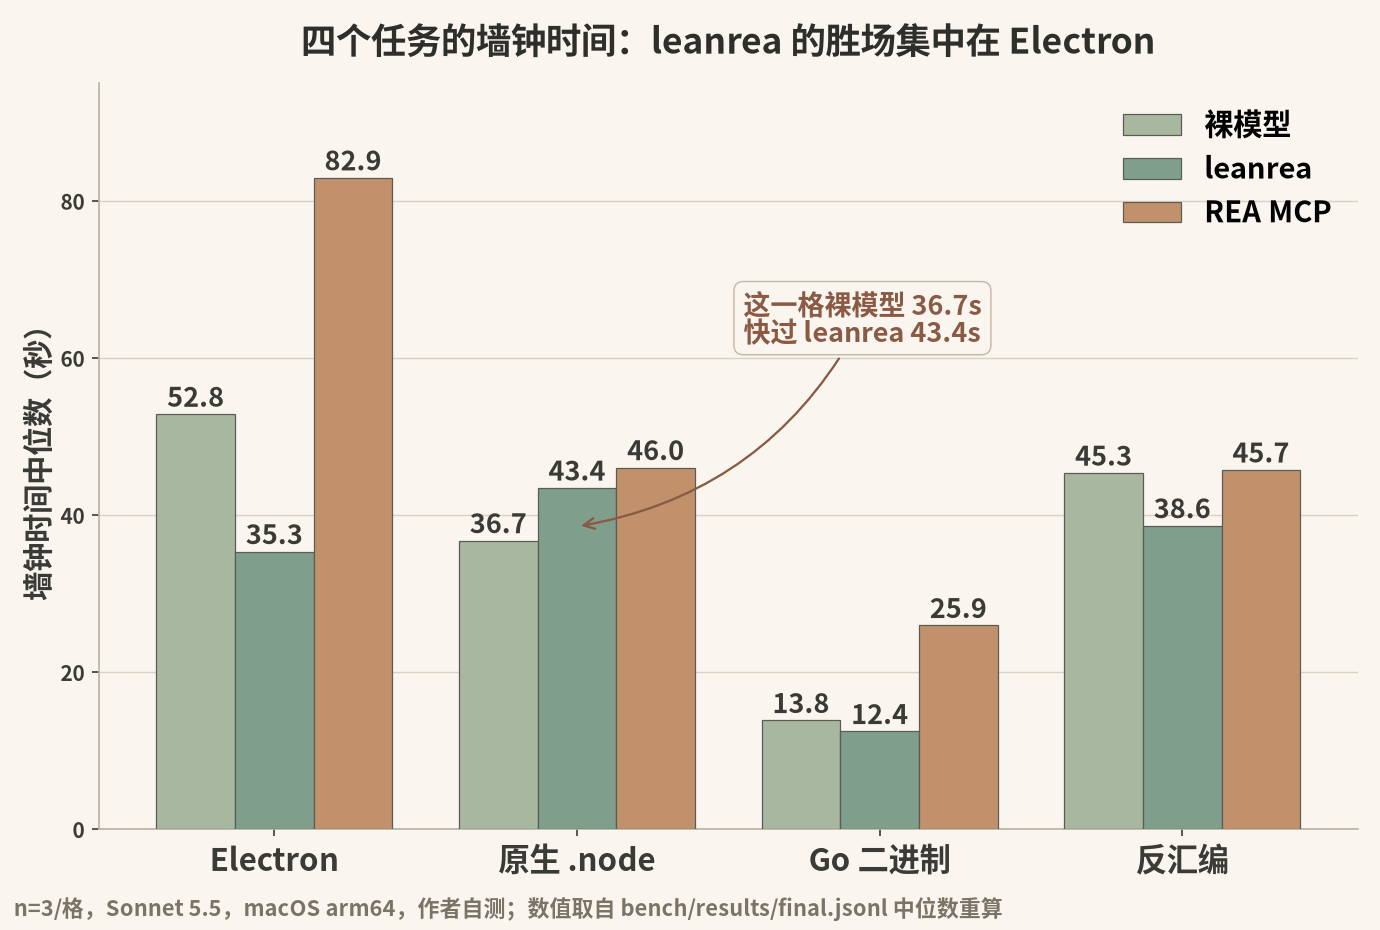
- Electron 任务(从 Notion 的 app.asar 里追出麦克风/会议检测的原生函数、类、IPC 通道):leanrea 35.3 秒,裸模型 52.8 秒,REA 82.9 秒。这一格 leanrea 比 REA 快 57%。
- 原生 .node 任务(导出表、TCC 权限检查、单实例锁):裸模型 36.7 秒,比 leanrea 的 43.4 秒还快,REA 46.0 秒。三组答案都是满分 24/24。
- Go 二进制任务(
gh的工具链版本、主路径、两个依赖版本):leanrea 12.4 秒,裸模型 13.8 秒,REA 25.9 秒。但成本上 leanrea 每跑 0.11 美元,裸模型 0.09 美元——这一格 skill 反而更贵。 - 反汇编任务(只看汇编写出 socket 路径格式、线协议、对端认证):leanrea 38.6 秒,裸模型 45.3 秒但有一次拒答只拿 16/24,REA 45.7 秒。
总账上 38% 的时间优势,几乎全部来自 Electron 这一个任务。 原生任务上它输给了什么都不装的裸模型,Go 任务上和裸模型基本同时到、但更贵。
这不是说作者数据造假——他自己在 README 里就写了"模型本来就很擅长这些,leanrea 相对裸模型的提升(约 19% 更快)比对 REA 的提升小得多”。但传播的时候,这层意思被 38% 这个数字盖掉了。
还有一条边界必须放在这里,因为 BENCHMARK.md 的 caveats 自己写了:REA 那一组跑的是 Claude Code 的延迟工具检索,也就是"REA 的最佳情形"。换句话说,上面这个 38% 已经是给了封装层一个有利条件之后的数字;真把 207 个工具全量灌进上下文,REA 那一列的墙钟和成本只会更差,不会更好。这个方向的结论对你更有利,但它也说明:这类对比里,配置比阵营更能决定输赢。
为什么会是这个结果?回到上下文:Electron 那一格最容易翻车的地方在于,bundle 里的代码被 webpack / Vite 藏在 .webpack/、.vite/ 这类点目录下,而 rg 默认跳过隐藏文件和 .gitignore 里的路径。裸模型顺手 rg 'ipcMain' 搜不到,就在那反复换关键词;REA 那边则要先走 analyze_javascript_application,asar 完整性校验不过就直接报 artifact_integrity_mismatch,得加 --integrity-policy record-and-continue 才继续往下走。
SKILL.md 里恰好管的就是这一类坑。它第 13 行写着:「rg 跳过隐藏和忽略文件,打包器会把代码藏起来(Electron 的 .webpack/、.vite/),永远用 rg -uu 搜解包出来的树。」一句话,把某个具体任务上的失败模式给堵住了。
skill 的收益是场景相关的,不是能力相关的。 它在"模型知道该用哪个工具、但不知道这个场景的坑"时最值钱。原生任务这种 otool、strings、nm 一条道走到黑的活,模型本身就很熟,塞一份文档进去只是多了几千 token 的阅读成本。
8KB 的文档换掉的不是工具,是"选哪个工具"这一层
leanrea 的 SKILL.md 我完整读了一遍,8374 字节、66 行。它的结构是这四块:
- 7 条规则:先在副本上干活(APFS 上
cp -c是秒完的)、先按file -b和 magic bytes 路由再解包、别cat大文件要切片、把独立探测合并成一次 shell 调用、结论必须标 seen / inferred / unknown。 - 一张 17 行的路由表:左边是目标类型(Electron app、压缩过的 JS bundle、Hermes、Mach-O、ELF/PE、Go、Rust、.NET、APK、Flutter、WASM、SQLite、plist、pcap、固件、网站、运行中的进程),右边是这个类型最快的路径。
- 两组 first-move:Mach-O 和 Electron 各一条"粘贴即可执行"的大命令,一次把清单、导出、导入、字符串、反汇编全 dump 下来。
- 速度模式:先用字符串和导入表,再顺着 otool 的 literal pool 注释反查函数,比 diff 代码先 diff 清单。
看完就明白了:这 8KB 替代的是 207 个工具里"选哪个"这一层,不是"能不能做"这一层。 REA 底下调的本来就是 asar、otool、nm、jadx、Ghidra 这些命令行工具,模型通过 MCP 拿到的是封装好的参数和结构化输出;leanrea 把封装拆了,换成一份"哪条命令最快、哪个坑要躲"的备忘。
这也解释了 README 里那张单操作对比表为什么差那么多:同一个操作,REA CLI 分析 Electron 应用要 47.9 秒、吐 140MB JSON(还得先加参数绕过完整性校验),而 asar extract 加 rg -uu 是 4.8 秒、24KB。封装层不是免费的,它的结构化输出在"给模型看"这件事上往往比原始命令更啰嗦。
顺带说个容易被忽略的细节:REA 自己也维护着一份 skill(23.5KB 的说明加 48.8KB 参考文档),MCP 之外还挂了一层。也就是说这场对比里,一边是"skill + MCP",一边是"更短的 skill"。这更像是"文档写多长、封装做多厚"的取舍,不是"要不要协议"的取舍。
32K 窗口的本地模型,这里没有取舍只有天花板
上面那些百分比都建立在 200k 上下文、一个主力模型的基础上。换个场景,问题性质就变了。
REA 仓库的 Discussion #3098 里,有人用一张 12GB 显卡跑本地 Qwen3.8-27B(32K 窗口,llama.cpp + OpenCode)驱动 REA,三个配置的结果是这样的:
- 全量 206 个工具:prompt 248,762 token,直接被拒答——32K 窗口装不下。
- 砍到 62 个工具(
session,direct家族 + 压缩 schema):prompt 28,628 token,光读 prompt 花了 12.7 分钟,随后显卡重置,没有答案。 - 再加一层 10 个工具的 allowlist:prompt 4,407 token,3 次全部答对,每次约 80 秒、四次调用。
注意第二档:28,628 token 勉强塞进 32K 窗口,但推理慢到显卡自己崩了。在小窗口上,上下文占用不只决定钱,还决定"跑不跑得动"。
这一档的解法在客户端,OpenCode 的 tools map 里先把 rea_* 全关掉、再逐个打开需要的那几个:
|
|
另外有个细节值得记住:这个讨论里作者按模型自己的 tokenizer 数了一遍,光是 session 这一族 21 个工具就占 26,972 token(压缩 schema 后 15,489),其中 4 个对比类工具占了一半以上。也就是说,想"打开一个二进制看看",在任何配置下都至少要付 15k token 的入场费。
不过要克制一点:这是单一模型、单一 prompt、单一目标,而且依赖一个还没合并的 PR #3026。讨论作者自己在"没跑的"一节里写了:「三次走同一条路径,不等于三份独立证明。」把它当成"小窗口下的可行路径"可以,当成"MCP 超过 N 个工具就该换掉"的阈值不行。
真正有官方口径的是 Anthropic 那篇 advanced tool use 的工程博客:58 个工具约 55k token 是它举的典型例子,它自己内部见过 134K token 的工具定义;给工具打上 defer_loading: true 之后,上下文从约 77K 降到约 8.7K,Opus 4 在 MCP 评测上从 49% 升到 74%,Opus 4.5 从 79.5% 升到 88.1%。它给的适用条件是"工具定义超过 10K token、工具数 10 个以上、出现选错工具的情况",并且在工具少于 10 个、或每个会话都要用满全部工具时明确说收益更小。
注意这两套口径不能合并:一个是 32K 窗口的本地小模型,一个是 200k 窗口的旗舰模型加官方实现,中间差着两个数量级。它们共同指向的只有一件事——工具定义是一次性进上下文还是按需进,这一层的开关比"站在哪一边"重要得多。
什么时候你必须留着这层封装
写到这里,如果结论停在"skill 更省",那就是帮读者做错决定。把封装拆掉是有代价的,而且代价不在 token 账单上。
我第一次看到这个对比时最想不通的是:既然裸命令又快又便宜,作者为什么还要写 REA 这样一套东西,207 个工具、25MB 包,养着一个常年维护的项目?
答案在 README 那张对比表的最后一行,也是 leanrea 自己承认没碰的部分:**REA 装的是 207 个工具的契约,leanrea 装的是一句话"用哪条命令最快"。**前者能保证输出的结构,后者只能保证模型知道该干什么。
具体到工程上,下面四件事只要有一件成立,就该把这层封装留着:
- 执行要确定性,不能让模型自由拼 shell。 结构化的入参校验、合法的输出 schema,是给下游代码消费用的。leanrea 把执行权交给了模型直接写命令,
rg -uu -o的引号拼错一次,这一轮就白跑了。 - 需要沙箱和最小权限。 MCP 能按工具粒度授权、能把某几个工具挡在外面;给模型一个 Bash,等于给它整台机器的权限。leanrea 自己的规则第一条就是"先在副本上干活",因为不这么做,模型一次手滑就能改掉原文件。
- 要留审计痕迹。 谁在什么时候调了哪个工具、带了什么参数,走 MCP 是天然可记的;走 Bash 就只能去翻 shell 历史。
- 多客户端要复用同一套接口。 Claude Code、Codex、Cursor、OpenCode 全都接 MCP,一份 server 四处能用;而 skill 文件在每个客户端的加载方式、优先级、可用工具都不一样。
反过来,如果工具在机器上本来就有、失败了能重跑、也不需要审计——那么这一层封装就是在为"确定性"付一份用不上的保险费。Electron 那格的差距就摆在这里:封装层比原始命令啰嗦了一个数量级。
还有一层反例得摆出来:这个基准里 Ghidra、Hopper、IDA 都没装,两个对照组的原生任务都退回了 Xcode 那套工具。所以"重反编译"这种真正需要专业工具的活,谁更强根本没测。作者那台机器上的 Electron 任务也得加 --integrity-policy record-and-continue 才跑得动,说明封装层在某些环节上是负担,在另一些环节上是唯一能过完整性校验的路。
先量一次 tools/list,再把账单拆到小数点后一位
这套数字我复现不了——没有那台 Mac,没有 Notion 的包,也没有 REA 的账号。但下面三件事你今晚就能在自己平台上做,成本是几分钟:
量一次工具定义的体积。 你的 MCP server 拉一遍 tools/list,把 JSON 序列化后看字节数。leanrea 的 bench/mcp_list.py 就是干这个的,逻辑很短:走 MCP 协议 fetch 全部 tools,json.dumps 一遍量长度。按 108 token/KB 估,你就知道自己平台的"全量注册"这一档是多少 token——我的经验是多数人第一次量完都会发现输出 schema 是大头。
拆一次账单,看到小数点后一位。 leanrea 里最有信息量的数字不是 38%,是 Go 任务上 leanrea 0.11 美元对裸模型 0.09 美元。总账便宜,分任务贵,这种事只有拆到底层才看得见。把你最近一周的 agent 调用按工具/任务分组,看哪些格子里"更聪明的那套"其实更贵。
确认那个开关是不是开着的。 如果你在 Claude Code 里挂 MCP,先看一眼 ENABLE_TOOL_SEARCH 有没有被谁设成 false;如果是自研平台,检查你的工具注册逻辑是默认全量进 prompt,还是先给一份名字列表让模型搜。这一行的差别是 3.5k 和 369k。
三件事做完,你手里就会有自己的一行数据。三十几个转发里没有人给你的东西,是你自己的那个数。