十月中旬这几天,Anthropic 开不开源 Scion 这件事,被传播读反了两次。第一次是"Git 要完了",第二次是"Anthropic 开源了 Scion"——两条都不对。官方工程博客的原话是 Scion is by no means a suitable replacement for git for general use,而那个 24 小时内冒出 695 star 的 Go 仓库,作者署名 feder-cr,是自己看着博客复刻的第三方实现。
本文写给正在把 coding agent 接进 CI/CD、或者维护着中大型 monorepo 的后端和平台工程师。结论先说:99% 的团队今天不该换 VCS,但应该这周就去量自己仓库的两个数。
崩掉的前提不是"用 Git",是"每个 client 都得持有一整份仓库"
Anthropic 官方博客给出的数字是:2026 年 5 月平均每天合并约 2,500 处变更,到 9 月超过 30,000 处,四个月涨了十倍以上。主分支历史接近 100 GB,压缩后的工作副本仍然超过 25 GB,仅 CI 每天就有约 2,500 万次代码检出——按朴素拉取折算,一天超过 600 PB 的 Git 流量。
这些数字容易让人得出"Git 不行了"的结论,但博客里其实把原因写得很清楚:Git 是去中心化设计,每个 clone 都是完整自包含的仓库,能离线算 diff、读 history 和 blame、检出任意 revision。对绝大多数仓库,这正是对的设计,也是它成为标准的原因。
问题出在负载形态变了。Anthropic 自己复盘时说得很直接:他们像大多数公司一样,把 Git 当集中式系统用、只有一份权威副本,但几乎所有 client 都是 agent 和 job——而这些东西定义上就是在线的。于是"为分布式离线场景服务的优秀特性",在仓库变大之后反过来成了负担。
他们在峰值时运营了几百个内部 Git 镜像,还用 blob storage 存仓库快照做种子。这些手段买了时间,但随着 merge 速率上升越来越难运营:种子刷新一次就离 main 尖端更远,而且要让 diff、blame 这类依赖历史的操作在 partial clone 上正常工作,需要的照料越来越多。
用 Anthropic 官方的话说,真正的错配是这句:客户端几乎永远在线,Git 最擅长的离线分布式能力成了纯负担。
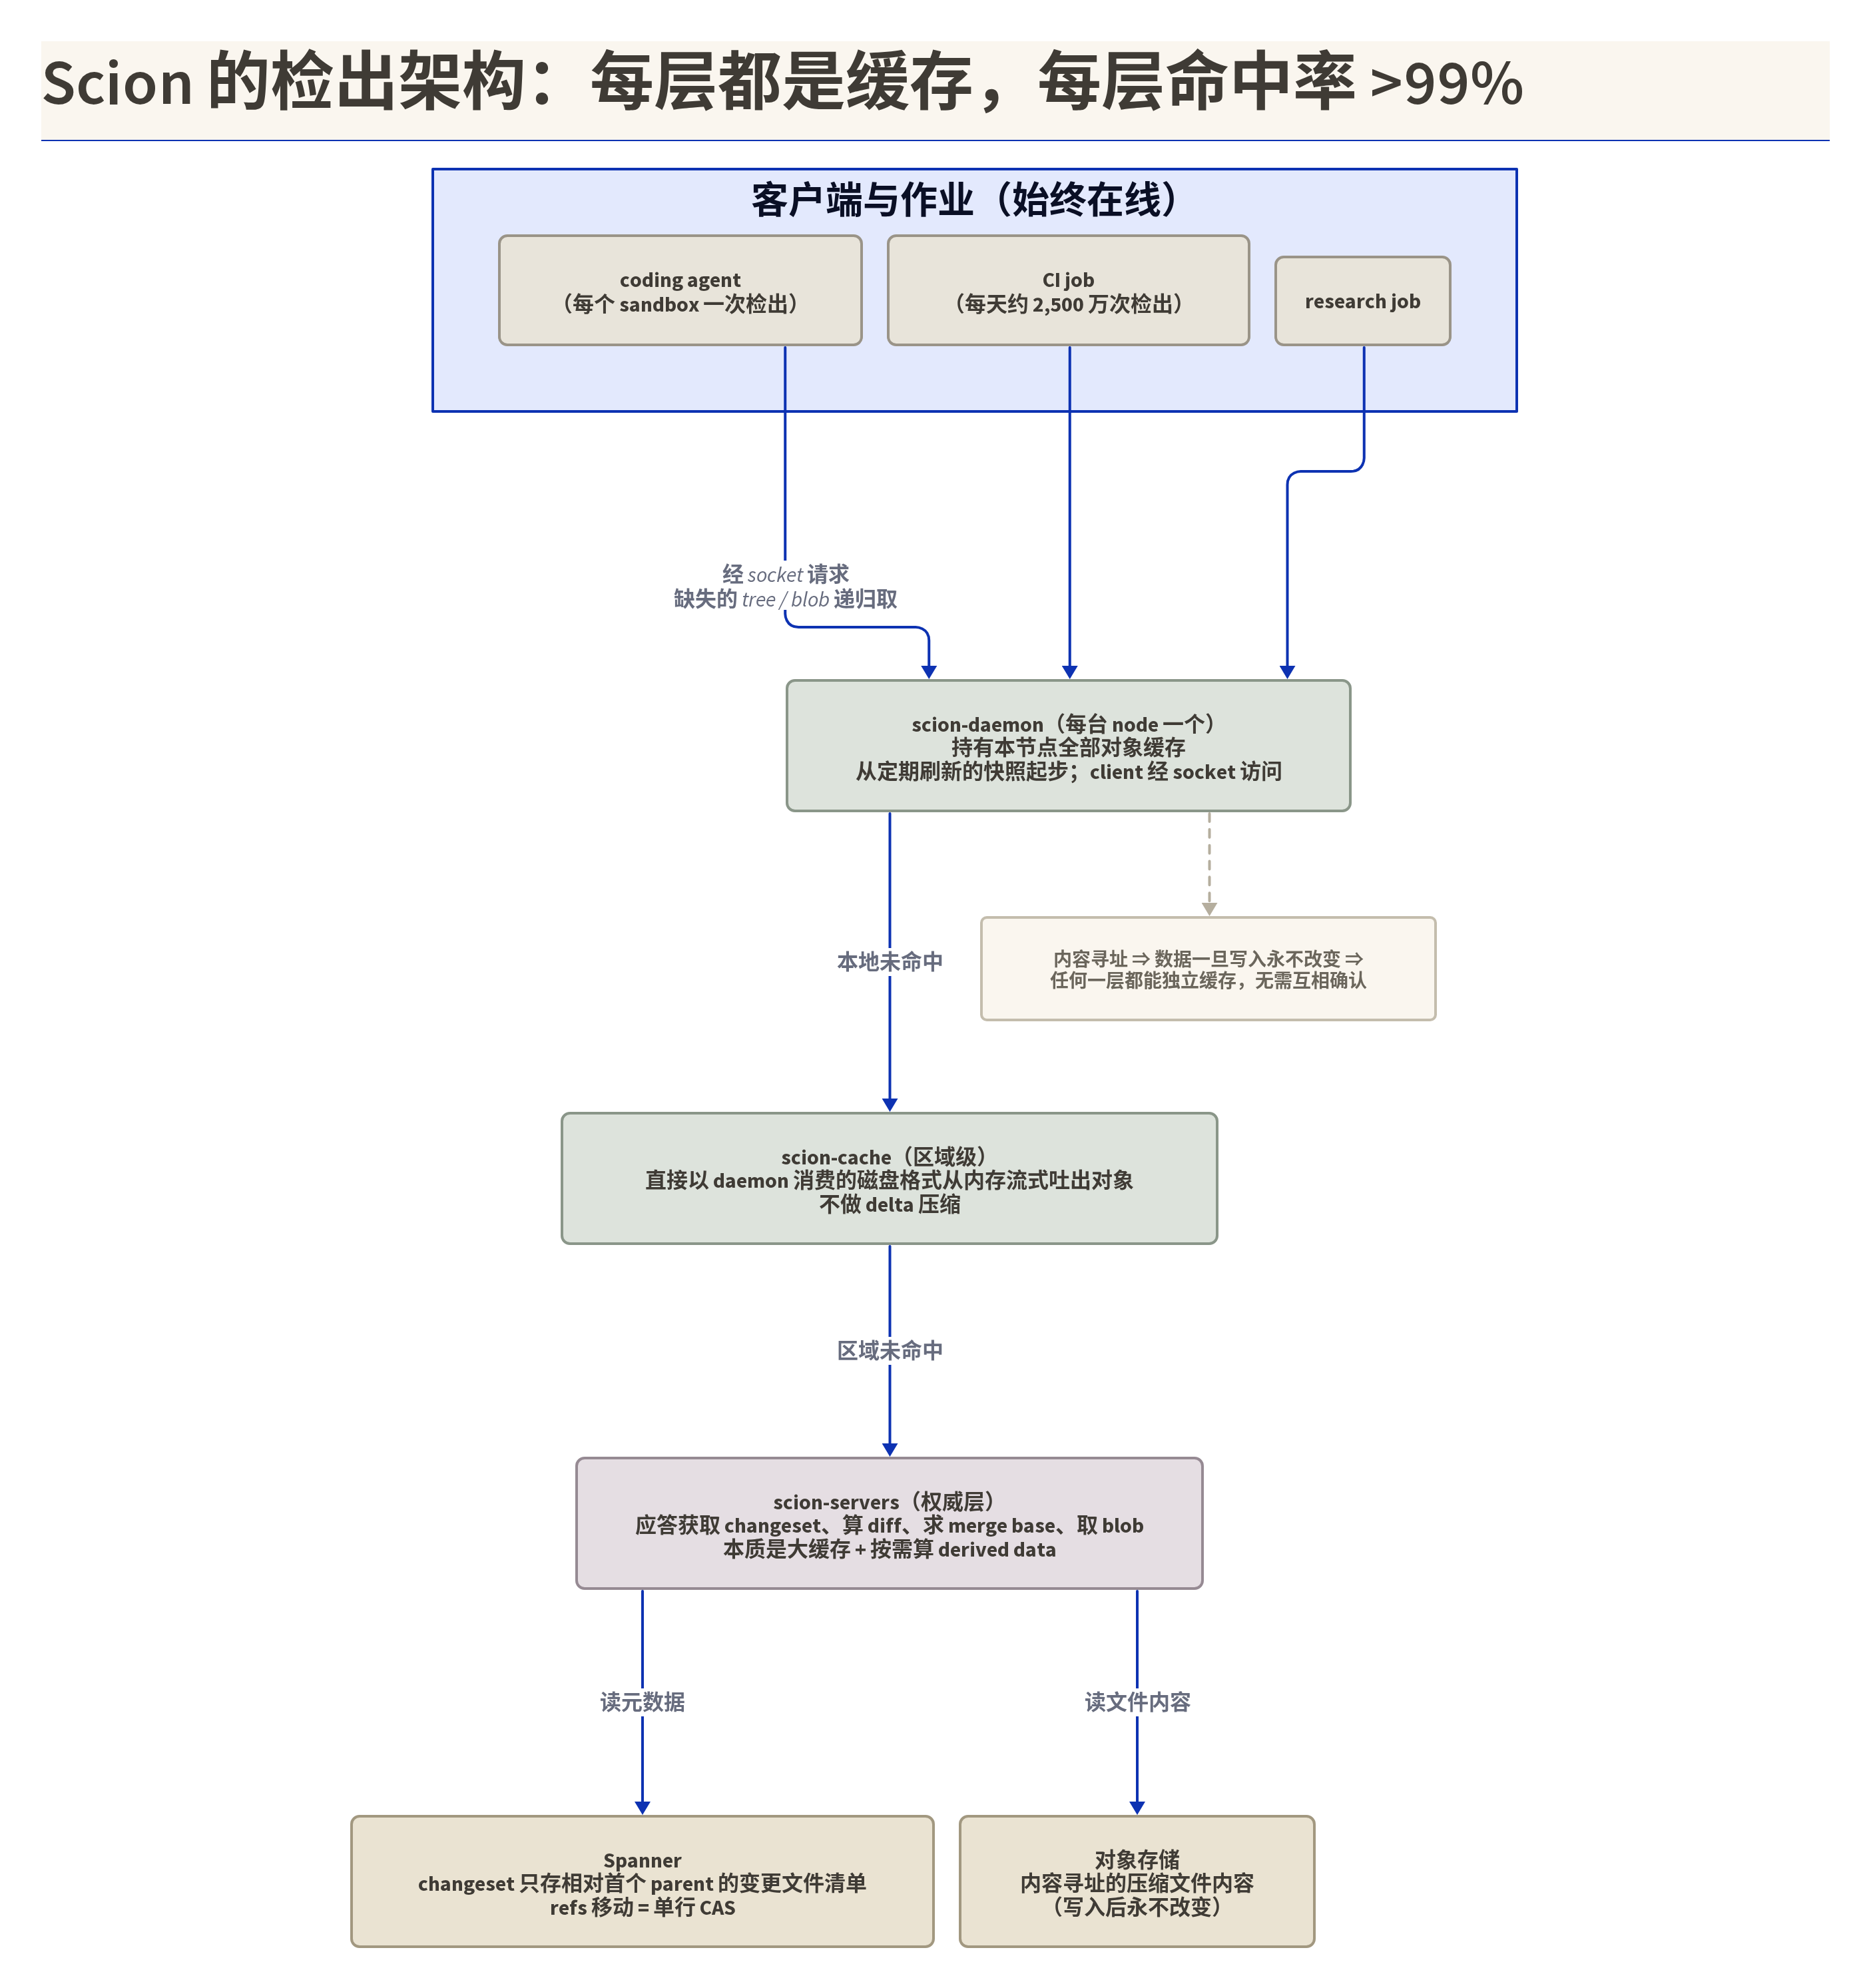
三层架构对应官方博客描述的 scion-daemon / scion-cache / scion-servers,数据来源:Anthropic 工程博客《Redesigning source control at Anthropic》。
该抄的是"把工作挪到服务端"这个判断,而不是 Scion 本身。
六条设计原则里,你能拿走的只有三条半
Scion 的设计原则在官方博客里列了六条。把它们逐条对着自己的仓库读一遍,会发现里面其实混着两种东西:一种只和"你有个巨型 monorepo"有关,另一种和"你的 client 是在线 agent"有关。后者才可能迁移。
先看能拿走的:
服务端 API 替代"clone 下来自己算"。 官方原则里最实用的一条是:Git 下,一个 CI job 想回答"谁最后改了这行"或"这两个 commit 什么关系",必须维护一份本地仓库,或者指望厂商 API 恰好提供答案;Scion 里客户端用到的所有查询都同时通过 API 暴露,很多场景下 job 根本不需要本地仓库。Anthropic 说他们的自动 bisect 和 revert 流水线在规模化下离不开这种廉价的程序化访问。对你不换 VCS 也能做——现在各家 forge 都在补这类 server-side 查询接口。
内容寻址让缓存不需要协调。 官方的说法是:所有源码数据都是内容寻址的,一份数据存进去之后永不改变,因此任何 server 都能缓存它、不必和其他 server 确认。这是最值得单独记住的一条工程原理——不可变 + 内容寻址 = 缓存层零协调成本。它和 Git 无关,任何有大量重复读取的系统都适用。
稀疏和虚拟化检出,不要每次全量落盘。 官方原则是"工作副本是可选的、设计上就是稀疏的":CI job 要 diff 就让服务端给 diff,写操作也可以完全走 API 跳过检出;需要文件时,客户端只为它真正读到的内容付费。你没有 Scion,但 Git 的 sparse-checkout 加 partial clone 组合能拿到相当一部分收益。
再看拿不走的:Spanner 级强一致 CAS、自建的代码审查(Antique)、代码搜索和 CI、近乎无上限的 token 预算,以及"superfans"那套运维模式——官方描述是让 Claude 常驻盯着单个组件的健康度,像一个"没别的事干、只刷图表找异常"的资深工程师。这四样都绑定 Anthropic 自己的组织规模和成本结构,照搬只会得到一个更难维护的系统。
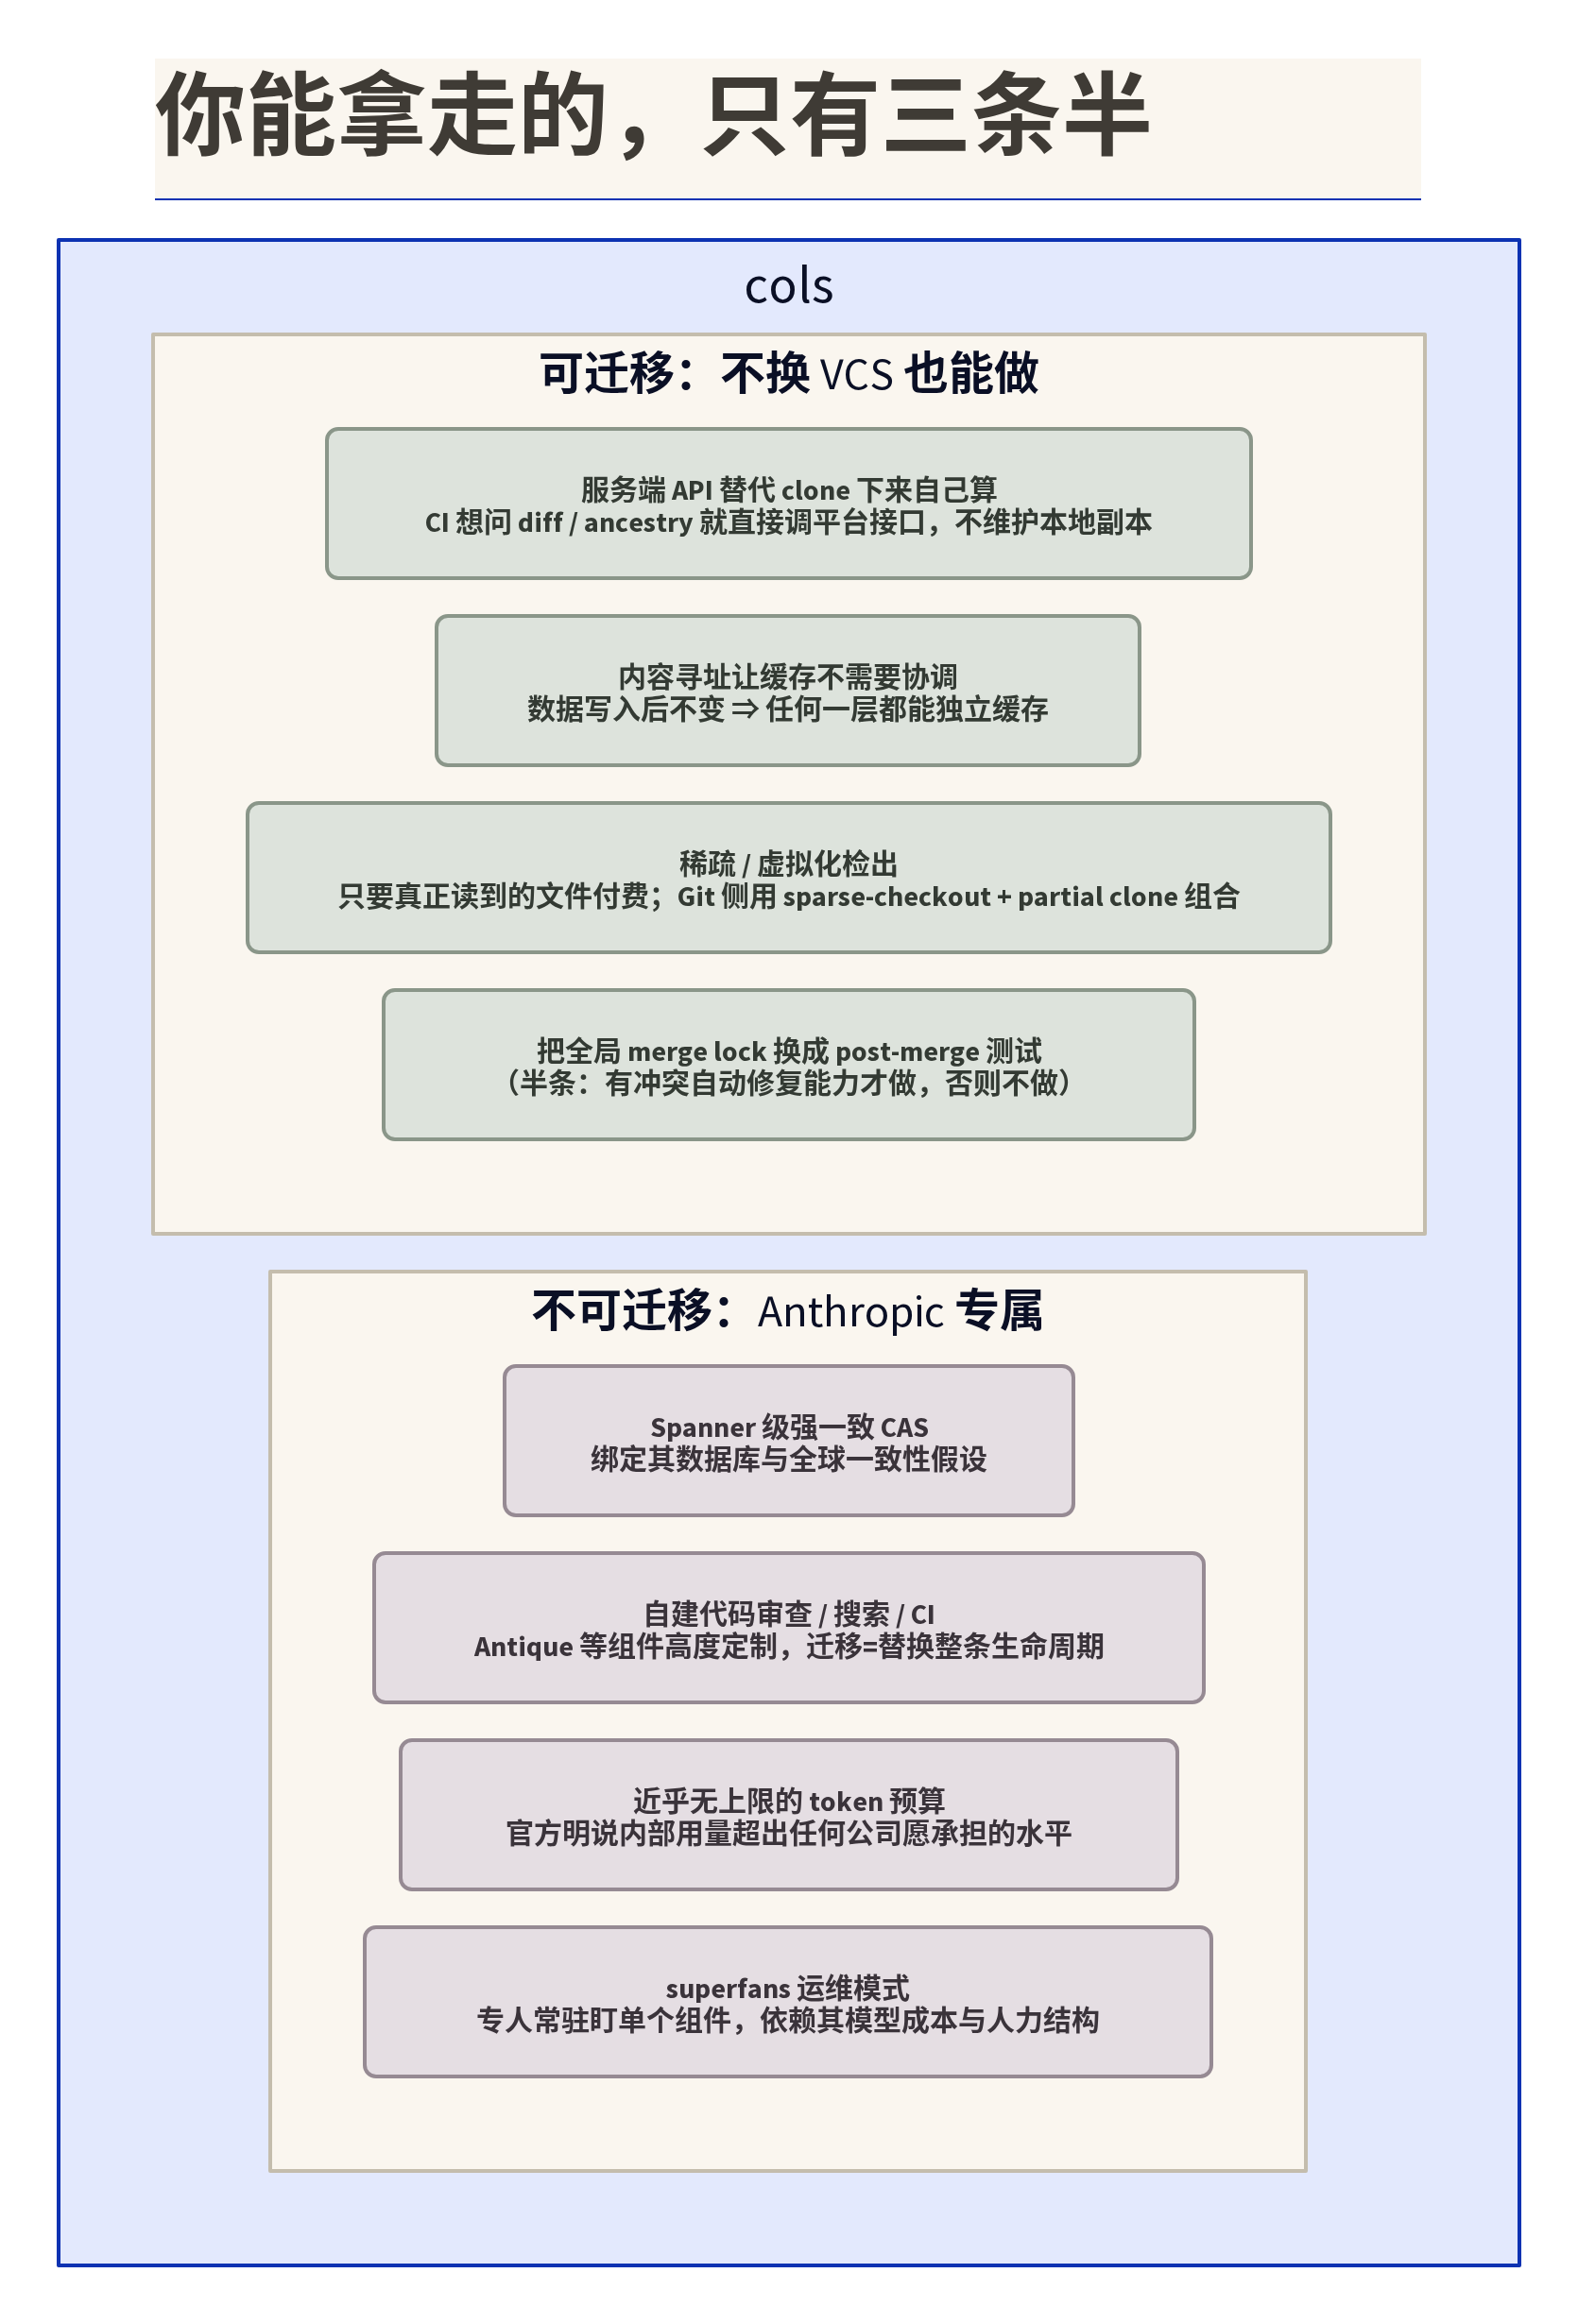
对照依据:Anthropic 官方博客 Principles 段落 + open_scion README 的设计映射表。
那份 Go 复刻复刻的是设计,不是 Anthropic 的运行环境
在社区复刻出现之前重读官方博客,你会注意到一个容易被忽略的细节:Anthropic 说"Git server 不必和 Git client 一样工作"。
这句话在 10 月 15 日被具象化了。feder-cr/open_scion 于 2026-10-15T13:12Z 建库,语言 Go,700★ 出头 / 60 fork / 0 open issue,README 首段自述是"an independent implementation of the publicly described design. It is not affiliated with or endorsed by Anthropic"。它不是 Anthropic 的代码,也未经其认可。
它挑的实现路径本身值得看一眼,因为它回答了一个真问题:server 化的版本控制是不是必须从零写。 答案是不必——它 fork 了 Gitaly,也就是 GitLab 那个 MIT 协议的 Git RPC server,把 Git 的底层 plumbing 原样留着,上游的每个 Gitaly RPC 都还能用。这是"可迁移"主张最直接的实物证据:服务端化不必重写 Git,只需要在它上面加一层。
它的设计映射里有三处对工程判断有参考价值。一是服务端把 blame、path history、ancestry、code search 当作 derived data 算一次并记忆化,而不是让每个 client 本地算。二是落地用 CAS 而不是 merge queue,并发的 land 会被批量合并成一次 reference 更新。三是冲突解决是可插拔的——可以接任意 LLM provider,也可以用确定性工具,或者干脆不用,协议本身保持厂商中立,server 不调用任何模型。
但紧接着必须说清楚它现在是什么状态。我核对了仓库的 commit 历史:整个仓库一共 6 个 commit,全部落在 2026-10-15 13:09Z 到 13:24Z 这 15 分钟之内,最后一条是 13:24:44Z 的 “test: build test binaries without VCS stamping”。这是一次性把初始版本推上去,不是持续开发出来的。README 自己也写明这是 0.1.0 首次公开发布、接口在 1.0 前仍可能变,已知缺口(比如 storage core 里 pack 的垃圾回收)记在 doc/graft/LIMITATIONS.md 里。
作者本人也标了 LLM 使用的关键细节:“every AI feature works with any provider, or none.” 这既意味着它不能被当成"Anthropic 官方路线",也意味着它比一篇大厂博客更接近一个你能真的 clone 下来读的架构样本。700 个出头的 star 是热度,不是生产验证。想读代码结构的话,它的 proto、sdk、internal/graft、middleware、auth、proxy 目录是官方六条原则的目录级落点,doc/graft/ARCHITECTURE.md 和 STORAGE.md 解释取舍——当设计文档读,别当方案选。
你要装的两个报警器,和一条顺手就能做的改造
回到开头那个主张:不换 VCS,但要开始量。
Anthropic 的博客里藏着一个对普通团队最有用的信号:他们说无法有效复制"合并队列全局仓库锁"这个行业标准做法,于是改为投资 post-merge 和 pre-deploy 的自动化测试。代价是并发改动会冲突,他们靠 Claude 修冲突——官方说法是它修冲突往往比人发现问题还快。没有同等 agent 修复能力的团队不能照搬这一步,这是明确的边界。
所以体检从三个数开始,对应三个不同的处置档位:
第一,量你的 CI 里有多少 job 是 git clone 全量,有多少其实只需要一次平台 API 调用的 diff 或 ancestry 查询。如果全量 clone 占大头,而 job 本身只跑几分钟——这是能改的一档,改的方向是 API 优先。
第二,量 agent 每次起 sandbox 的 checkout 时间和字节数。字节数开始接近仓库压缩副本的量级、时间进入分钟级,就是该观察的一档,先开 partial clone 和 sparse-checkout。
第三,量从 push 到 land 到 main 的 p95 延迟。这个数开始随并发 agent 数量线性上涨,就是该动手的一档——此时才轮到讨论"是不是要动服务端架构"。
四步改造按这个顺序做,每一步都不需要换 VCS:CI 改成 API 优先,能问平台就不要 clone;打开 partial clone 和 sparse-checkout;在中间加一层按内容寻址的对象缓存(记住第一条原理——内容不变,缓存就不需要协调);最后才考虑把全局 merge lock 换成 post-merge 测试,而这一步取决于你修冲突的自动化能力,没准备好就别做。
官方对时间窗口的判断是,这类扩展问题会在未来六到十二个月变得更普遍,而每个用 Git 的公司各自去撞一遍是低效的。他们给出的方向也很克制:让 Git 平台提供更完整的 server-side RPC,让协商协议不再是今天的样子,让 sparse 和 shallow 各种特性能够良好组合。
一句话收束:你先撞到的几乎一定是"评审和 CI 的假设",不是"必须自建 VCS"。 所以今晚别去 clone 那个 700 star 出头的仓库当方案用,去把它当设计文档读;真正要动手的,是在你的 CI 配置里 grep 一下 git clone,看看有几个 job 其实只想问一句话。