你手上有 Claude Pro、ChatGPT Plus、Copilot 三份订阅,外加几个便宜国产模型的 key。可 Claude Code 只认 Anthropic 的协议,Codex 只认 OpenAI 的 Responses,Gemini CLI 只认 Google 那套。想「让 Claude Code 跑 Kimi 省钱」,就得手改 ~/.claude/settings.json;想「让 OpenCode 用 Claude 订阅」,就得去翻 OAuth token。改完还不踏实——厂商随时可能把这条路堵死。
9 月 23 日,yetone 开源了 magpie,想一次性解决这件事:本机跑一个网关,9 个编码 Agent 共用任意模型。 仓库发布不到 24 小时连发了 4 个版本(v0.1.0 到 v0.1.4,全部在 9 月 23 日),作者是 claude-code-router 的作者,8.6k followers。项目还很新——我写这篇时它才两位数 star,这不是一个成熟项目,是刚写出来的东西。
但这不是一篇「新工具推荐」。它最值钱的地方,是源码里一行讲清楚「为什么协议翻译容易、订阅复用难」的注释。 如果你也想过自己写个网关,那行注释决定了你会不会踩同一个坑。
协议翻译是体力活,一晚就能写完
先把心理门槛降下来。magpie 的网关本体在 internal/gateway/ 下,核心常量就两行:
|
|
第二行的注释很有意思,原文写着:The gateway only listens on loopback and accepts anything, but agents insist on one.(网关只监听 loopback 且什么都接受,但 Agent 们非要有个 token。)所谓鉴权其实是摆设,真正的安全边界是「只绑 127.0.0.1」这个事实,不是一个密钥。
路由表摊开看,就是四套 API 各占一个前缀:/v1/chat/completions 和 /v1/responses 是 OpenAI 的两套,/v1/messages 加 /v1/messages/count_tokens 是 Anthropic 的,/v1beta/models/{model}:generateContent 是 Gemini 的。
真正的成本在哪?不在协议本身,在流式、工具调用、推理块这三样。
magpie 的做法是先把四套协议解析成一层内部中间表示(internal/gateway/ir.go,注释说得很直白:「The APIs are close cousins」——这几套 API 是近亲),再从这个中间层渲染回目标协议。中间层里定义的消息块只有五种:text、image、tool_call、tool_result、thinking。
难的是这五种块在四套协议里的拆装方式各不相同,随便举三个源码里能查到的例子:
- OpenAI Chat 的工具调用是带索引的碎片流(
chatDecoder里专门用tool int记录「当前打开的是第几个」),Gemini 的 function call 却是整块吐出的。 - Gemini 的 schema 是 OpenAPI 口味,字段名小写、还有自家扩展,magpie 得写个
jsonSchema()把它转成标准 JSON Schema。 - Gemini 的
usageMetadata里 prompt 计数含缓存 token,thinking 计数单独拆出来——和 OpenAI 的usage字段对不齐,得单独映射。
写一个能跑通的双向翻译,确实是体力活,但一晚上能出原型。这也解释了为什么市面上的网关那么多:LiteLLM、各家云厂商的网关、GitHub 上随手一搜一大把。翻译这件事本身没有护城河。
不过还有个小细节值得记下来,因为它能省掉一整类排查:Anthropic 的 count_tokens 接口,magpie 不是简单转发。如果目标 provider 讲 Anthropic,就转发;如果走的是 Claude 订阅路径,它直接本地估一个数返回(源码注释:Its OAuth token must not take a direct HTTP side path just for token counting.)。为了一次 token 计数多开一条 HTTP 旁路,不值得——这种「宁可估也不绕路」的取舍,是网关设计里很容易忽略的一环。
真正的墙是「你的请求看起来像谁发的」
到这一步,一切都很顺。然后你会撞上那堵墙。
magpie 的 README 里有一段话,值得逐字读:
Claude subscriptions are different: Anthropic classifies another agent’s system prompt as third-party traffic even when the OAuth request otherwise looks like Claude Code.
翻译过来就是:就算你的 OAuth 请求看起来完全像 Claude Code 发的,Anthropic 依然会因为你请求里的 system prompt 是别的 Agent 生成的,把它判成第三方流量。
这句话把很多人对「订阅复用」的直觉打碎了。大家默认的模型是:厂商靠凭据识别身份——你的 token 是不是官方客户端的。按这个模型,只要我复制 token、把 User-Agent 伪装成 claude-cli/<版本> (external, cli),就该畅通无阻。
实际不是。厂商看的是请求内容。
这不是 magpie 的猜测。Anthropic 自己的支持文档把这条线画得很清楚:第三方 harness 的用量不再从订阅额度里扣,而是走 Extra Usage 单独按 token 计费。官方给的技术理由是第一方工具(Claude Code、Cowork)针对 prompt cache 命中率做了优化,而第三方 harness 每次全新调用、绕过了这层缓存优化,对基础设施造成「outsized strain」(过大压力)。
这里的反常识在于:这不只是一个商业决定,缓存命中率是真实的工程成本差。 第一方 harness 复用的是同一段上下文,第三方每次从零算——同样的任务,后者的实际算力消耗可能高出一个量级。所以「为什么突然翻脸」这个问题有两个同时成立的答案:算力账算不平,商业模式也不允许。两个都对。
而且这条线不是一次画完的,来回拉扯了好几轮:
- 1 月 9 日,Anthropic 首次切断第三方工具用订阅 OAuth token,零预告,社区炸了之后又短暂恢复。Hacker News 上那个帖子拿到 625 分。
- 4 月 3 日,Claude Code 负责人 Boris Cherny 在 X 上宣布政策,4 月 4 日中午 12 点(PT)就生效——不到 24 小时。HN 帖子 1099 分、几百条评论。同期的补偿是一次性额度(等额月费)+ 折扣 extra usage 包 + 全额退款通道。
- 6 月 16 日,原定把 Agent SDK、
claude -p、第三方 app 的用量从订阅限额里切出去、改发月度 credit。结果当天又暂停了——官方邮件原文:「Nothing changes for now… Your subscription limits are unchanged.」
三轮反复,说明厂商自己也在摸索这条边界在哪。 对要长期维护的东西来说,这比「政策很严」更值得警惕:边界还没定,今天的绕过方式明天可能就失效。
magpie 的答案:不模拟协议,去驱动真的那个二进制
知道墙在哪,解法就清楚了。magpie 干脆放弃「假装自己是 Claude Code」,直接调用本机真的 claude 二进制。
internal/gateway/claude_subscription.go 的文件头注释解释了原因:
Anthropic applies subscription eligibility checks to request content (not just credentials/CCH); prompts generated by Pi, OpenCode and other harnesses can otherwise be routed to Extra Usage. The subprocess keeps Claude Code’s real Agent/CLI identity.
关键词是 identity(身份)。 不是伪装成它,而是就是它——进程起来的时候,身份天然是真的。
具体怎么串起来的:
调用方 Agent 通过网关发来 Anthropic Messages 格式的请求,magpie 起一个 claude 子进程(claudeCLIArgs 里带 --mcp-config、--strict-mcp-config、--tools "" 等参数)。关键在于工具怎么桥接: magpie 把调用方的工具暴露成一个 MCP server,跑在一个隐藏的 stdio helper 里。Claude 那边发 tools/call 时,这个调用在 helper 里阻塞住,同时 magpie 把 tool_use 块返回给调用方;调用方下一轮 HTTP 请求带回来 tool_result 块,这个结果解开的正是同一个 Claude Code turn。
这就绕开了最难的一环:Claude 以为自己在一个正常的对话里用工具,实际上工具是外面那个 Agent 的。 身份是 Claude Code 的,工具是别人的——两个需求同时满足。
源码里还有两处很实的工程细节,都是这种架构才会遇到的问题:
cleanClaudeEnv会主动删掉ANTHROPIC_BASE_URL、ANTHROPIC_API_KEY、ANTHROPIC_AUTH_TOKEN,再塞进ENABLE_CLAUDEAI_MCP_SERVERS=0等变量。原因很直白:magpie 自己改了调用方的环境变量指向网关,如果这些变量被继承进子进程,Claude Code 会回头去连 magpie,死循环。- 子进程带 30 分钟超时自杀(
time.AfterFunc(30*time.Minute, run.abort))。注释写的场景是:调用方拿到tool_use之后可能直接放弃这一轮,那就不能让一个挂着等结果的 Claude 进程和 MCP 请求永远活着。
还有一个竞态:注释里说 Claude emits message_stop just before its MCP calls are all scheduled(Claude 在 MCP 调用全部登记完之前就发了 message_stop),所以快速客户端可能在回调还没注册好时就返回结果。magpie 的处理是重试 20 次、给一个有界宽限期。
这条路径的代价,必须说清楚:
- 本机必须装好并登录 Claude Code。 README 明写「This requires Claude Code to be installed and signed in」。这是硬依赖,不是可选项。
- 它仍处在灰色地带。
internal/provider/claude_cloak.go里做了 User-Agent 伪装(claude-cli/<版本> (external, cli)),文件头注释自己写着这些字段是 Anthropic 用来把用量归到 Pro/Max 订阅而非 extra usage 桶的。这等于在跟分类器博弈,厂商一次更新就可能失效。 想拿它当长期基础设施,得把「随时可能失效」算进设计里。 --dangerously-skip-permissions这个参数出现在参数表里,用之前最好先明白它意味着什么。
所以「用 magpie 就能合法共享订阅」这句话是错的。 准确的说法是:技术上可行,合规上灰色,厂商可随时封堵。这也是为什么下一节要给你一个判断表,而不是一句「推荐使用」。
改配置文件这件小事,做对了能省一堆 support 工单
如果前两节讲的是「为什么难」,这一节讲的是「哪个细节能直接抄」。
magpie 要改的配置文件散在三个格式里:~/.claude/settings.json、~/.codex/config.toml、~/.gemini/settings.json、~/.config/opencode/opencode.json(c)、~/.config/goose/config.yaml、~/.cursor/cli-config.json、~/.copilot/settings.json、~/.config/crush/crush.json……
这里有个所有做过配置管理的人都踩过的坑:你不能直接 json.load 再 json.dump 写回去。
因为用户的配置文件里有注释、有自定义的键顺序、有手写的缩进。一次序列化,这些东西全没了——用户第二天打开配置发现自己的注释消失、键被重排,那体验是灾难性的,而且极难解释。
magpie 在 internal/edit/ 下给三个格式各写了一个编辑器,用 tidwall/gjson + tidwall/jsonc 做只改指定 key path 的定点写入。文件头的注释把目标说得很清楚:Only the requested key changes; comments, ordering and indentation are left as they are.
写入用 WriteAtomic——临时文件 + rename,注释原文:a crash can never leave a half-written config behind,并且保留原文件的权限位。
这两件事合起来,就是「改用户配置文件」这个动作的正确姿势:定点改 + 原子写 + 保格式。 你在写任何会碰用户配置的工具时都能直接用这套。
不过它有个必须知道的边界:Agent 是启动时读配置的。 README 里明确写了「Codex reads its model list at start-up, so restart it after a switch」,还有一句「Agents read their config at startup, so a running session keeps its model until you start a new one」。
这意味着 magpie 的「一键切换」不是热切换。 你在面板上点一下,改的是磁盘上的文件,正在跑的会话不会换模型,得重开会话才生效。 这不是 bug,是所有「改配置文件」路线的固有限制——想做到热切换就得改协议或加代理层,那是另一套架构。
顺带一提,magpie 的机制是可逆的:stash.json 保存被替换掉的原值,切回原生模型时原样还回去;README 里也强调选原生模型会「puts back exactly what was there before」。做配置改写工具,留一份 stash 是基本礼貌。
自建网关的决策表:三条路,各有代价
回到最开始那个问题:你该自己搭一个多协议网关吗?
先看 magpie 本身值不值得用。 它是 Go 写的,MIT,本机网关加一个系统 webview 的桌面面板(官方称打包后 15MB 以内,纯终端版 7MB),支持 macOS / Linux / Windows。Linux GUI 依赖 WebKitGTK 4.1,装不上会退化成终端版。面板长这样:
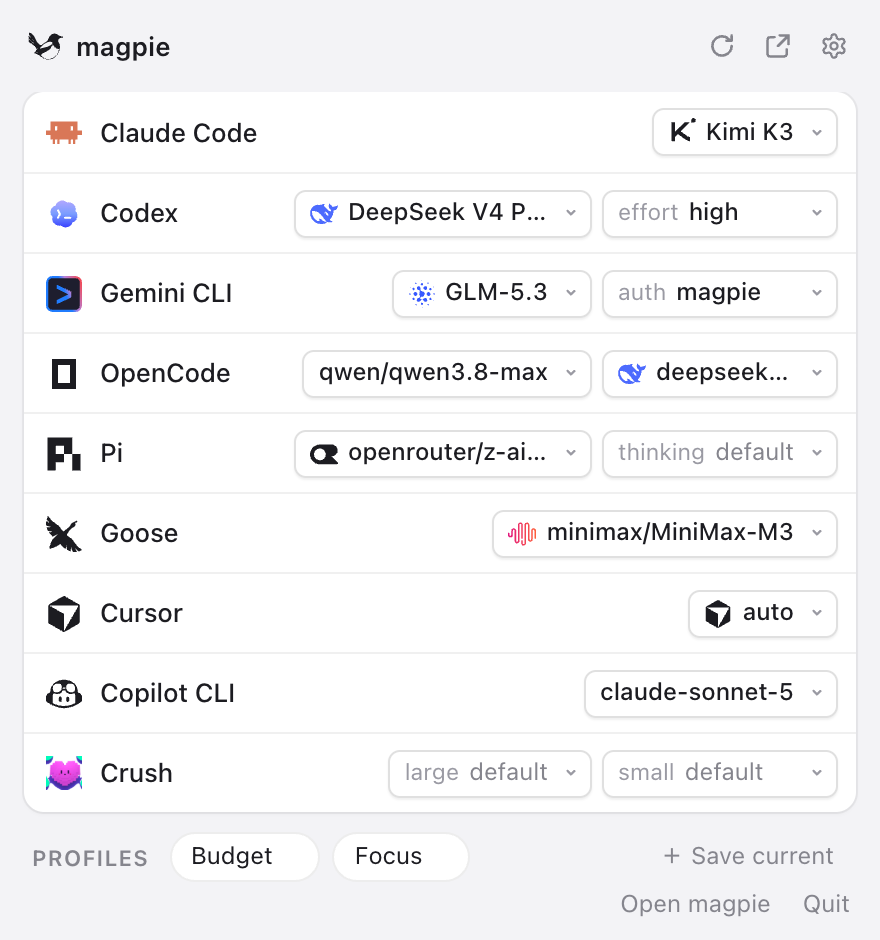
图源:yetone/magpie 仓库 README(MIT),访问日期 2026-09-24。
但要清醒:两位数 star、9 月 23 日刚建仓、一天发 4 个版本。 一天 4 个版本意味着 API 和配置格式都会变,现在用它就得接受跟着升级。它适合拿来「读架构」和「试水」,不适合今天放进生产链路。
如果你是要给自己的项目做模型接入,三条路选一条:
| 路线 | 什么时候选 | 代价 |
|---|---|---|
| 纯协议模拟(自己拼请求头指向厂商) | 只用 API key,不碰订阅 | 最省事,但订阅路径会被内容分类器降级到 Extra Usage |
| 驱动真实二进制(magpie 路线) | 重度依赖某家订阅、且能接受本机装那个 CLI | 依赖本地安装与登录;灰色地带,厂商可随时封堵;进程管理复杂(超时、竞态、环境变量清理) |
| 直接买 API key | 要长期稳定、要给团队用 | 最贵,但最稳,不违反条款,也没有「明天失效」的风险 |
判断标准可以简化成一句:如果你在为团队或长期项目做选型,直接买 API key。 订阅复用的省钱空间是真实的,但它的前提是「厂商不追究」,而这个前提在过去 9 个月里被推翻过三次。把基础设施建在一个反复变化的政策边界上,风险不在技术,在时间。
只有个人、自用、且能接受随时失效的场景,订阅复用路线才划算。
想动手的话,最小验证路径是先只做协议翻译,别碰订阅:让网关同时接受 /v1/messages 和 /v1/chat/completions,都转发到 DeepSeek 或 Kimi 的 API key,这一步验证的是你的中间表示层对不对——重点盯流式、工具调用碎片、reasoning 块这三处。magpie 的 MAGPIE_DEBUG=1 会打印每一次翻译过程,照着它的输出对一遍,比自己瞎试快。
然后单独验证「改配置」这件事。 拿一个你不心疼的配置文件,改一个嵌套 key,diff 一下看注释和顺序有没有被冲掉。冲掉了就说明你用了序列化而不是定点写入——这是最容易被忽略、也最容易被用户投诉的地方。
最后才考虑订阅路径,并且先答三个问题:这台机器上装了那个 CLI 吗?登录状态会一直保持吗?如果明天这条路被封,备用方案是什么?
至于 magpie 那行注释真正的价值——它告诉你「订阅复用的难点不在技术,在身份」。 这个判断不会因为 magpie 这个项目本身是否成功而改变。哪怕它半年后停止维护,你今天花半小时读一遍 claude_subscription.go 的文件头,也是值的。