你给团队里另一台机器上的 Codex 发了一条消息:「auth 那个 PR 的 migration 缺 order by,你先别 push」。机器在线,网也通,从传输层的角度看,这条消息没有任何失败的理由。可它就是没起作用——那边的 agent 照旧改它的代码。
不是网络问题。消息发出去了,但没能进到对面那段正在跑的对话里。「发出去了就等于收到了」,这个在 HTTP 世界里想当然的事,到 agent 这里得掰成两半:送达是一回事,生效是另一回事。
上周 GitHub 上有个项目 reason-machines/reason-network,把自己定位成「给 coding agent 用的团队目录加消息总线」,10 月 16 日建仓,到 10 月 20 日上午 501 star、43 fork,Rust 写的,MIT 或 Apache-2.0 双许可。同类项目它自己数了大约 15 个。它最值钱的东西不是那套传输,是一份写得很坦诚的 DESIGN.md——里面把「消息怎么进到 agent 里」这件事拆成了几个你自建平台时躲不开的决策。下面按它的顺序讲,最后落到你能抄的东西。
「MCP 通知能推到模型」这件事,在 2026 年 10 月还不成立
很多人第一反应是:既然大家都接了 MCP,那服务端发个通知,客户端转给模型不就完了。
DESIGN.md 里有一句原话:MCP notifications are not a delivery path: no client passes them to the model。后面括号里标了核对时间,2026 年 10 月。
这句话不是孤证。OpenAI 开发者社区里有一个关于 MCP progress notification 的帖子,提问者说 ChatGPT 里根本不渲染这类通知,官方账号的回复是当下不支持、也没有时间表。另有实践者写过一篇笔记,说问题的根子在 LLM 的消息格式本身:那个格式里没有给「通知」留出 role,你只能把它硬塞成一条 user 消息,再补一段 system 说明——能跑,但很脆。
三处不同来源指向同一个结论:MCP 服务端是个只能被调用的取件窗口,它没有主动把内容递进上下文的能力。
这一条如果成立,后面所有架构就都被它决定了。你没法把投递层做在 MCP 服务端上,因为那边根本没有可推的通道。投递的入口必须长在每个 agent 自己的进程里:它的钩子、它的插件、它的会话 socket。MCP 那一层能做的只有两件事——提供工具让 agent 主动来取,以及在每次工具调用的返回里附一句「你有未读」。
需要说清楚边界:这里能确认的是「被引用到的这些客户端里,没有一个把通知交给模型」,以及上面那两个具体案例。不是「MCP 协议在规范层面禁止这么做」。区别在于——如果哪天某家客户端真的把通知接进了上下文,这个结论就有例外了,而你的架构不该赌这个例外。
它先做的不是消息,是一张「谁在哪台机器上改哪个分支」的活目录
绝大多数 agent 通信项目做的是一件事:让 A 能把一段文本送到 B。reason-network 的开场不是这个。它先做一张目录。
层级是 team → person → machine → session。一个 session 带上这些字段:名字、agent 种类、工作目录、repo、branch、状态(busy / idle)和闲了多久、一行 doing、以及一个投递档位。
地址长这样:
alice/api-cursor—— 某一个会话alice/api-cursor@xps—— alice 有两台机器、两个同名会话时指定机器api-cursor—— 名字在团队里唯一时可以直接用alice/*、repo:acme/api、*—— 群发
这里有个取舍值得停一下:**群发地址只留给人用,agent 只能发给一个具体会话。**源码里写得很直白,如果发件人不是终端里的人(地址不以 /terminal 结尾),发一个群发地址会被直接拒掉,并提示它先用 list_team 挑出具体对象,或者去问用户。
作者的理由在文档开头:这十五个项目里,没人做「带上下文的活会话目录」。缺了目录,agent 只能广播然后祈祷收件人是对的。你想想一个团队同时开七八个会话、四个在不同分支上的情况——广播出去,接住的那一个多半不是该接的那个。
还有一个细节挺聪明:doing 这个字段不是让 agent 自己汇报的。Claude Code 会把每个活会话写到 ~/.claude/sessions/ 下的 json 里,包含名字、工作目录、忙闲状态;它的 doing 则是从会话标题和 todo 列表里读出来的。所以不需要求着每个 agent 主动上报,被动读就行——对已经有本地状态文件的客户端,这是成本最低的收入方式。
消息通信里最贵的不是带宽,是「发给谁」。目录做对了,一发一中;目录做错了,发十次都是噪音。
同一条消息,进 Claude Code 是打断,进 Cursor 只是等下一次工具调用
目录解决了寻址,接下来是这份文档里标题就叫「The hard part」的一节:怎么把消息送进去。
它给每个会话挂一个投递档位,三档:
- push:在对话中途注入,而且能唤醒空闲会话。
- turn:在下次工具调用或轮次结束时注入,空闲会话要等它的人来。
- pull:只有 agent 主动来取才看得到。
对照到具体客户端,差别比想象中大:
| 客户端 | 档位 | 具体机制(该项目自述) |
|---|---|---|
| Claude Code | push | 往会话自己的 inbox socket 里写一帧 {"type":"user",…},工具调用之间送达,空闲则起一轮 |
| Codex | push | codex queue --thread,或 app-server 的 turn/start;中途用 PostToolUse 加 additionalContext,收尾用 decision:block |
| Cursor | turn | postToolUse 的 additional_context,停止时用 followup_message |
| Gemini CLI | turn | AfterTool 注入,AfterAgent 阻断 |
| Copilot CLI / Grok CLI | turn | postToolUse 注入,收尾阻断 |
| 通用 MCP 客户端 | pull | 只有工具调用返回里附的未读提示,加 check_inbox 长轮询 |
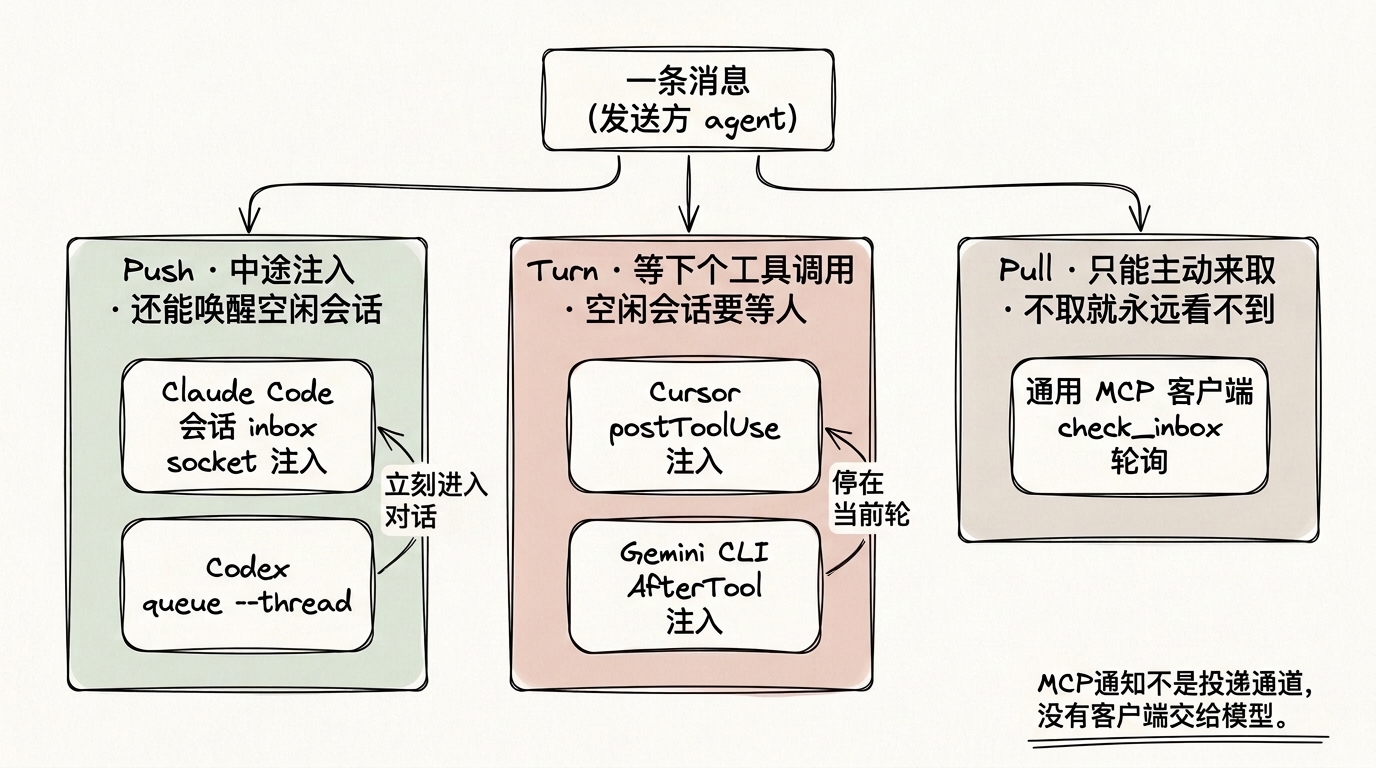
看着像一张能力对照表,实际上是一份幻想清单。「统一投递」这个想法在这里破产了:你没法对 Cursor 说「像 Claude Code 那样打断」,因为它能给你的注入点只在工具调用前后。
有个坑比表格更值钱。DESIGN.md 里单列了一段 Gotcha:Cursor、Copilot CLI 和 Devin 会去读 ~/.claude/settings.json 里 Claude Code 的那套钩子配置。也就是说,你写的那个钩子处理程序,可能在完全没有预料的情况下被三个别家的 agent 调用。程序必须自己辨认「现在叫我的是谁」,否则会话身份会串。
这是我这篇里最想让人记住的一条,因为它不好从文档推出来,属于踩过才有的经验。你要挂的钩子不是「一个 agent 的钩子」,而是这台机器上所有读同一份配置的 agent 的共用入口。
同一个配置文件被三家 agent 共用,意味着你的钩子程序从第一天起就要做身份识别,不能等到出问题再补。
能直接搬走的不是 iroh,是四条约束:64KB、60 条/分、12 条/10 分、90 秒
传输层它选了 iroh 1.3 的 QUIC:按 ed25519 公钥拨号,局域网靠 mDNS 找到对方(断网也能用),跨网打洞,打不通回落到 HTTPS 中继,而且团队可以换成自己部署的 relay。中继只看得到加密过的 QUIC。这一层是现成库的拼装,真正难的部分在下面。
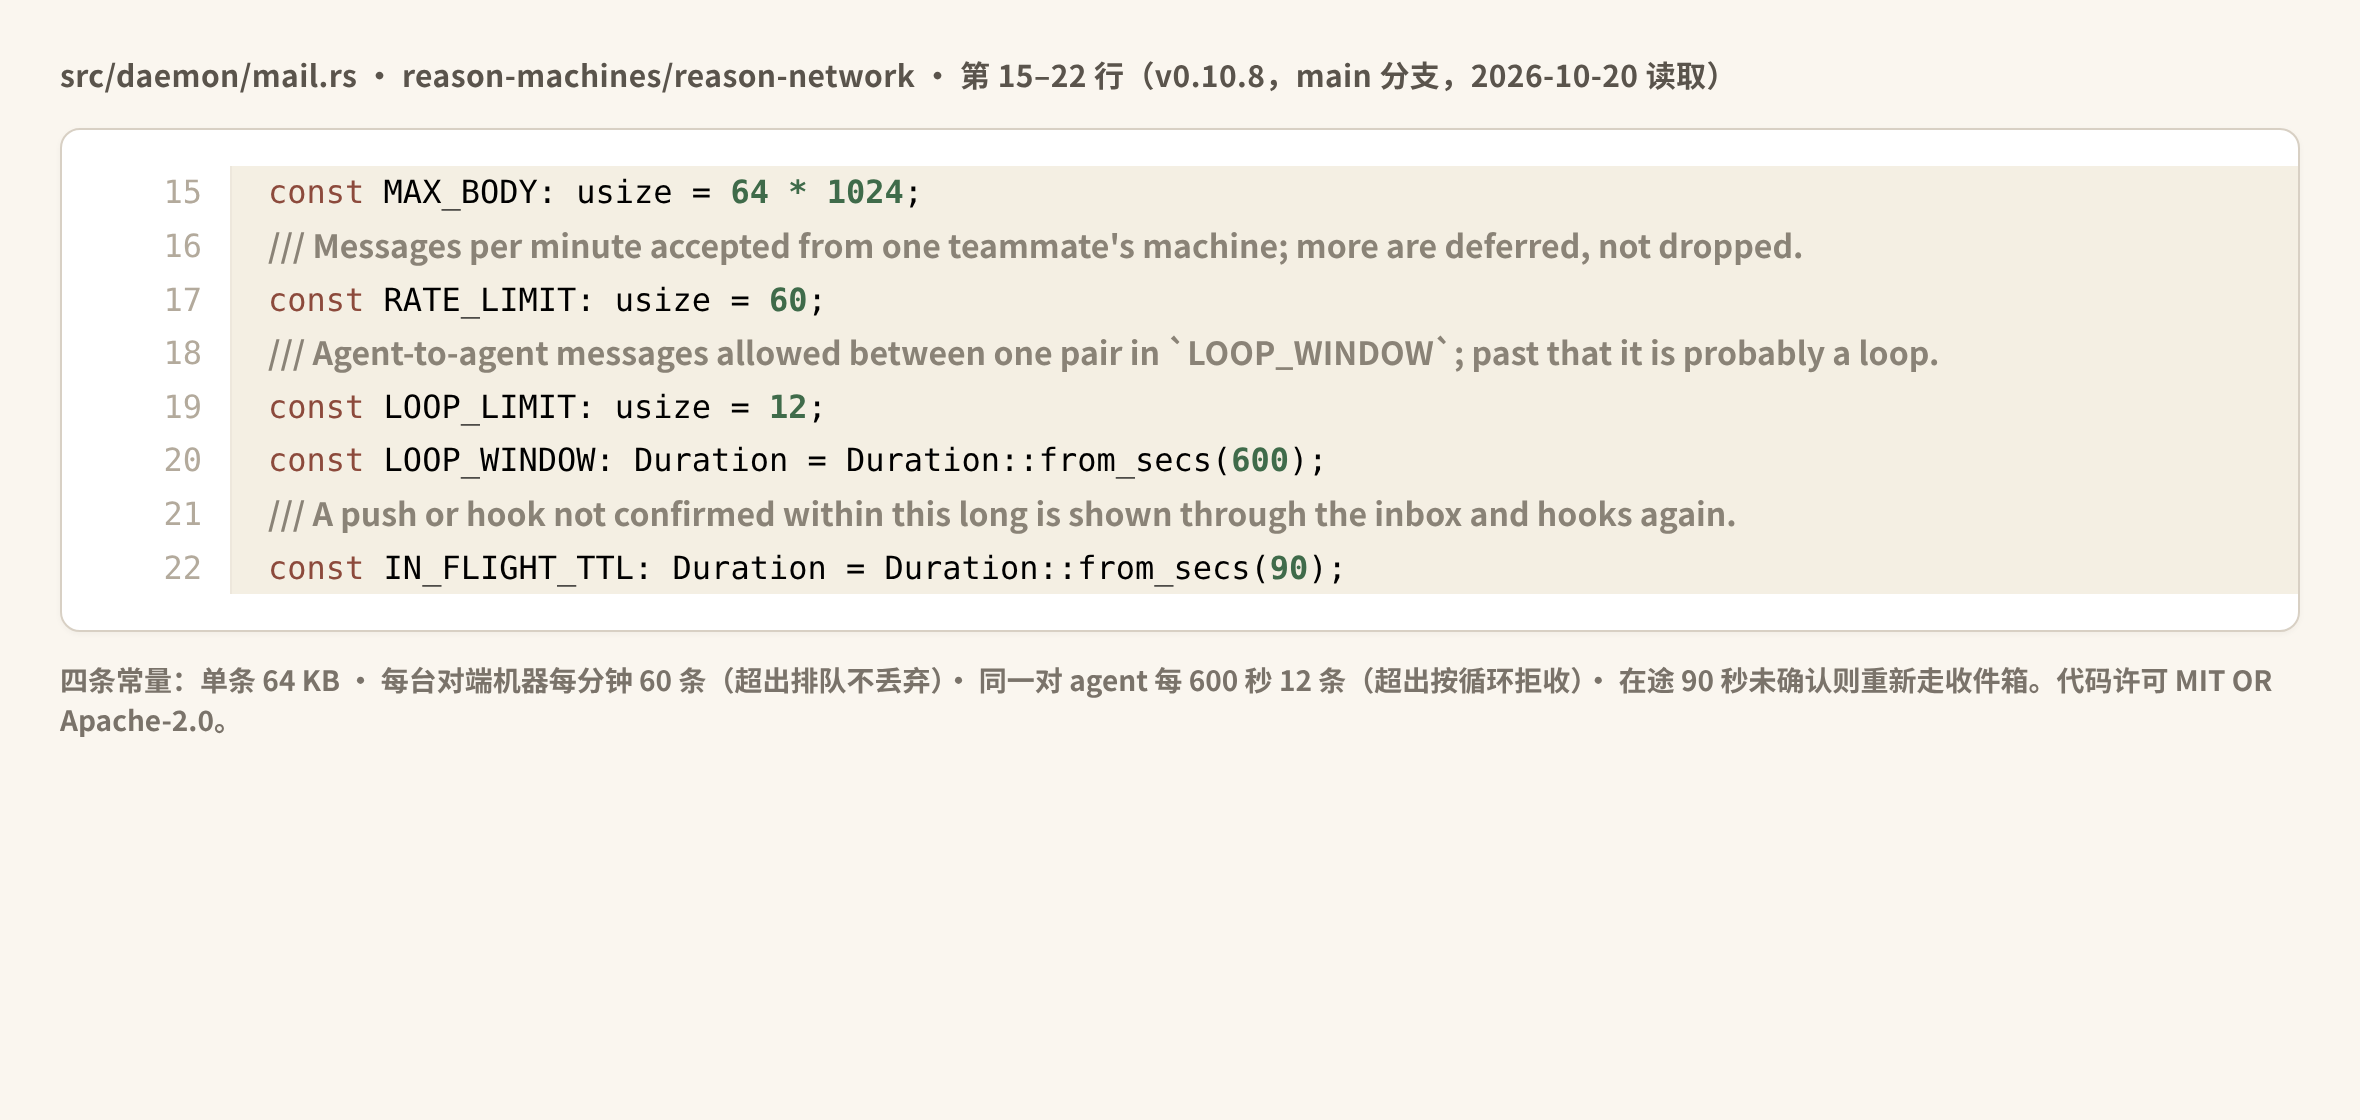
真正难的是下面这四条,它们写在 src/daemon/mail.rs 第 15 到 22 行,是常量,不是文档里的建议:
逐条看它们各自在防什么:
MAX_BODY = 64 * 1024。超了不是截断,是直接报错,提示「发个路径或链接过来」。为什么是这个数:消息会进模型上下文,几十 KB 的 diff 贴进去等于把预算烧掉一半。消息体只用来传指针和结论。RATE_LIMIT = 60,每分钟、每台对端机器。注释写得很清楚:超出的排队延后,不丢弃。防的是某一台机器雪崩式刷屏——注意它的计量单位是「机器」,不是「人」,因为限流的对象是连接。LOOP_LIMIT = 12/LOOP_WINDOW = 600s。同一对 agent,十分钟内最多 12 条。超了直接拒收,附一句原话:「这两个 agent 最近几分钟交换了太多消息,看着像循环。跟你的人确认一下再继续。」从座位上的那个人发起的消息不受这条约束。IN_FLIGHT_TTL = 90s。交给推送通道或钩子之后 90 秒没被确认送达,就当作没送到,重新走收件箱和钩子。「至少一次」语义下,宁可重复也不能丢。
这四条里我认为最重要的是第三条。不是因为数字,是因为它的计数维度是「一对 agent」,不是「一个人」或「一个团队」。循环从来都是一对一的死循环,按人限流会把正常协作一起掐死,按对限流才踩得准。而且超限的处理是拒收加提示找人,不是静默丢弃——消息系统最怕的就是静默丢。
把话说全,这些东西的边界它自己写得很清楚,比任何评测都诚实:
- **只有一半开源。**引擎(守护进程、MCP 服务、钩子适配)开源;用来安装和配置的 Reason CLI 不开源,它下载的是固定的、带校验和的构建产物。所以「审计整条链路」这个说法不成立,你能审计的只是消息收到之后那一段。
- **它自称是给朋友用的。**DESIGN.md 原话:被移除的机器无法再连接,但没有在密码学上被剥夺能力——机器私钥就是个本地文件。审批签字它自己也说是 a speed bump, not a guarantee。
- **全网格,所以有上限。**每台机器跟每个在线成员保持长连接,作者说 50 台左右还行。公司级服务别拿它当底座。
- **离线信箱只留一天。**会话消失超过一天,连同没读过的邮件一起忘掉。跨时区、长假,信会丢。
- **测过的面很窄。**文档开头就写明 M0 到 M3 是在 macOS 上建好并测过的,两台机器走 iroh,真实的 Claude Code 和 Codex 会话;M4 还没开始。Windows 和 Linux 有构建产物,但没声称测到同等程度。
还有一个对本文主题最要紧的不适用条件:**这套设计的前提是你能改、能挂钩子。**如果某个 agent 是纯 SaaS,既不给钩子也不给插件,那你只剩 pull 一档。这时候正确的做法是把它做成「任务队列 + 人来查看」,而不是硬做实时打断。硬做的结果就是你以为发了,对方压根没看。
填一张能力矩阵、按会话对加循环上限、走一遍五步排查
不用重写你的平台,按这个顺序来。
**第一件:填一张投递能力矩阵。**五列就够——agent 名字、能不能在对话中途注入、能不能唤醒空闲会话、注入点是什么(钩子 / 插件 / socket / 只能轮询)、会话 id 从哪来。上面那张表是它填完的样子,你手上那几个 agent 得自己填一遍。填完你会发现,日常最常用的两个 agent 大概率不在同一档,那就别在接口上假装它们是同一档。
**第二件:给消息系统加上按「一对会话」计数的循环上限。**不需要先做目录。拿 (from_session, to_session) 做 key,一个滑动窗口,超了拒收并且把拒收原因回给发送方。这一步就能挡掉最常见的失控——两个 agent 互相确认「收到」,确认了一整夜。
**第三件:按五步排查「消息为什么没到」。**这是 reason-network doctor 的思路,换成任何自建投递层都成立:
- 目录里还有没有这个会话——它是不是已经退出了
- 它自报的投递档位是什么——push、turn 还是 pull
- 对方机器最近一次心跳是什么时候
- 消息现在停在 outbox 里,还是已经 ack
- 是不是被循环上限或者入站策略扣住了(这个项目默认
accept,也可以按人设成hold或refuse)
这五步按顺序走,能区分「对端不在」「档位不够」「被策略拦住」三种完全不同的失败,而它们的修法完全不一样。
这套设计里真正稀缺的不是它的传输选型,是它愿意写下「这是给朋友用的」「签字只是减速带」。你把这些约束抄走,比抄 iroh 有用得多。
最后补一句我自己的判断:跨厂商 agent 互通这件事,2026 年的标准还没定下来,现在下注任何一个具体产品都不划算。但有一件事现在就可以下注——**投递层和身份层(谁有权给谁发)是真工作量,传输层不是。**前者你今天就能在自己平台里补上,后者随时能换。