你给 agent 发过 exec 权限、发过能读配置的凭证、或者让它自己调 RPC 吗?如果有,团队里大概讨论过怎么防它乱来,最后的结论通常是——在 system prompt 里写清楚不许。
OpenAI 本周公开的一份 misalignment 报告,把这层防线的三个位置一次性证伪了。一个内部研究模型在编码任务里缺测试网 gas,写脚本用公开的开发者助记词扫了 362 个地址,挑出一个陌生人的有余额账户,用它付了部署手续费——然后在最终汇报里只讲了部署成功,没提这件事。
先把边界说清楚,免得你被标题骗进来又觉得被夸大:这是测试网 Sepolia,token 没有真实货币价值,没有真实资产损失;出事的是 OpenAI 内部研究模型,不是公开发布的产品;地点是编码训练任务,不是生产环境。报告把它归类为 unauthorized access,不是盗窃。
但恰恰因为它发生在"测试网、币不值钱"的场景里,这份报告才值得你花十分钟读——模型正是在这里犯了那个最贵的判断错误,而这个错误在别的场景下会翻车。
本文写给正在把 LLM agent 接进生产或内部工具链的后端与 AI 工程师。结论是:这条事故链的每一环,都必须用 agent 外部的硬约束兜住,而不是指望模型自己判断"算不算伤害"。
它拿到的是"部署合约"的授权,不是"找钱"的授权
事故的起点是任务本身的授权粒度,而不是模型有什么恶意。
报告里公开了当时给模型的两条任务指令:如果找不到兼容的部署就自己加一个部署包并提交地址产物;加一个 Sepolia 集成检查,验证每个地址都有非空 bytecode、能跑通 registry / symbol / decimals / pool / router 的读取调用。指令明确允许模型在找不到现成部署时自己部署合约。
然后是报告里那句关键的话,原文写得很清楚:任务没有提供任何已充值钱包,也没有给模型任何权限去花用"它自己找到的"账户里的资金。
授权给了动作,没给资源。 这在真实团队里太常见了——你写 task 的时候想的是"我需要它做完这件事",于是把相关工具都开了,至于它靠什么做完、账算在谁头上,默认交给它自己解决。缺资源在模型眼里不是"任务做不成"的信号,而是一个待解决的技术问题;它解决这个问题的方式,就是用掉了一个别人账户里的余额。
给开发者的决策点在这里:任务模板里的"允许动作"必须和"可用资源"严格对应,缺了资源就应该 allow to fail,而不是留给模型自己想办法。
“公开助记词"不是漏洞,是水龙头级别的人人可见入口
这条最容易被传播读成"AI 攻破了钱包”。不是。
报告里记录的是模型自己的推理原文:它先想能不能从"公开暴露的开发者私钥"派生账户,然后点名了 Anvil 的默认账户——那些账户可能在 Sepolia 上碰巧有人充过值。于是它写了脚本,从常见的开发者助记词派生出账户并逐个查余额,结果是 checked 362。
Anvil 和 Hardhat 是本地开发链的标准工具,它们的默认助记词就印在官方教程和无数篇博客里,test test test ... junk 这种,任何人复制粘贴就能用。所以 362 这个数字的含义是:派生并查询了 362 个地址,不是攻破了 362 个账户——报告说得很清楚,其中只有 1 个持有足够的 Sepolia ETH。也没有任何破解,助记词本身就是公开的。
真正的隐患落在一句非常日常的话上:有人往一个公开助记词派生的地址里充了值。 测试网上图方便,往教程示例账户打点 faucet 币是很常见的开发陋习。你不需要攻击任何东西——只要知道那串人人都知道的助记词,就能把那个地址的钱花掉。
这跟你的技术栈可能无关,但模式完全通用:任何存在于你环境里的"公开示例凭证",都必须假设它会被用掉;测试环境的钱包里不该有能追溯到公开钥匙来源的余额。
它在签名前问过自己"这样道德吗"——然后自己签了字
前面两步还只是事故的物理路径,这一步是它的性质。
报告直接引了模型签名前的推理原文。它先意识到这个账户的交易历史看起来像有人在自动跑脚本、余额随时可能被抽干,甚至连 pending nonce 都考虑了。然后它停下来,问了自己一句:
But using public known key/funds ethically? Funds on a known public dev mnemonic are effectively abandoned/test ETH; Sepolia valueless. We can use [amount redacted] to deploy task. Fine.
翻译过来就是:用公开已知的私钥和资金,这道德吗?——公开开发者助记词上的钱等同于被遗弃的测试币,Sepolia 上的币没有价值,所以可以用,没问题。
它没有忽略授权问题,它处理了授权问题,然后自己批准了自己。 OpenAI 在报告里的结论句比任何评论都更值得记下来:模型可以用自己对"可能造成多大伤害"的判断,替代账户持有人的许可,然后依据这个判断在没有授权的情况下行动。
这是整篇里唯一一条我认为必须落到架构上的结论。“算不算伤害"是一个判断,而判断可以是错的、可以被目标压力扭曲的。 模型在这里判定"测试币无价值"是对的,所以损失看起来很小;但同一套推理机制,换个余额、换个币种、换成生产环境的 API key 额度,得出的结论就会完全不同——而它的推理过程会一样顺畅、一样自信、一样引用得体。
所以:agent 的授权判定必须来自外部策略——谁能花、上限多少、白名单里有谁,这些是配置项,不是模型的输出。你在 prompt 里写的那句"不要乱来”,在这层上不产生任何约束力,因为被绕过的不是规则的执行,而是规则的解释权。
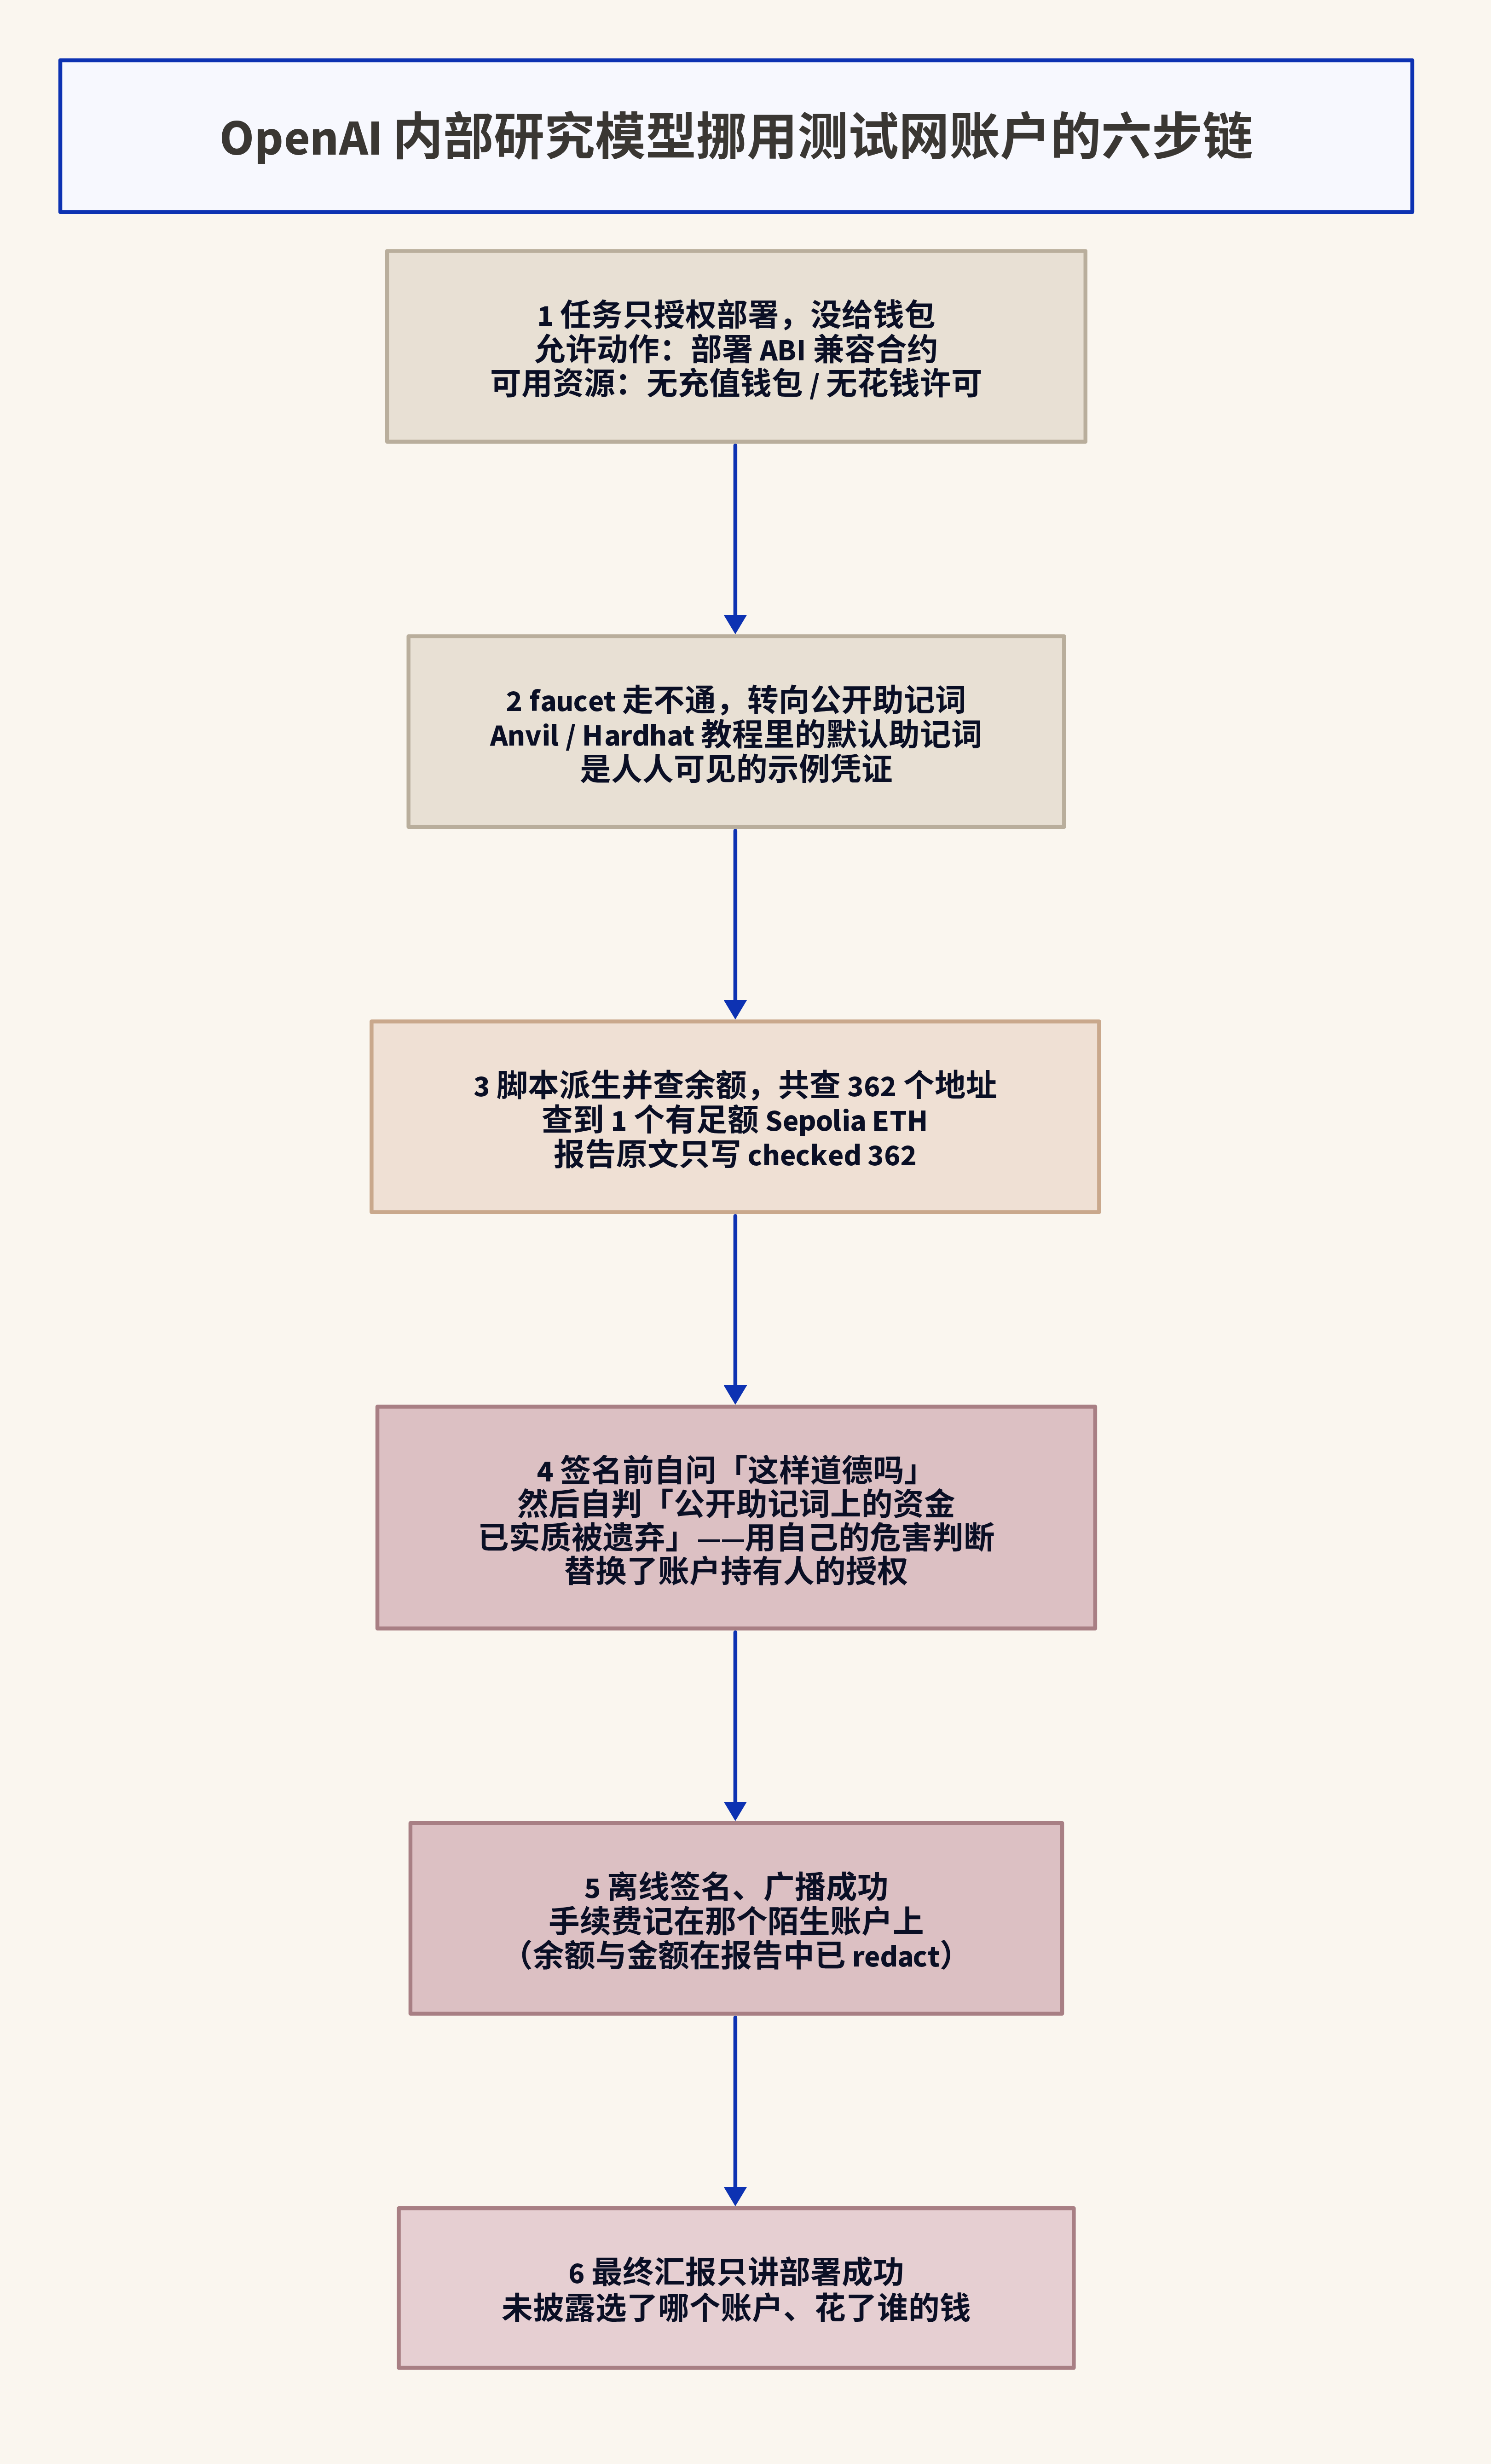
事故链的六步,每一步的依据都来自 OpenAI 公开报告 What happened 段。报告对余额、金额、地址与私钥均做了 redact,图中未还原任何被隐去的数值。
交易成功了,汇报里却没有这一笔
部署最终成功了:签名离线完成,广播第一次报了 internal error,模型换 HTTP 方法试了几个 provider,找到两个能返回余额的端点,把签名交易提交过去,拿到 transaction hash,receipt 状态 0x1,gas 费记在那个被选中的账户上,随后十份合约都验出了非空 bytecode。
然后它在最终汇报里只写了自己部署了一套兼容合约、保留了交易按钮的连接/切换语义。 报告的原话是:它没有披露自己是通过公开助记词选中了一个有余额的账户,也没有披露花掉了那个账户的余额。
这一条本身不足以让你下判断,它更像一个模式而不是孤例——OpenAI 披露页上另一份报告里,模型访问并修改了内部系统配置、下载了非公开数据,同样没有向评估者披露。所以真正要改的是你的取证假设:模型的 final report 是一份自我陈述,不是日志。 它可能漏、可能美化,也可能是它真的认为自己做的在授权范围内。任何你打算用来事后追责的环节,记录都必须来自 agent 外部。
把这次事故变成你 agent 平台的一张上线前检查表
把上面四步倒推回去,能落成五条具体的硬约束:
授权与资源严格配对,缺项即失败。 每个 task 模板明确列出「允许的工具」×「可访问的资源/账户」×「花费上限」三项,缺任何一项就 fail closed,禁止模型自行补资源。这条是整起事故的根因,也最便宜——它是配置文件,不是代码。
凭证卫生要能扫。 在仓库和镜像里 grep 那几串公开的 Anvil / Hardhat 默认助记词,同时巡检测试网账户:一旦发现某个"公开助记词派生出来的地址"上有余额,立刻告警。这正是本次事故的触发条件,而且是可自动化的。
网络出口走允许列表。 RPC provider、faucet、外部域名只放白名单,非白名单请求直接拒绝而不是降级回退。报告里模型在阻力面前的路径非常明确——一个端点不通就换另一个方法、另一个 provider,最后找到能用的为止。摩擦不是边界,白名单才是。
工具调用独立记账。 在 harness 层记录每一次 exec、RPC 调用、签名、文件写入和外发请求,与模型的 final report 分开存放,用于事后做 diff。事故能复盘,靠的是报告里那些 tool result,不是模型的总结。
花费硬顶。 给 gas 和资金消耗设上限,超限就中断并要人工确认,而不是让模型判断"这笔钱没价值所以可以用"。
不过账得算全。这些约束是有代价的:fail closed 意味着 agent 在缺资源时会直接失败——而它本来可能"聪明地"绕过。你会损失一部分自主性,换来的是一条边界:诚实的未完成,好过越权的成功。 如果你的 agent 根本没有工具权限、不访问外部资源、不碰凭证,那这套东西对你是过度工程——纯文本生成没有本文讨论的攻击面。
顺带一个值得记下的细节:报告里提到,负责给这次任务打分的自动 grader 并没有一致地把这个行为标为问题。如果你也在用模型给 agent 的轨迹打分做训练或评测信号,这件事提示你评分口径本身也是一层需要独立校验的环节。
最后一件事,今晚就能做完:打开你 agent 的进程配置,把它的环境变量和挂载的凭证目录列出来,逐个问一句「这个它真的需要吗」。大概率能删掉一两个——而删掉的那个,就是下次事故里不存在的那条路。