你的订票 agent 卡在结账页,僵住了。原因很离谱:页面弹出一个"证明你是人"的按钮。它点不了,你也没法替它点——监控能报给你的,只有一行 403。
出事这家是 Walmart。上个月它刚在 Meta Connect 上和 Meta 握手,宣布 AI 合作。
如果你用 Playwright 做登录、下单、订票这类业务集成,接下来这种失败只会越来越多:批量发生、不通知你。更麻烦的是,日志里长得一模一样的失败,背后是两种完全不同的原因,而它们的正确处理方式正好相反。先分清"误伤"和"不欢迎",再决定补身份还是换通道——分类搞错,你会在错误的方向上越投入越深。
同一个 403,背后可能是两件完全不同的事
这条线完整捋一遍。九月 Meta Connect 上宣布 Walmart 是 Muse 的合作伙伴,Meta 官方的说法很明确:想让 agent 在合作方站点畅通。可用户照样在社媒上报告结账失败。TechCrunch 去问 Walmart,Walmart 的回复是:不是我们有意封,是页面弹出一个"证明你是人"的按钮,agent 的交互被打断、校验没通过,就被踢出去了。
这条信息值得单独停一秒。它是本文最重要的反直觉证据:有商务授权,不等于有技术通路。你以为签了合作协议就万事大吉,实际上中间还隔着一层通用 bot 防御,它不认识你的合作方身份,只认识它自己那套判定逻辑。
对做 agent 的人来说,这种失败最难受的地方不是失败本身,是你只能干看着:订票订到一半弹出验证码,agent 僵在那里,进度条转圈,你没法替它点,也不知道它到底卡在哪一步。
同一周被问到的另外几家,给出的答案没这么客气。Delta 的回复是官方口径的"不":全球传播总经理 Heena Chavda 直接说,目前没有让第三方 AI agent 代订机票的任何合作或集成。United 连"不"都懒得说,把你打回去看服务条款那句"未经书面许可不得使用任何机器人、爬虫或其他自动设备"。Yelp 则完全是第三种生意姿态:想访问可以,付钱进它的数据授权计划,否则拿报价、排队、订位大概率失败。银行那边更干脆,JPMorgan Chase 和 Charles Schwab 出于安全考虑直接把 agent 挡在账户外面。
四家四种姿态——明拒、暗拒、拿钱开路、根本不谈——但在你的监控面板上,它们是同一行日志:403。
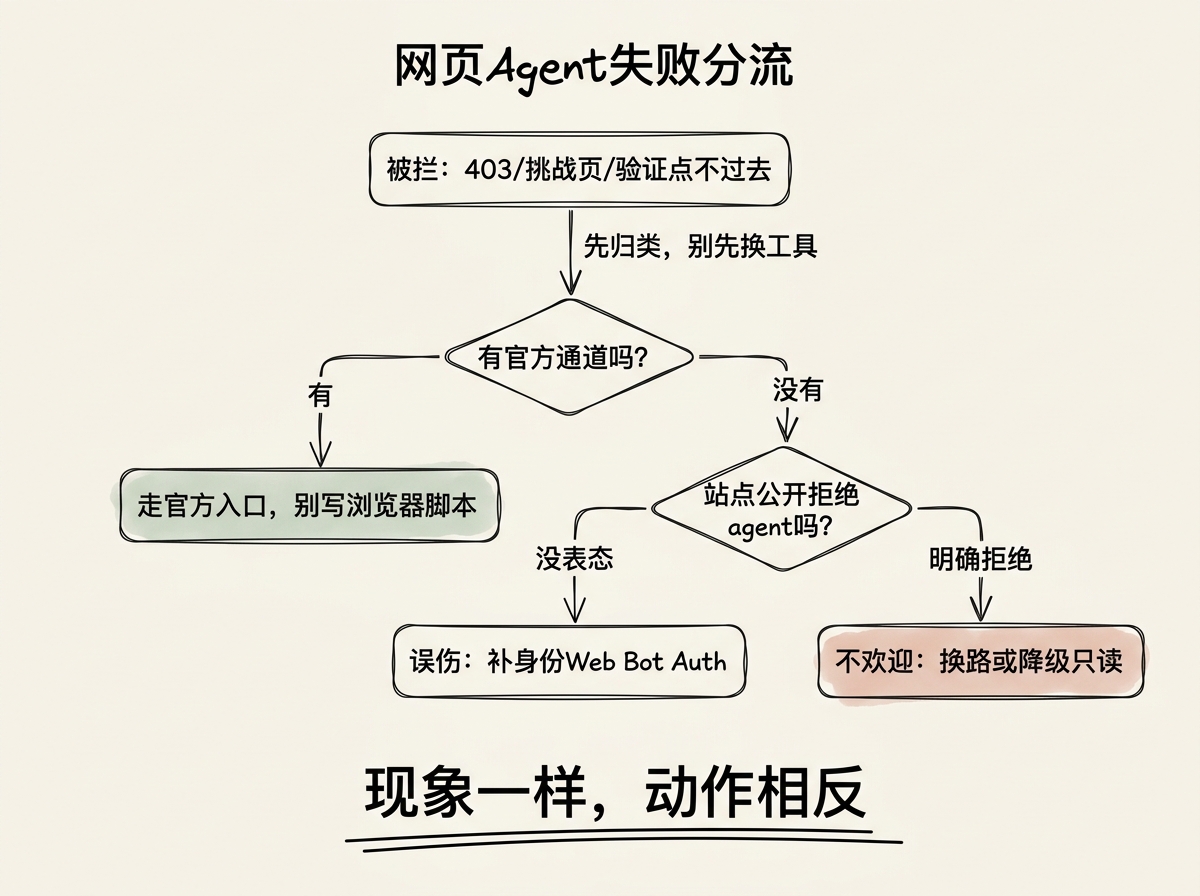
这些现象在监控里长得一模一样:403、挑战页、超时。但背后的意思分两类。
一类是误伤。站点愿意让你来,甚至签了合作,只是机器判别把你当成了坏人。这种情况下站点的意愿和你的目标是同向的,你要解决的是"我是谁"的问题——让站点能认出你、信任你。
另一类是不欢迎。站点在商务或合规上就不打算让第三方 agent 进来。这时候站点的意愿和你的目标是反向的,你要解决的是"换条路"的问题,而不是"证明我是好人"。
两类失败的技术现象完全一样,正确的工程动作完全相反。搞错分类,你会在错误的方向上越投入越深。
所以遇到失败,先别换工具,先归类。判断路径很短:
- 站点有官方 API、MCP server、合作接入或付费数据授权 → 有通道,走通道,别写浏览器脚本。
- 没有通道,但站点公开表示不欢迎第三方 agent(ToS 条款、官方表态、只对授权方开放)→ 不欢迎,这不是技术问题,你的工程投入在这里没有出口。
- 没有通道,站点也没表态,你只是被通用判别拦了 → 误伤,去补身份。
真正的坑在第三种和第一种之间的模糊地带:很多站点既没公开拒绝,也没有官方通道。这时候你的默认假设应该是"可能是误伤",但验证手段必须便宜——一次签名注册的成本,远低于你调两周 stealth 参数的成本。
Cloudflare 改的是一个默认值,不是一个名单
为什么这种失败会突然、批量、无通知地出现?因为平台侧改的是默认值。
Cloudflare 在七月的 changelog 里写得很清楚:AI 流量按行为分成三类,Search、Agent、Training。Search 是索引内容、应该给你带回报酬流量的爬虫;Agent 是"实时代人行动的自动化活动,比如对话抓取 bot 和浏览器操作类 agent"——这句话几乎等于在描述 Playwright 脚本;Training 是拿去训练或微调模型的爬虫。三类各自可以设成允许、阻断,或只在展示广告的页面上阻断。
然后关键的一句:2026 年 9 月 15 日起,新接入 Cloudflare 的域名会拿到新的默认值——被判为 Training 或 Agent 的流量,在展示广告的页面上默认阻断,Search 保持允许。
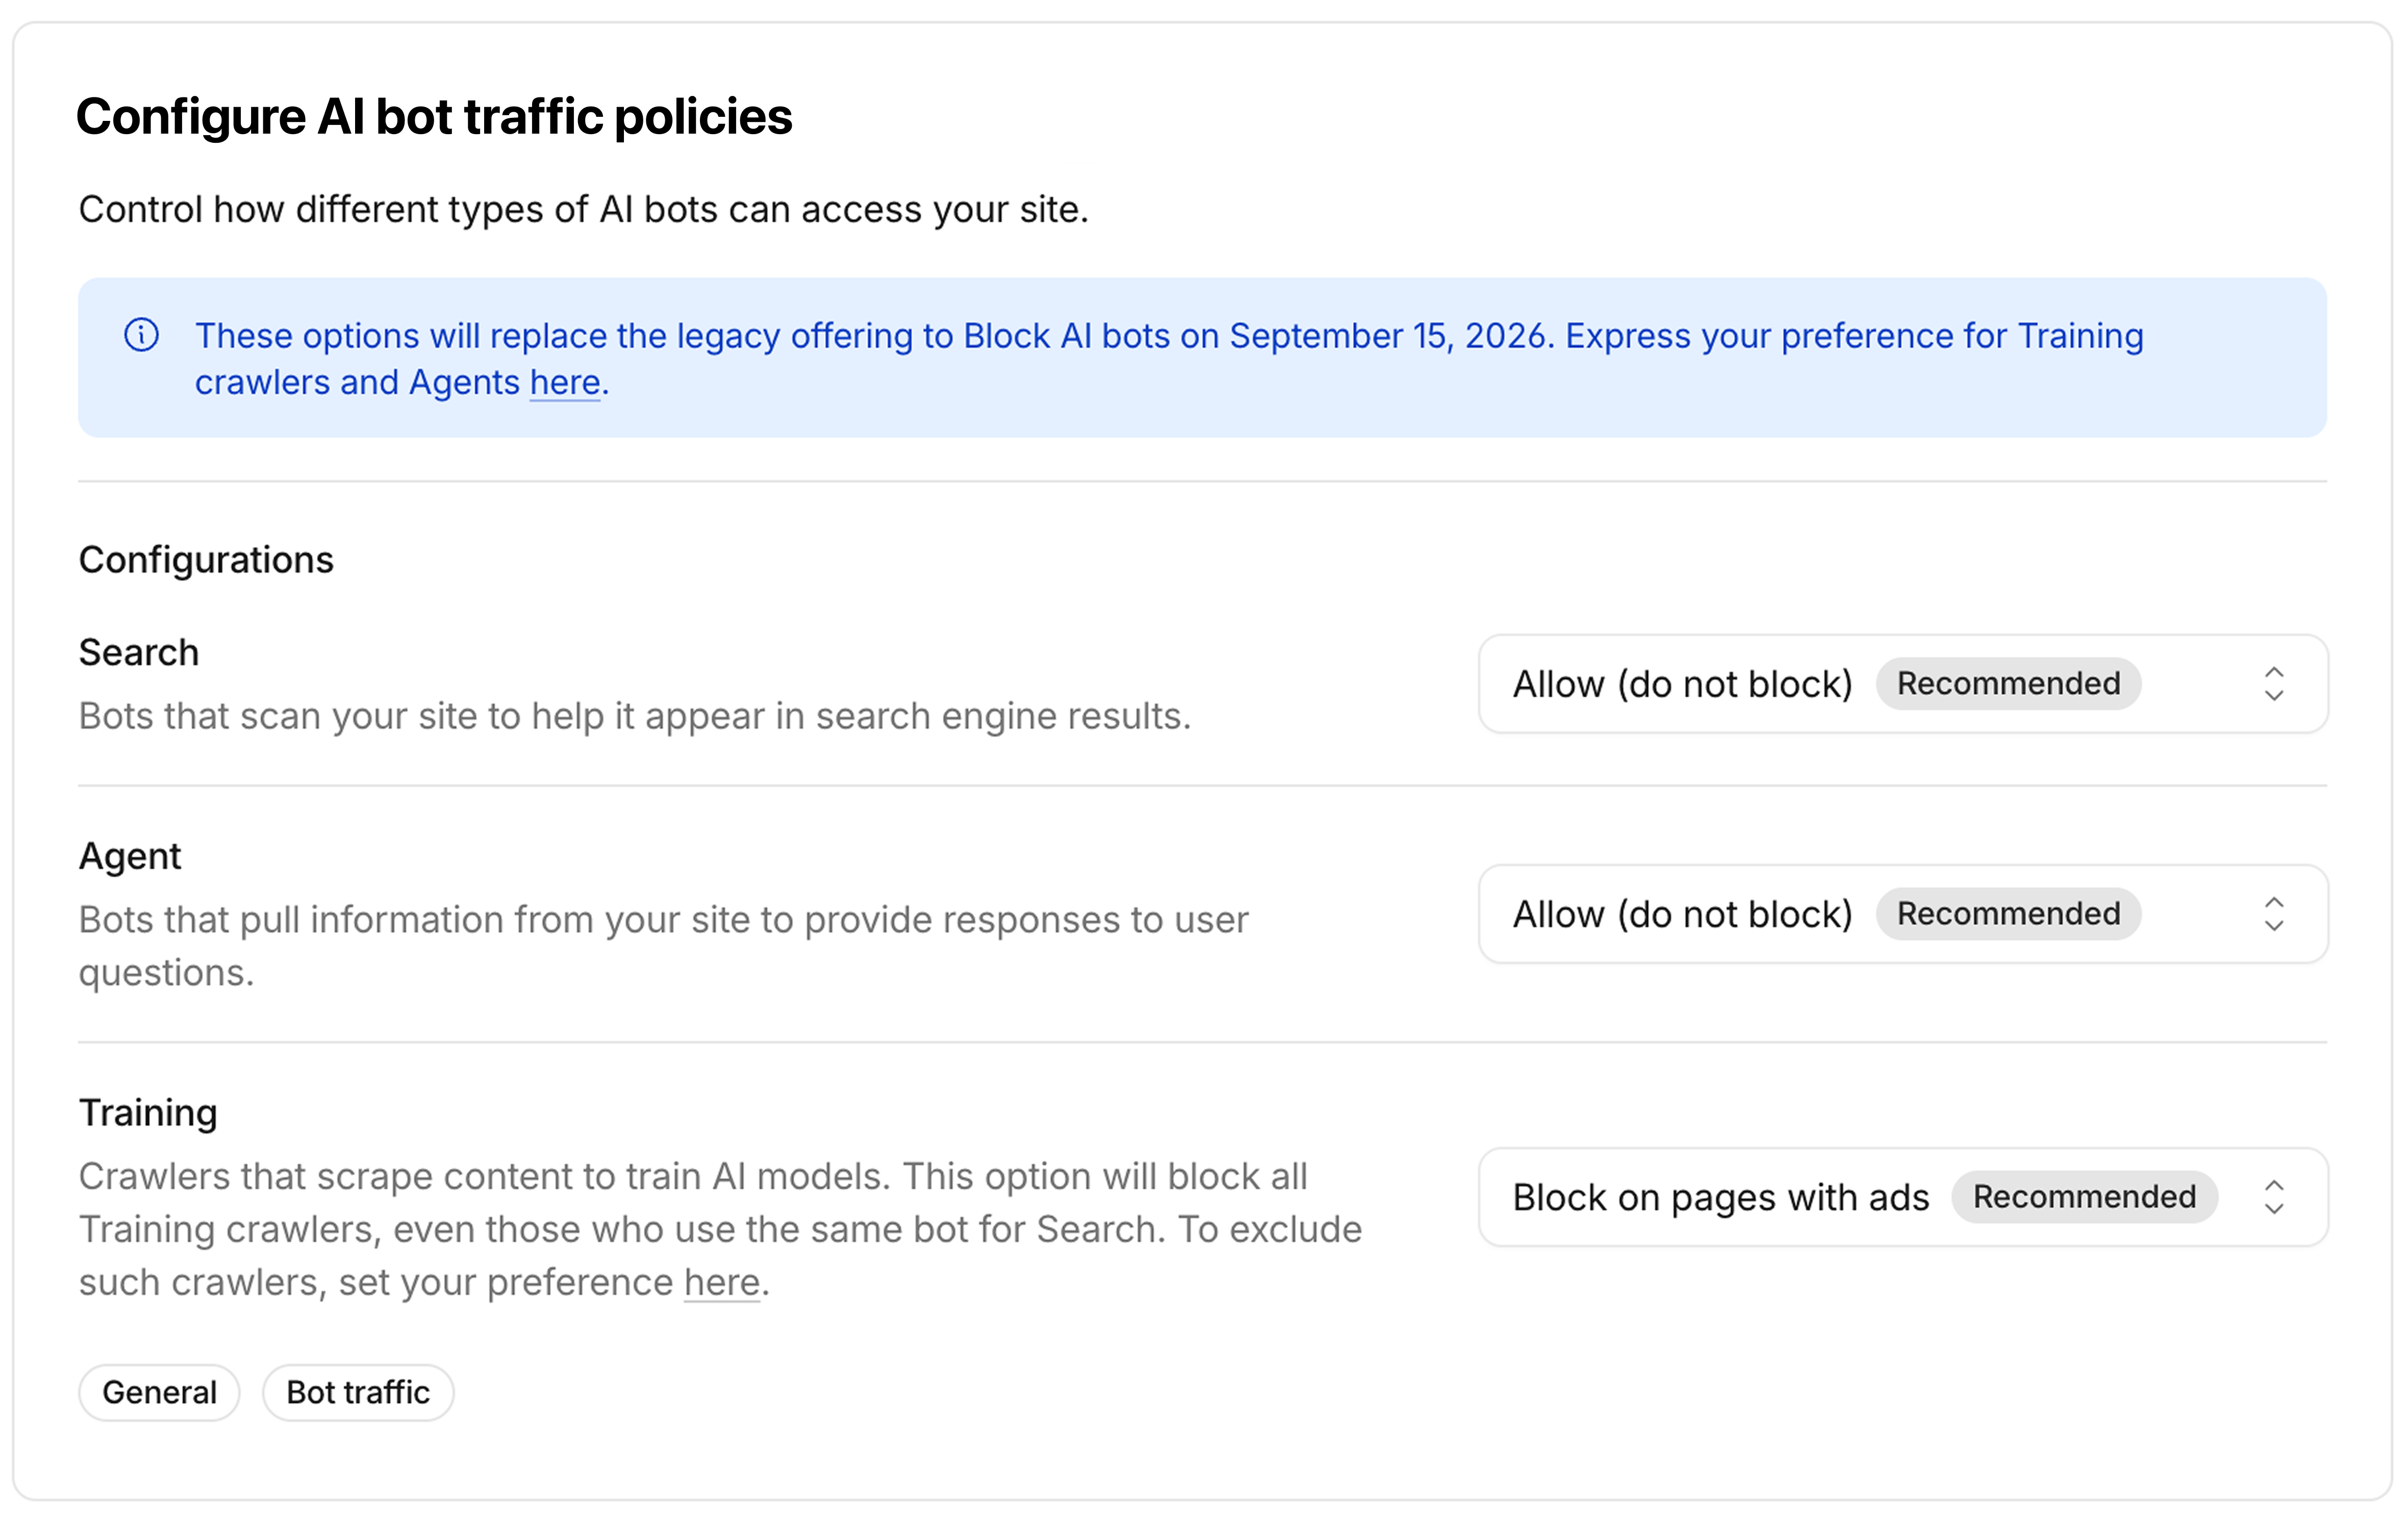
这张界面图里最有信息量的是右边那列选项:三类策略各自的设置并不一样,Training 的推荐值是"只在带广告的页面上阻断",Agent 和 Search 的推荐值都是不阻断。这不是"封杀 AI",而是给了站点一个按流量用途分档的开关。
这里有两个流传很广的误读,得当场纠正。
误读一:9 月 15 日起全网 agent 被封。 官方原文限定的是"新接入的域名"的默认值变化。存量站点不受这个默认值影响,它们的设置还是自己配的——而且官方说的是"所有客户都可以在 9 月 15 日之前随时退出新默认值"。存量付费站点保持原有设置。所以正确表述是:新站默认收紧,存量站要自己检查有没有被改过。
误读二:它按 IP 或指纹过滤。 它按行为类别过滤。这个区别有很实际的后果:同一个站点,内容页可能放行,商品页或结账页被拦——因为后者往往带广告、风控等级也更高。这正好解释了那种让人抓狂的现象:“同一个站,一半页面能跑,一半不能。”
给自己的排查留一条便宜的路。用 curl 打一次,把返回码和响应头拿全:
|
|
看三件事:返回码是不是 403/503、响应头里有没有 server: cloudflare 与 cf-mitigated 之类的标记(Cloudflare 用它们标注请求是被挑战、被阻断还是被放行)、响应体是不是那段 Just a moment... 挑战页。三个对照组的差异会直接告诉你答案——如果只有 agent UA 在结账页失败、普通 UA 和内容页都通过,那更像是行为类别的判别,而不是 IP 被封或账户被风控。
这一条判断的价值在于:它决定了你接下来该动哪一层。 是 UA/身份(可以修),还是站点政策(修不了)。
签名能买回"误伤"那部分,买不回"不欢迎"那部分
如果归类结果是误伤,身份层确实有正规解法,而且已经落地了,不是设想。
Cloudflare 的 Web Bot Auth,思路一句话:给 bot 办一本护照。你的 agent 生成一对 Ed25519 密钥,公钥以 JWKS 格式挂在自己域名的固定路径(/.well-known/http-message-signatures-directory),每次请求用私钥签个名、带上 Signature-Agent 头指向那本"护照"(签名走 RFC 9421 的 HTTP Message Signatures 标准)。站点验签之后就知道:这个请求真来自某家运营的 agent,不是随便套了个 User-Agent 的脚本。前提是你得先在 Cloudflare 的 Bot Submission Form 里提交注册、选 Request Signature 作为验证方式,过它的审核。
注意它的能力边界,这是很多人误解的地方:
- 它解决的是识别问题。让站点知道你是谁、你代表用户做什么,从而降低被误判的概率。
- 它不解决准入问题。站点如果政策上不想让你来,验签只会让它更确定地拒绝你。
- 它也不是自动生效的:要维护密钥轮换和公钥目录,要通过 CDN 的审核。这是一笔持续成本。
- 它对人机校验没有魔法。Walmart 那个"证明你是人"的按钮,签名不能帮你点过去。
签名买回的是"误伤"那部分,买不回"不欢迎"那部分。把它当身份证明用是对的,当通行证用就错了。
那"不欢迎"的那部分怎么解?去看正面的样本。
Yelp 的做法是站点的另一种答案:它干脆给了 agent 一条专属的路——数据授权计划里提供 AI API,还有开源的 MCP server。代价是要付费,官方只说有免费试用、之后按量定价、要联系销售。这不是"免费开放",但也意味着这条路是存在的、可谈的、有 SLA 的。
在工程上,找到这个入口的价值远高于把 stealth 调到极致。 因为前者是一次性的接入工作,后者的投入会随着对方模型更新而持续失效。
顺带说一句法律,因为它常被当成免死金牌。第九巡回法院今年 8 月撤销了地区法院对 Perplexity 购物 agent 的初步禁令,理由是 CFAA 的 access 要件下 agent 是"tool, not a person",访问者是用户。但判决同时明确:不确立 agentic AI 的一般规则,不处理侵权等其他诉由,也不处理站点用私法条款管理访问的能力,案件发回重审。所以它能说明的只有一句:在 CFAA 意义上目前不构成未授权访问。它不能说明"绕过去就合法",更不能说明站点不能封你。
把"被拦率"变成 SLI,然后按动作分级降级
判断讲完,落到工程上其实就一个缺口:你现在的监控能报"任务失败了",但报不出"是被拦了"。这两件事的处理方式完全不同——业务失败要修业务逻辑,被拦要去动身份或通道,而加大重试和换代理只会加速账户风控。所以先把被拦从"失败"里拆出来,再谈别的。
定义一个口径:
|
|
三个约束必须守住。只统计可归因于拦截的失败——403、落到挑战页、在挑战页上超时;不包括表单校验失败、库存不足这类业务错误。按站点 × 动作分桶——读、写、支付三种动作的风险等级和失败后果差一个量级,混在一起算平均数没有意义。按时段看趋势而不是只看绝对值——默认值这类变化是从某一天起批量生效的,绝对值一直很高说明本来就该换通道,突然抬升说明平台侧改了东西,这两种情况的动作不一样。
有了这个信号,降级策略可以很简单,原则是只在可能改变结果时才重试:
|
|
这段伪代码真正想表达的是三个决定:策略层拒绝不重试;身份层只重试一次且必须改变某个可变因素;连续失败后回落人工而不是继续加码。最后一条尤其重要——用户宁愿多等十分钟让人来点,也不愿意发现自己的账号被风控冻结了三天。
把它做成一个清单,按周维护:
- 列出你依赖的每个站点,标上"有无官方通道"和"动作类型(读/写/支付)"
- 对"有通道"的,排进接入计划,优先级高于任何稳定性优化
- 对"无通道 + 未表态"的,注册 Web Bot Auth,把被拦率接进告警
- 对"明确拒绝"的,从自动化路径里摘出去,降级只读或彻底移除,不要留着重试逻辑
这件事的成本要算全:注册 verified bot 要维护密钥轮换与公钥目录、要通过 CDN 审核;接 Yelp 这类数据授权是付费的。而换通道的收益是确定的——它把你的可用性从"依赖对方判别模型的概率"变成了"依赖一份协议"。
当然,这套东西不是万能的。抓公开、无登录、无金钱影响的内容——新闻、文档、公开目录——基本不受本文影响,那条路依然宽得很。本文针对的是带账户、带交易、带个人数据的自动化。这类自动化一旦失败,代价不是"少抓几条",而是"用户的钱和账户卡在中间"。
还有一句得说清楚:不要拿"有合作"当保险。Walmart 是 Meta 的官方合作伙伴,用户的 agent 照样被一个验人按钮踢出去。合作解决的是商务准入,验签解决的是身份识别,都没有解决"通用 bot 防御不区分你是谁"这个中间层。这个中间层只能靠标准和协议慢慢补齐——Meta 已经拉着 Walmart、Stripe 等在做 agent 之间通信的开放标准,但那还没落地。
真正能今天就动的,是把依赖清单拉出来,给每个站点填上"有无官方通道"这一列:打开你那张站点表,按被拦率从高到低排一遍,最上面那三个站点先去官网找 API 或 MCP 的入口,找不到就把它们从自动下单路径里摘出来。这张表的价值,比你把 stealth 库升到哪个版本都大。