老板把一条链接甩进群里,问能不能上、能不能省钱。链接是 DeepInfer,DeepSeek 上周开源的内部推理框架,三天涨到两万一千星。
你打开 README,看见两句话挨在一起。第一句说这是支撑 DeepSeek 大规模生产服务的那套框架。第二句说完整推理服务所需的组件不在本次发布中。
底下还跟着一句,支持的硬件只有 NVIDIA SM100 和华为昇腾 950。
这两句不矛盾,但它们决定了你今天该干什么。
对绝大多数团队,答案是先别部署。可我读完整个仓库和官方 Q&A 后,反而觉得它比新闻里说的更有用。只是有用的方式跟"换掉 vLLM"完全无关。
我这边没有 SM100,也没有昇腾 950,下文关于跑起来的部分全引自官方文档,没有一句是我的实测。
它不缺功能,缺的是把你的请求接住的那一层
先看它给了什么。README 列出来的能力其实不短:优化过的内核、MoE 专家并行加 EPLB、DSpark 推测解码、SWA 有界重放、异步调度、batch-invariant 推理、确定性采样、结构化输出。
这些全是引擎内部的事。算子怎么算得快,专家怎么摆得匀,草稿 token 怎么验证。
再看缺什么。官方写得也很直白:一套 KV cache 系统、VE/Prefill/Decode 分离部署、prefill 与 decode 两边跨数据并行副本的负载均衡。三样都没有。
按官方 Q&A 的说法,缺的原因是这几块与内部基础设施耦合太深。换个说法可能更清楚:引擎解决"一个请求算得多快",服务解决"一万个请求同时来,谁来接、接到哪、前面算过的哪些能复用"。 前者是代码,后者是运营。
有意思的地方在官方那张参考架构图里。图上 Entrypoint 在,四个负载均衡器在,右侧还挂着一个"External KVCache Storage (3FS)"。
官方画的完整形态里,缺的那三件都在。
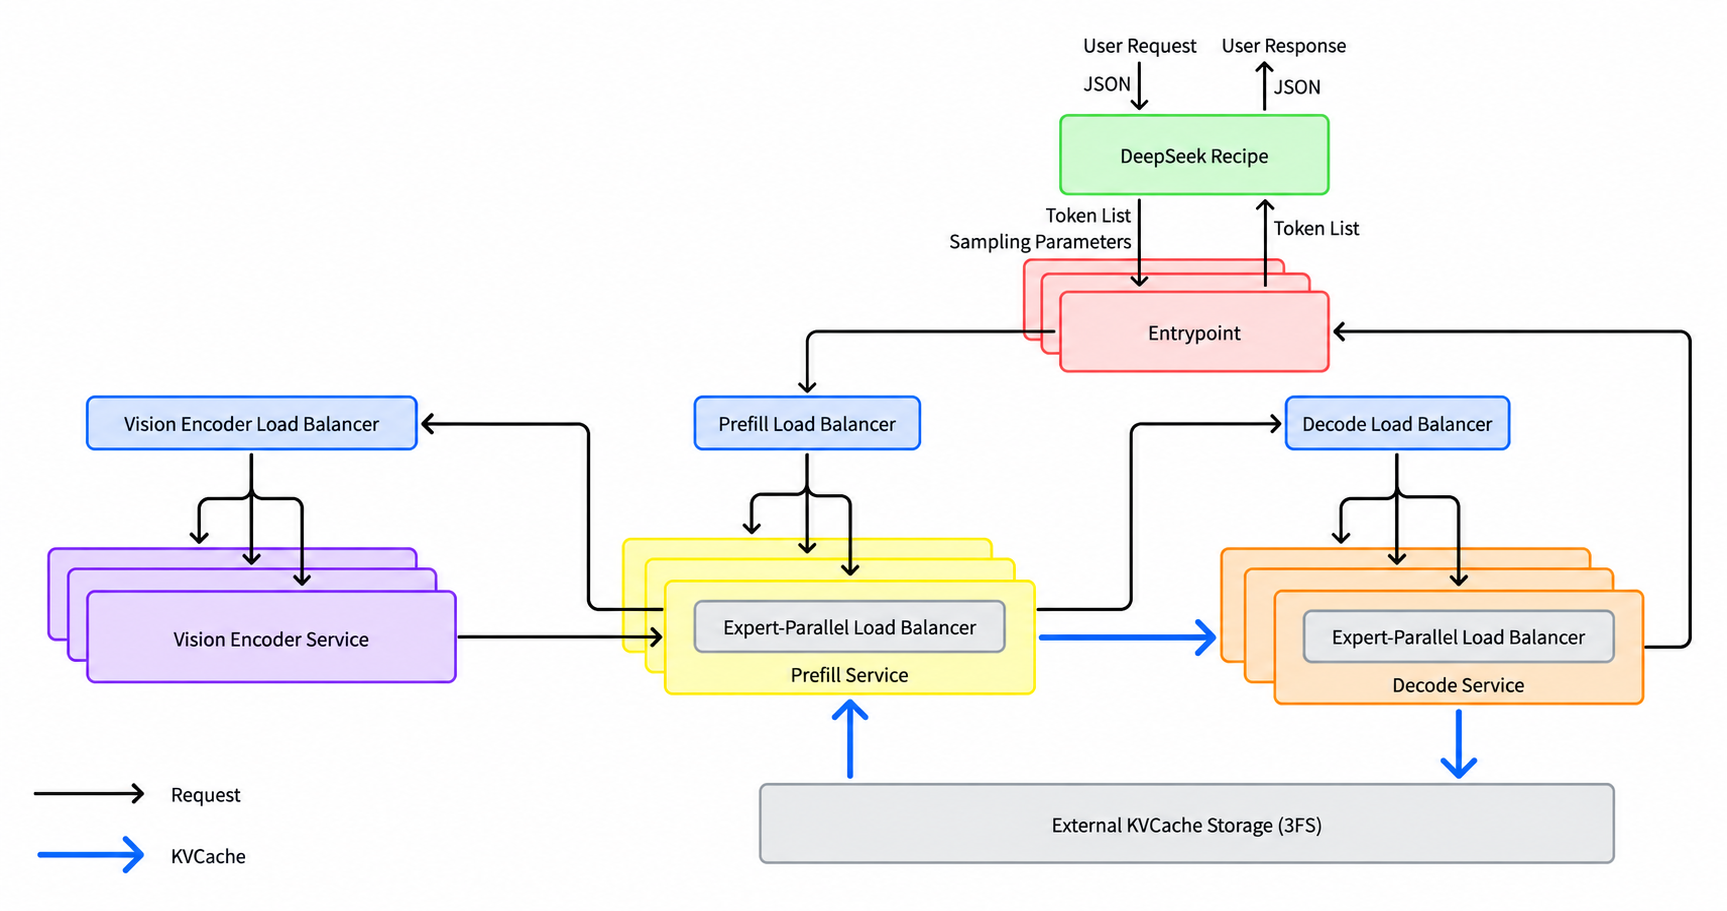
图看的是完整系统长什么样,代码给的是其中一块。两句话都真,只是被放进同一篇 README,读快了会以为打架。
那这一块本身是不是真的完整?看 benchmark 的口径能反推出结论。官方那两张吞吐曲线,prefill 用 4 张 SM100 测,decode 用 64 张。
两边分开测、分开配卡。
一个把 prefill 和 decode 分开测的框架,却说自己没给分离部署——那缺的不是引擎,是把两边串起来的胶水。
自己补这三件,账单是 64 加 64 张卡
把缺口量一下,事情就清楚了。
官方 Q&A 里有一句容易被漏掉的话:1P + 1D 就能部署,实践中 P 和 D 的卡数比大约 1:1。
紧接着下一句才是重点。因为推荐的 decode 配置是 EP64 及以上,所以最小的高效部署单元是 64 张卡做 prefill,再加 64 张卡做 decode。
前面那句和后面那句都要给。只引后面那句,会把"128 张"说成入门门槛。它其实是性能门槛。
存储这边更具体。KV cache 走独立的 3FS 集群,官方给的经验值是每张在线 GPU 对应约 14.4TB 逻辑容量,物理容量还要更大。数据按 10+2 纠删码存,一个 EC 组能扛两台节点同时挂掉。
整个集群规模约 100PiB SSD。agent 流量 TTL 3 天,chatbot 流量 7 天。
再往下是负载均衡的自我评价。官方说,他们能到"完美均衡的离线基准"的大约 80%。
这句话值得停一下。一家公司公开说自己最好的调度策略只到理论均衡的八成,这不是谦虚,是把上限先划给你看。你自己补那三件,起点在这里,而且没有他们的机房和流量。
对做服务的团队,这节大概最该抄。不是因为数字能照搬,而是因为它把推理成本拆成了几块可以分别优化的东西——阶段分开、缓存外置、专家摆匀。你现在这套服务卡在哪一块,是能对出来的。
不过硬件这关得先过。支持列表只有 SM100 和昇腾 950,CUDA 13 或 CANN 9.2,GCC 13 以上,Python 3.12。Hopper 不在名单里。
我特意把上面那句写成"不在支持列表内",没写成"跑不了"——前者是官方文档的事实,后者我没验证过。可对做上线决策的人来说,两个说法落到同一个结论:SM100 和昇腾 950 之外的卡,今天没有可走的路。
真正能带走的不是引擎,是那四个开关的语义
到这里多数人该退场了。但仓库里有几处东西,跟你的卡是什么型号无关。
第一个是 batch-invariant 推理,DEEPINFER_BATCH_INVARIANT=1,官方标注 NVIDIA only。它保证的是:同一个 prompt,不管这一批里还塞了谁、batch 多大,模型给出的结果一致。
线上那个老问题就出在这儿。压测时 batch 小,答案对。上量以后 batch 变了形状,少数请求开始飘。
你去翻日志,日志干净。你去重放,重放不复现。因为变量根本不在你的代码里,在这一批的组成里。
第二个是确定性采样。官方给的条件三件同时成立:DEEPINFER_BATCH_INVARIANT=1、DEEPINFER_ENABLE_MTP_VARLEN=0、给 SamplingParams 传固定的 seq_seed。
注意第二项。关掉变长投机解码,等于放弃 DSpark 那 4 到 7 个点的吞吐。这是官方按 EP64/DP64、每 rank 约 60 并发算出来的生产工作点。
为了逐 token 可复现,你要付这笔钱。
第三个是 SWA 有界重放,默认参数是 DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact 加 DEEPINFER_YOCO_PREFILL_KEEP_TOKENS=140。
140 这个数字不是拍的。Q&A 里写,一个长度为 L 的输入,最大可命中长度是 L 减 134。128 是重算窗口,6 是投机解码的回退余量。
官方另一处写的是"只重算最近 128 个 token"。140 和 128 差的那 12,不是玄学,是缓冲区。
第四个是结构化输出。so_args={"schema_type": ..., "schema": ...} 塞进 SamplingParams,支持正则、JSON schema、EBNF 三种。
仓库自带的例子很好懂。一个正则约束 [A-Z]{2}-[0-9]{3},一个 JSON schema 限制颜色和数量,一个 EBNF 只允许 answer=yes 这种形状。
它约束的是采样那一刻,不是生成完再拿正则去修。
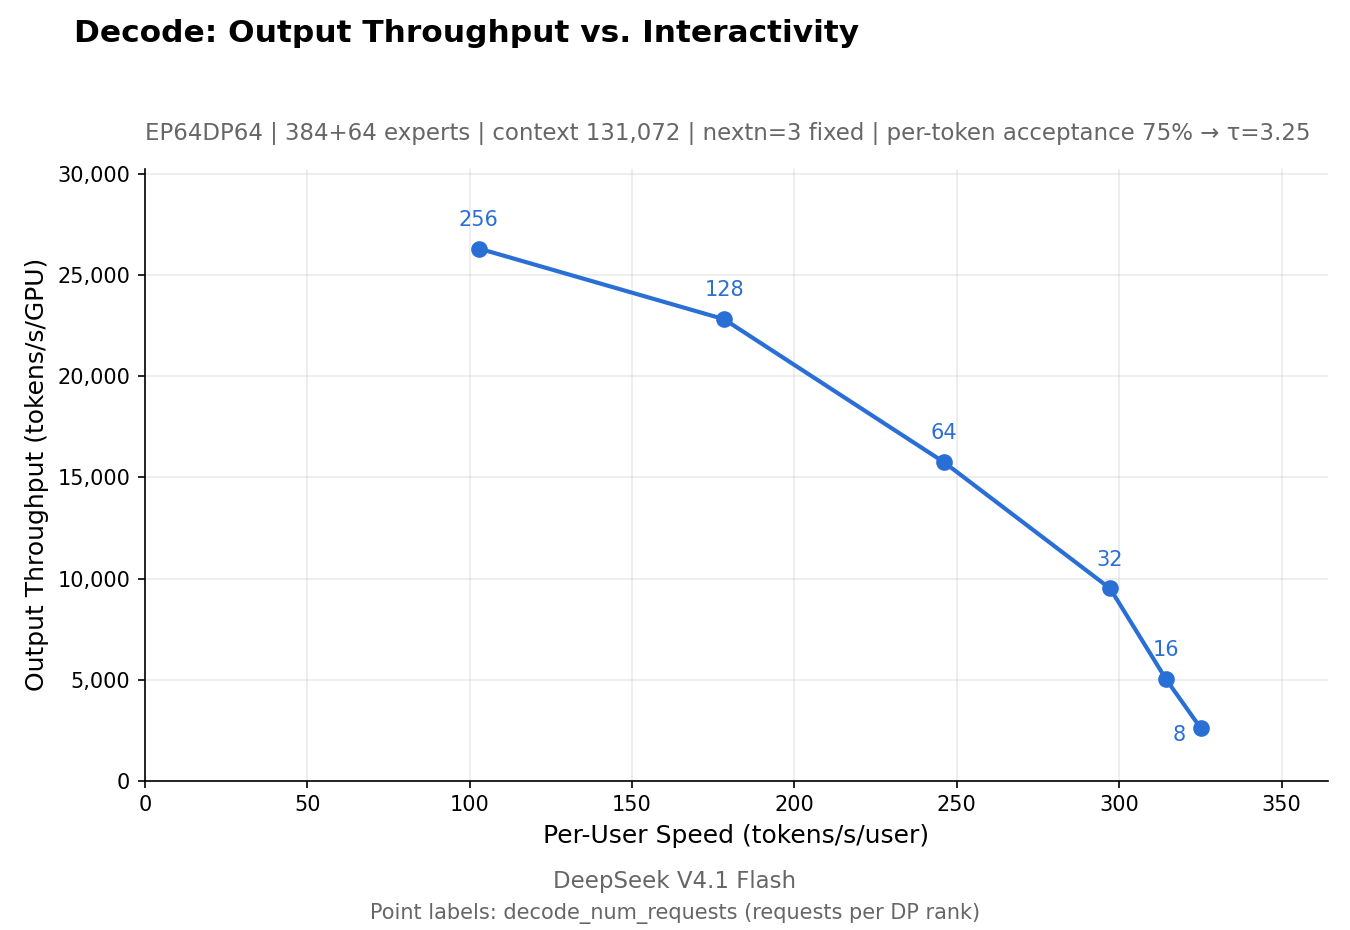
这张图的配置要一起读:EP64DP64,384+64 个专家,上下文 131,072,nextn 固定 3,接受率 75%。
官方标注每 rank 256 个请求那端,单卡输出吞吐到 25,000 token/s 上下,单用户速度约 105 token/s。每 rank 8 个请求那端,单用户能到 325 token/s,吞吐掉到两千多。
同一个引擎,两头差十倍。所以"每卡 25000 token/s"这种数字单独拿出来没有意义,它旁边永远得跟着一个用户等多久。
这些曲线都是 DeepSeek 自报,离线 benchmark,跑在 64 张 SM100 上,没有第三方复测。我核到的就这些,多的没有。
vLLM 那边有个同名的 VLLM_BATCH_INVARIANT=1,官方自己标 beta,也明说会掉性能。坊间流传的一组对比是同一任务默认 26 秒、换确定性内核 42 秒。
这组数字不是 DeepInfer 的,只能当量级感受,别写进你的容量规划。
你要是真想跑,先看硬件,再看这个数字
按手里的卡分三条路,每条都短。
手上有 SM100 或昇腾 950,且任务是离线批处理,可以试。
仓库里的 examples/sweep/run_sweep.sh 就是官方扫曲线用的脚本。它按 decode 一批 8、16、32、64、128、256 个请求走一遍,结果写成 jsonl。拿你自己的 prompt 重跑,就知道那 25,000 落在你业务的哪一点。
手上有 SM100 但要做在线 API,就当参考设计读。三样缺口自己补,等于重做一遍 GPU 调度。这个工作量不在"接一个框架"的量级。
只有 H100/H200/A100,直接换目标,去读 deepseek-recipe。
它管的是把各种 API 协议和 token 序列对齐成官方那套行为,MIT 协议,Rust 实现带 Python 绑定,明确写着推理、工具执行和 HTTP 传输由调用方提供。
自建部署的结果跟官方 API 对不上,根因经常在这个环节,不在算力。
还有一个数字我核了两遍。仓库 2026-10-16 建,到今天只有四次 commit,零个 release,零个 tag。
GitHub 上挂着两百个 open issues。我一条条拉下来,全是社区提交的 PR,真正的 issue 一条也没有。有人在加 Mooncake 存储,有人在试 Apple 的 MLX,有人把单卡适配到了 RTX 5090。
这不是"别用"的理由。它意味着这仓库现在适合读,不适合押。
读的入口我推荐 doc/inference_deployment_qa.md。那里面没有一句在讲愿景,全是标定参数。
4 档上下文分桶、EP64 下每卡配几个冗余专家、moe_lb 实测 1.090、存储服务器 20 块 SSD、跨机房每 8 张卡预算 400Gbps。
这份文档的信息密度,比外面几十篇解读加起来高,而且免费。
至于那个"155 万亿 token/日、每卡时 38 美元"的营收口径,以及有人在 HN 上算出的 82% 毛利,我核不到原始数据。
HN 那 2341 分、861 条评论里,大部分争的也是这个。有人直接说,你没法拿十几张 H100 跑出生产服务,等能跑了再叫醒我。评论里的推演我不往这篇文章里搬。
先量一次你自己线上的 batch 组成,再看一眼 140 和 134 差在哪。