评测集上个月 62.3,这个月 61.8,代码没改,模型没换。你把那条掉分的 case 捞出来,用同样的 prompt 在本地跑五遍,五遍五个结果。
多数人的处理方式是加个 temperature=0,或者干脆认了:“大模型本来就有随机性。“然后重试取多数、放弃分数的可比性、线上 badcase 复现不了就搁着。
DeepSeek 上周把内部推理栈 DeepInfer 开源了。仓库七天涨了 17757 star,但 HN 上 881 条评论大半在争"推理到底赚不赚钱”。夹在中间真正值钱的东西只有一句 README 注释:把 DEEPINFER_BATCH_INVARIANT=1、DEEPINFER_ENABLE_MTP_VARLEN=0 和固定的 seq_seed 三项同时满足,才能拿到逐 token 可复现(并且注明 NVIDIA only)。
因为"确定性"从来不是一个开关,是三层互不包含的性质。 这篇文章把它拆开,给你一张能对着自己启动脚本查的表。
先划清边界:这套栈门槛很高——SM100 或 Ascend 950、GCC≥13、Python 3.12、CUDA 13 或 CANN 9.2、源码编译没有 pip 包,只支持一个默认 checkpoint。绝大多数人的机器跑不了,也别为这个迁移框架。 但"确定性分几层"这件事,跟你用什么框架无关。
temperature=0 只关掉了采样噪声,没关掉算术
大部分人脑子里的随机性来源只有一个:采样。温度不为零,每次都从分布里抽签,所以结果不同。温度归零,永远取 argmax,于是"确定"了。
这个理解只覆盖了第一层。
实际上一路走到 token id 出来,至少经过三个会引入不确定性的地方:
采样层。从 logits 里挑哪个 token。这里的随机性来自随机数生成器的状态。
前向层的浮点归约。GPU 算矩阵乘、算 attention,是把很多数加起来。加法在浮点里不满足结合律,那么一批数据切成几块、哪一块先累加,末几位就不一样。末几位一旦不同,两个非常接近的候选 token 的排序可能翻转——于是 argmax 给出不同的 id。这就是为什么 temperature=0 不等于可复现:你关掉的是抽签,没关掉算术。
硬件与并行度层。换卡、换驱动、换 CUDA 版本、换张量并行度,数值全部重新洗一遍。
三层互不包含。第二层对了第一层不对,结果照样飘;第一层第二层都对了,换台机器还有可能漂。
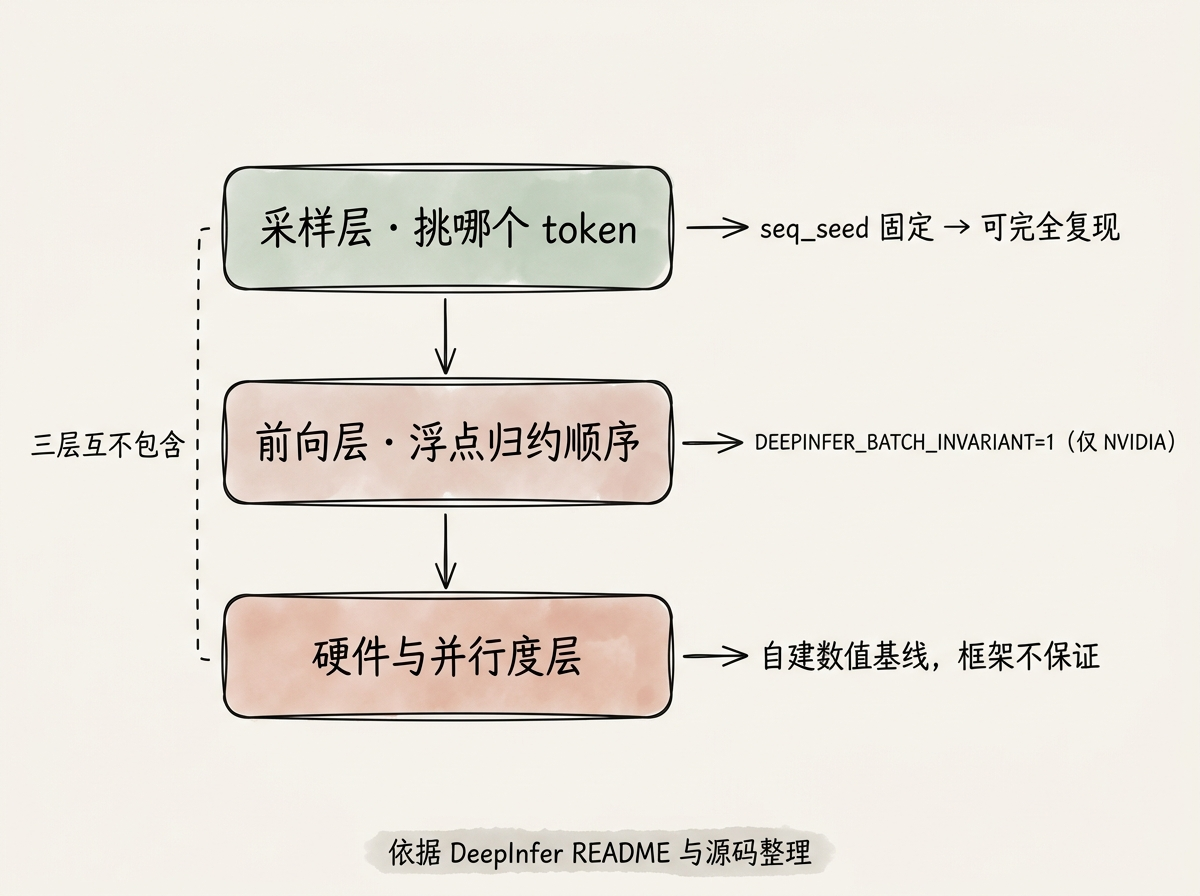
图注:每一层的不确定性由不同东西决定,所以开关也必须分开验收。依据 DeepInfer README 与源码整理。
把确定性当成"这一项解决了没有”,你永远查不到是哪儿漏的;把它当成三层,你才知道该在哪一层下断言。
采样能被钉死,因为每个 token 只用自己那把钥匙
DeepInfer 的采样实现里有一句 docstring,写得非常坦白:
|
|
可复现的输入是三个:seed、位置、是否在投机解码的草稿阶段。输出跟 batch 大小、行顺序无关。
为什么它天生跟 batch 无关?因为实现里每个 token 行开一个独立的 CTA,各自初始化自己的随机数流:
|
|
随机数种子不是"一批里第几个",而是"第几个位置"。第 7 个 token 的钥匙,不管这批是 1 条还是 8 条,永远是同一把。N_CHUNKS = ceildiv(vocab_size, BD) 这个切分参数只跟词表大小有关(vocab ≥ 8192 时走 threads=256、bd=2048),跟 batch 无关。所以这里不存在"整行跨 CTA 归约"的操作,也就没有归约顺序可变这回事。
is_nextn_predict 那一位要单独换条流,是为了避免投机解码的草稿 token 跟正式 token 在同一个位置上拿到同一把钥匙——不然草稿和验证会用同一组随机数。
这一层为什么容易做对?因为它没有跨行归约,天然批不变。而前向层不是。
反过来说:这一层如果没配好,你连第一层都不算开了。 sampling_params.py 里 seed 的处理是这样的:seed=None 时用 random.getrandbits(64) 现生成一个。你不传 seed,它不会报错,也不会警告,就是每请求随机一次。
要钉死前向,就得钉死归约顺序——这就是 NVIDIA only 的来由
前向层的不确定性,来源是把归约切成几块。split-k 这类 kernel 会按当前 batch 的形状决定切分方式:同样一个矩阵乘,batch 里塞 1 行和塞 8 行,可能选到不同数量的 split,累加顺序跟着变,浮点末几位跟着变。
要让结果跟 batch 组成无关,只有一个办法:把切分方式固定死,不管这一批多大多小都用同一套归约树——也就是 batch-invariant。这样做等于放弃掉一部分动态调优的空间,有些形状会更慢。
README 明确标注 batch-invariant 只在 NVIDIA 上提供。Ascend 侧能跑这套栈,但这个性质没有承诺。 HN 上有条评论问 Ascend 950 的采购价,没人回答——成本数据目前是空白。
NVIDIA 也有个例外:官方 Q&A 文档自己承认 decoder 侧的 SWA replay 用的是 approximate SWA KV cache,只重算最后 128 个 token(精确重建要 2560 token × 20 层)。这是近似值,跟 batch 无关——意味着即使你把两个开关都开了,换机器、换上下文长度的边界,分数仍可能动。
顺带说一个容易被忽略的读法:这套栈开源了三块关键组件没给——KV cache 系统、E/P/D 分离、DP 负载均衡,官方原话是这三块"tightly coupled to our internal infrastructure"。所以它是能跑通的推理引擎,不是能直接替掉你线上 vLLM 的完整服务。
官方把「数值变了」做成了要走流程的变更,而它的示例脚本还没走这条路
这套栈里我最认同一件事,是它怎么对待"数值变了"。
仓库里有一份 PPL 基线文件,注释写着逐样本精确比较(compared exactly sample by sample)。要改基线不能手改 JSON,得跑 refresh_offline_decode_ppl.py 重新生成;那个脚本的 --output 参数只支持单节点,多节点会直接报错让你走默认路径。
翻译成团队语言就是:数值变化是要签字的。 你在用自己的推理栈,也可以抄这个制度——把"某次升级后评测分数变了 0.5 分"从"大概是随机波动"变成"谁的 PR 动了它,给个理由"。
但有意思的地方在下一层。
README 给的确定性条件是三项同时成立:BATCH_INVARIANT=1、MTP_VARLEN=0、固定 seq_seed。
我去翻了它的示例脚本:
offline_inference.py里确实设了BATCH_INVARIANT,但写法是setdefault,而且加了if accelerator_kind() == "nvidia"的判断——非 NVIDIA 静默跳过,不报错。_prompts.py里确实给了seq_seed=i。- 但整个 examples 目录 grep 不到
MTP_VARLEN。_config.py里只 setdefault 了USE_NEXTN_DECODE=5。
按 README 的字面条件,这条示例路径只满足了"两条半"。这不构成框架的 bug——示例脚本不是评测脚本,严格度本来就不一样。但足够说明一件事:“仓库提供了这个能力"和"你的运行路径享受到了这个能力"之间,隔着一段没人替你填的距离。
顺带提一句它的测试:tests/models/test_sampler.py 是验采样分布正确性的,它自己也设置 BATCH_INVARIANT=1,但它验的是"从分布里抽出来的东西分布对不对”,不是"两次运行逐 token 一样"。别把测试通过当成确定性成立——这两件事在同一份代码里,但不是同一件事。
你能抄走的不是那两行变量
先给那张表。四类不确定性,逐个说清谁管、怎么验:
- 采样噪声:由随机数流决定。验法:固定
seq_seed跑两遍,比token_id。拿不到固定 seed 的 API,这一层就无解——很多托管服务根本不让你传 seed。 - 前向浮点:由 kernel 归约顺序决定。验法:固定 seed 和 prompt token ids,跑两遍不同
max_num_seqs(1 和 8),比token_logprobs。 - 并行度变化:由张量并行/数据并行配置决定。验法:改一次并行度,跟基线比 logprob。这一层没有框架级开关,只能靠自建基线。
- 硬件驱动变化:换卡、升 CUDA、升驱动。验法同上。这一层连 batch-invariant 都保不了。
这张表最有用的一条,是那个二分法:
两次运行序列不一致 → 采样层出了问题。序列一致但 logprob 不一致 → 前向层在漂,采样层是干净的。
这比"跑一遍看着差不多"有用得多,因为它直接告诉你去翻哪个开关。前者查 seed 有没有传、MTP_VARLEN 有没有关;后者查 batch 是否变了形状、并行度有没有动。
第二个能带走的是启动脚本体检。四条 grep 就够:
BATCH_INVARIANT——有没有设?设了是不是setdefault,被别处覆盖了?MTP_VARLEN和USE_NEXTN_DECODE——投机解码是开着还是关了?seq_seed——是每请求固定传的,还是落到默认路径随机生成?- seed 从哪来——如果代码里有
seed=None,它实际是getrandbits(64)。
最后这条最阴。它不报错,不警告,跑了也不异常,只是你所有关于可复现的假设都失效了。
至于性能代价,诚实讲:MTP_VARLEN=0 等于放弃变长验证的收益,官方 benchmark 表里 conc=16 时是 −1.5%、conc=60 时 +5.4%、conc=96 时 +11.0%(EP64/DP64 配置)。低并发几乎不亏,高并发才疼——所以小集群做评测和回归时开着确定性,生产高并发关掉,是完全说得通的用法,不必一刀切。
那谁该认真对待这件事?
8 卡自建的团队:你现在拿不到 batch-invariant(那要 SM100,且这套栈门槛不止于此),但你今天就能做的是两件便宜事——写一个"同 prompt 跑两遍比 token id"的脚本进 CI,把数值变化当变更管理。这两件不需要换框架。
几十卡以上的推理平台:batch-invariant 才有讨论价值,因为你们的 batch 形状在动态变化,split-k 切分跟着变是真实存在的分数漂移源。但也别急着迁——它只支持一个模型,缺 KV cache 与 PD 分离、缺 DP 负载均衡,这三块恰恰是生产里最难自己补的。
对绝大多数人,正确的动作是去 grep 自己现在的启动脚本。你可能发现你以为开着的确定性,压根没开;也可能发现你从来没传过 seed,一直在拿随机的钥匙,跟"模型本来就有随机性"这个说法和平共处了半年。