你的 LLM 服务跑几天 RSS 就单调上涨,重启一下曲线又平了,过几天再涨——这类问题最烦的地方不是它难修,而是它根本不报错。openai-python 3.16.2 修掉的正是这一类泄漏:responses.parse() 每次调用都新分配一个 pydantic 校验器,直到进程 OOM。如果你在写长驻的 Python 服务、用 text_format= 拿结构化输出,这篇值得花十分钟看完——它讲清一条完整的链条,也给出你自己代码里怎么查同类问题的方法。
RSS 斜率才是证据,火焰图只是把嫌疑犯指出来
先把「内存涨了」这个模糊感受变成可证伪的观察。
issue #3084 的报告者(2026-04-14 开)用的手段很朴素:给进程做内存火焰图,发现 pydantic 模型对象在反复残留。火焰图的作用不是给出结论,而是把嫌疑范围从「整个服务」缩到「某条构造路径」。真正定案的证据是另一件事——稳态 RSS 的斜率。曲线是不是随请求数线性上涨,决定了这是泄漏还是正常的高水位缓存。
这里有个反直觉的地方,值得单独拎出来。8 月 31 日,一位生产用户在 issue 下留言说他们「hundreds of requests on macOS and in Docker and they all stayed flat」,本地怎么压都压不出来,只有在 Cloud Run 的真实流量下才暴露。9 月 13 日另一位用户(跑 Google ADK agent 服务,openai==2.54.0)给出了更细的数字:他们的服务每 15–50 分钟就撞上自己设的回收阈值,最后是靠给 pydantic._internal._model_construction.ModelMetaclass.__new__ 打桩、每次新建类就记调用栈,才在约 20 分钟内抓到 parse_response 和 handle_event 在反复触发。
为什么本地压不出来?因为这类泄漏的量级是「每次调用残留一点」,短生命周期进程、跑几百次请求的脚本、甚至继承上下文复用的测试环境,都等不到曲线抬头。测试环境太友好,本身就是一种观测盲区。
内存问题里最贵的不是修复,是发现。等你看到 OOM 的时候,你已经损失了五个月的排查窗口。
model_rebuild 返回 False 的时候,pydantic 什么都没说
现在拆机制。这条链的每一环都能在一手材料里对上。
parse_response() 在 src/openai/lib/_parsing/_responses.py 里调 construct_type_unchecked,传进去的是三个带自由 TypeVar 的泛型类:
|
|
TextFormatT 是模块级的自由 TypeVar。pydantic 解析不了它,于是 model_rebuild(raise_errors=False) 每次调用都返回 False。
关键在下一步。我直接读了 pydantic 的 _internal/_mock_val_ser.py,MockCoreSchema._get_built() 的实现是这样的:
|
|
_built_memo 只在重建成功(schema is not None)时才写入。 重建永远失败,缓存就永远为空,于是每次访问都重新走一遍重建,每次新分配一个 Rust 侧的 SchemaValidator/SchemaSerializer。这些对象不会自己消失,于是 RSS 随请求数线性增长。
注意这里没有任何一方「做错了」。pydantic 的缓存假设是「重建要么成功要么报错」,raise_errors=False 把报错这条路径静默掉了;SDK 的泛型写法在静态类型检查下完全正确。问题出在两者的接缝上:一个被设计成静默的失败路径,让一个错误在五个月里保持隐形。
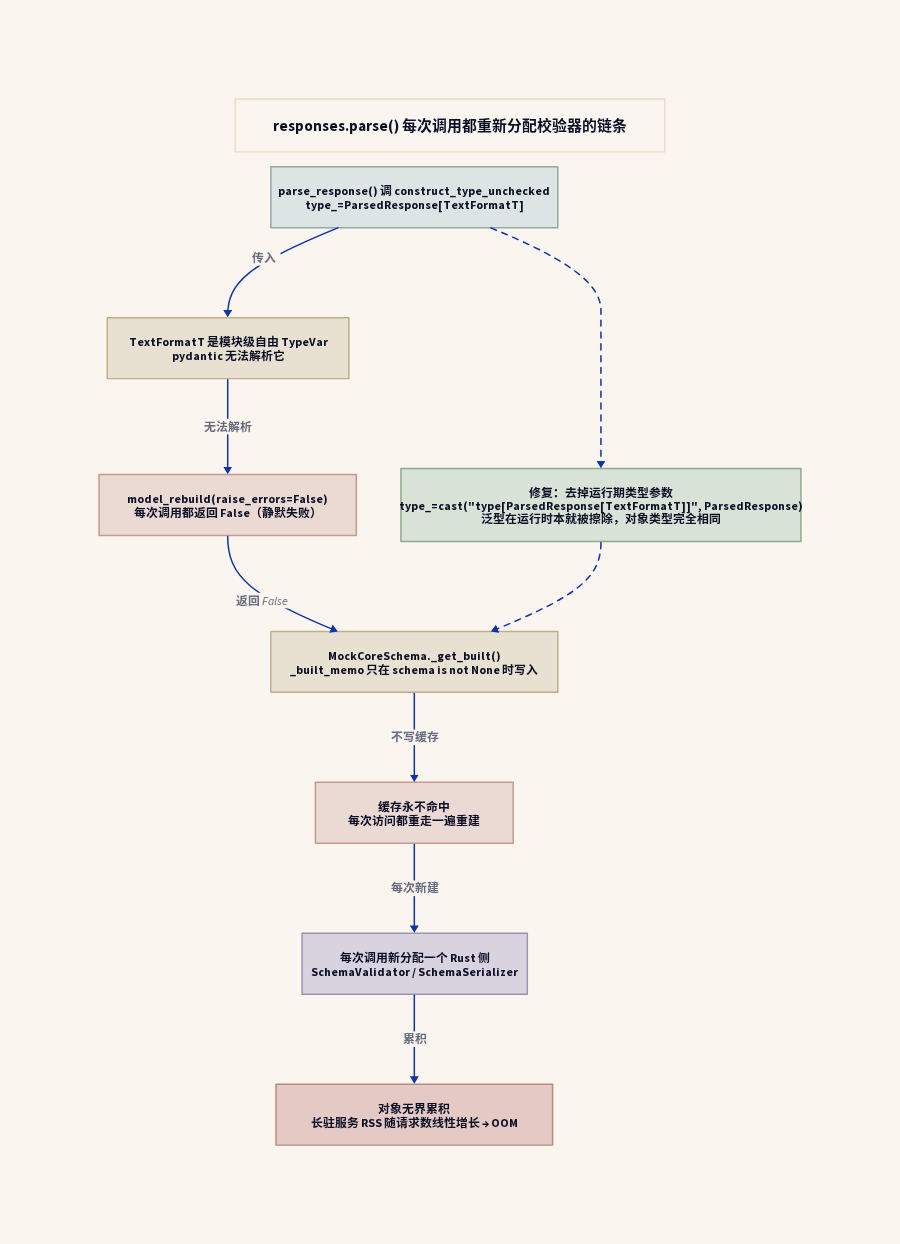
实线是泄漏链条:自由 TypeVar → model_rebuild 静默返回 False → _built_memo 不写入 → 缓存永不命中 → 每次调用新分配校验器 → RSS 线性增长。绿色虚线是修复路径——去掉运行期类型参数,让重建成功、缓存生效。依据 openai-python issue #3084、PR #3088、commit 009b7f6 与 pydantic _mock_val_ser.py 整理。
issue 里还有一段更细的补充(用户 ifplusor,5 月 21–22 日)解释了为什么泛型参数会被卷进来:ParsedResponseOutputText、ParsedResponseOutputMessage、ParsedResponse 的类型变量都是 ContentType,pydantic 把它们的 type_args 视为相同,然后在 collect_model_fields -> FieldInfo.apply_typevars_map 的调用链里被替换成了 TextFormatT。也就是说,这不是「随便写个泛型就泄漏」,而是运行期类型特化这个动作本身触发了 pydantic 的重建路径。
修复是删掉类型参数,而不是加一层缓存
修复本身小得有点意外。commit 009b7f6 一共动了 4 个文件、+49/−7,核心就三处:
|
|
为什么删掉类型参数是对的?因为泛型在运行时本来就被擦除。ParsedResponse[TextFormatT] 和 ParsedResponse 构造出来的对象类型完全相同——ParsedResponse 那些参数化字段本来就藏在 if TYPE_CHECKING: 后面,运行期根本不执行。两者唯一的差别就在 pydantic 的重建路径上。用引号包起来的 cast 则保住了静态类型标注,IDE 和 mypy 看到的还是带参数的版本。
代码注释把这件事写得很直白:
Keep generic annotations in quoted casts: runtime specialization can create new model classes in each async context and retain them in the type adapter cache.
修复范围比 PR 描述里说的「3 sites in one file」要广。实际 diff 覆盖了三类调用点:解析路径(_parsing/_responses.py)、流式路径(streaming/responses/_responses.py 里的 ResponseTextDoneEvent)、以及 resources/responses/responses.py 里两处 cast_to。所以别把它理解成「只有 async 有问题」——同步和流式路径都被这次修复覆盖了。
维护者 marcuswood-oai 在合并时留言说:「I merged main and added a few tweaks for typing, streaming, and regression coverage.」补的回归测试叫 test_parsing_reuses_types_across_contexts,对 sync/async × parse/stream 四种组合做断言。测试里有两行注释,我认为是全文最值得抄走的东西:
|
|
它必须用独立的 contextvars.Context(),因为继承的上下文会共享 pydantic 的泛型缓存,把泄漏藏起来。 这正是前面那个「本地压不出来」的机制解释——你的测试和你的服务如果跑在同一个上下文里,测试就永远看不到这个 bug。
什么时候这条经验不适用
先说清楚这次修复的边界,免得读者过度泛化。
修复只覆盖 SDK 自己的调用点。 你自己封装里如果有同类写法,升级 SDK 不会替你修。真正适用这条经验的是任何「把 type[Generic[T]] 当参数传进运行期构造/校验路径」的自研封装——包括你自己写的 SDK wrapper、给 pydantic 模型做运行期特化的工具函数。
回归测试验证的是类型对象复用,不是 RSS 曲线。 它断言的是 _CachedTypeAdapter.cache_info().currsize 不增长、len(response_types) == 1,这是 SDK 自己的单测,不是端到端内存基准。两者相关但不等价,别把单测通过说成「内存问题已实测解决」。测试里对 pydantic v1 还做了降级处理(Pydantic v1 has no TypeAdapter cache, but still exercises type reuse below),说明这条路径在不同 pydantic 版本上表现不同。
issue 里的「线性增长 / OOM」是报告者的生产观察,没有官方基准数据。 一位生产用户(snipd-kevin)提到「roughly 0.8 MB per call」,但那是他们自己环境的数字,不要当成可引用的通用常量。另一位(kdincx)报的是「每 15–50 分钟撞一次自设回收阈值」,同样是他们自己的部署参数。
还有一个成本容易被忽略:一个 4 月 14 日就报上来的问题,要到 9 月 18 日的 3.16.2 才修。 PR #3088 由社区贡献者 MukundaKatta 在 4 月 15 日提交,中间还有另一位贡献者 Jah-yee 提交了 #3118(未合并)。维护者 marcuswood-oai 在合并当天的回复是「Sorry for the delay, and thanks for flagging this and sharing the reproduction!」。这不是要指责谁——开源项目的排期本来就受资源约束。结论是工程上的:「等上游修」不能作为长驻服务的可靠性策略。
那么今天能做什么?三件事,都不需要你改业务代码。
先量斜率,别等 OOM。 在你的长驻服务上按固定间隔采样稳态 RSS,算它和请求数的关系。如果斜率稳定为正,就是泄漏,不用怀疑。
再用 SDK 自己的办法验证类型复用。 这是可以直接抄的:
|
|
最后,把升级 SDK 当成需要验证的动作,而不是例行公事。 固定版本 + 升级时跑一次上面的断言。如果你现在被这个问题卡着又暂时不能升级,issue 里有生产用户(snipd-kevin,2026-08-31)给出了可用的临时方案:改用 client.responses.create(...),把 schema 作为普通的 {"type": "json_schema", "strict": true, ...} 字典传进去、自己校验返回值——他们验证过,这是自己泄漏与非泄漏部署之间唯一的差别,在 SDK 2.14.0 和 3.3.1 上都成立。
最后一条自查清单,四个问题,值得对着自己的代码过一遍:
- 封装 SDK 时,有没有给模型类做运行期类型特化(尤其用
type[Generic[T]]当参数)? - 有没有把
model_rebuild(raise_errors=False)的返回值丢掉?它是静默失败,不看返回值等于不看。 - 有没有跨请求长驻的类型对象或校验器对象?
- 判断「没有泄漏」的依据,是「单测跑通了」,还是「稳态 RSS 斜率是平的」?
这四个问题里,最后一个最要命。前面三个都能靠读代码回答,只有最后一个要求你真的去量——而这次事故之所以能躺五个月,恰恰是因为绝大多数人只做了前三个。
参考与验证(访问日期 2026-09-19)
- openai-python v3.16.2 release:https://github.com/openai/openai-python/releases/tag/v3.16.2
- issue #3084「Async Responses Structured Outputs Memory leak」(2026-04-14 开,2026-09-18 关闭,8 条评论):https://github.com/openai/openai-python/issues/3084
- PR #3088(MukundaKatta 提交于 2026-04-15,marcuswood-oai 合并于 2026-09-18):https://github.com/openai/openai-python/pull/3088
- PR #3118(Jah-yee 提交于 2026-04-24,未合并):https://github.com/openai/openai-python/pull/3118
- 修复 commit 009b7f6(4 个文件,+49/−7):https://github.com/openai/openai-python/commit/009b7f6ae6493e1abfa7583449595f144c8beb5a
- pydantic
_internal/_mock_val_ser.py(MockCoreSchema._get_built实现):https://github.com/pydantic/pydantic/blob/main/pydantic/_internal/_mock_val_ser.py - 仓库数据:31,645 star / 5,700 fork(GitHub API,2026-09-19 读取)
说明:本文为公开资料分析,未在本地复现该内存泄漏,也未运行 benchmark。文中「每次调用新分配 SchemaValidator」是对 issue 正文、PR 根因段落与 commit 代码注释的复述;泄漏量级与具体触发条件以 issue 为准,不外推为「所有 parse 调用都泄漏」。「躺了五个月」指社区贡献者 PR 的时间线(2026-04-15 提交 → 2026-09-18 合并),不是官方排期。