你上周刚给一块业务开了独立实例。原因很正当:某个客户的批量导出把整张表拖垮,线上主流程跟着抖了十分钟。切开之后炸半径是小了,那周的复盘也好看。
然后上个月,这块业务不做声地发了个新版,流量翻倍。凌晨两点被告警叫起来,你的第一反应是打开控制台加规格,一边加一边想,这套东西当初我是为了省事才切开的。
OpenAI 扛着每秒两千万次查询绕的也是这个圈。他们先给关键用例开独占容器,最后又并回一张共享表。
这篇不是夸他们基建多强。是把他们那趟往返拆开算一遍,看隔离这件事的成本到底在哪一天结算。
先说一句必要的:下面所有数字都是 OpenAI 自己的口径,我这台机器上没有 Cosmos 账户,一个数都复现不了。 原文放出来两天,HN 上的提交只有两分、零评论,英文圈也还没人去核。
隔离的成本不在故障那天,在它下一次发版那天
先看他们为什么要切。
最早那会儿,Habitat 在每个 Cosmos 账户里只用一张默认容器,所有产品共用。
早期设计把逻辑分区键的选择直接暴露给客户端,结果不同产品都在用 user_id、workspace_id 这类键。这些键的限额被几个业务一起分,一个用户能拿到的总吞吐,就被自己身上挂的业务数量限制了。
更麻烦的一点是:文档里写着每个逻辑分区键 10K RU/s,可限额真正执行的位置在物理分区。RU 是 Cosmos 的计费单位,读一次、写一行按不同倍率折算,所以这 10K 更接近一块固定的预算,而非速度上限。逻辑分区拿不满这 10K,它得跟同一块物理分区上的其他键一起排队。于是一个冷门功能的负载,能把同一条物理分区上的登录、注册拖下去。
出事之后的动作跟大多数团队一样:给最关键的用例单独开容器。原文的说法是,这一手确实挡住了很多全站级故障,把影响面压到了单个功能降级。
听着像正确答案,对吧。他们自己写的账是这么结的:
在旧的共享默认容器里,一个新用例从 0 QPS 涨到 100 万 QPS,对整个总量来说几乎看不出变化。换到独享容器,同样从 0 到 100 万,是只有内部 dogfood 时基线的 1000 倍。这个倍数说的是一个用例自身的涨幅,不是总量。
数字更直观。同一份负载,压测时 1K RU/s,上线时 1M RU/s。
扔进一个 100M RU/s 的共享池,压测占 0.005% 的余量,上线占 5%。放进一块全新的 10K RU/s 独享容器,压测就吃掉 10%,上线那一刻是 10000%。
对,10000% 超载。这四个百分比是 OpenAI 为了讲比例摆出来的示意,不是压测报告,看比例关系就好。
于是产品团队得记住一件事:上线之前先扩容器。原文写得很不客气,团队常常发完版就忘了预扩,然后两边一起在 SEV 房间里临时拉容量。
这就是隔离真正的账单。它把一次性的架构决策,换成了每个团队每一次发版的纪律要求,而纪律是会缺勤的。
容量规划这件事还有个更深的问题。共享池里,一百个业务的波动自己会互相抵消,扩容的判断只要盯总量。独享之后,判断某个容器该预配多少,需要知道这块业务什么时候上线、什么时候做活动、什么时候会突然涨。这个知识只在业务团队手里。
他们试过用控制面脚本按增长趋势自动扩。可没有稳定的聚合增长,脚本的输入本身就是猜的。最后的结果是,OpenAI 每个产品团队都被拉进了容量规划。
文档写着 10K,物理分区只分到一半
第二个坑更隐蔽。
Azure Cosmos DB 的预配吞吐是在容器的所有物理分区之间大致均分,这在他们家的文档里写着。而容器的物理分区数不是固定的:数据量超过阈值会分裂,预配吞吐要撑不住也会分裂。
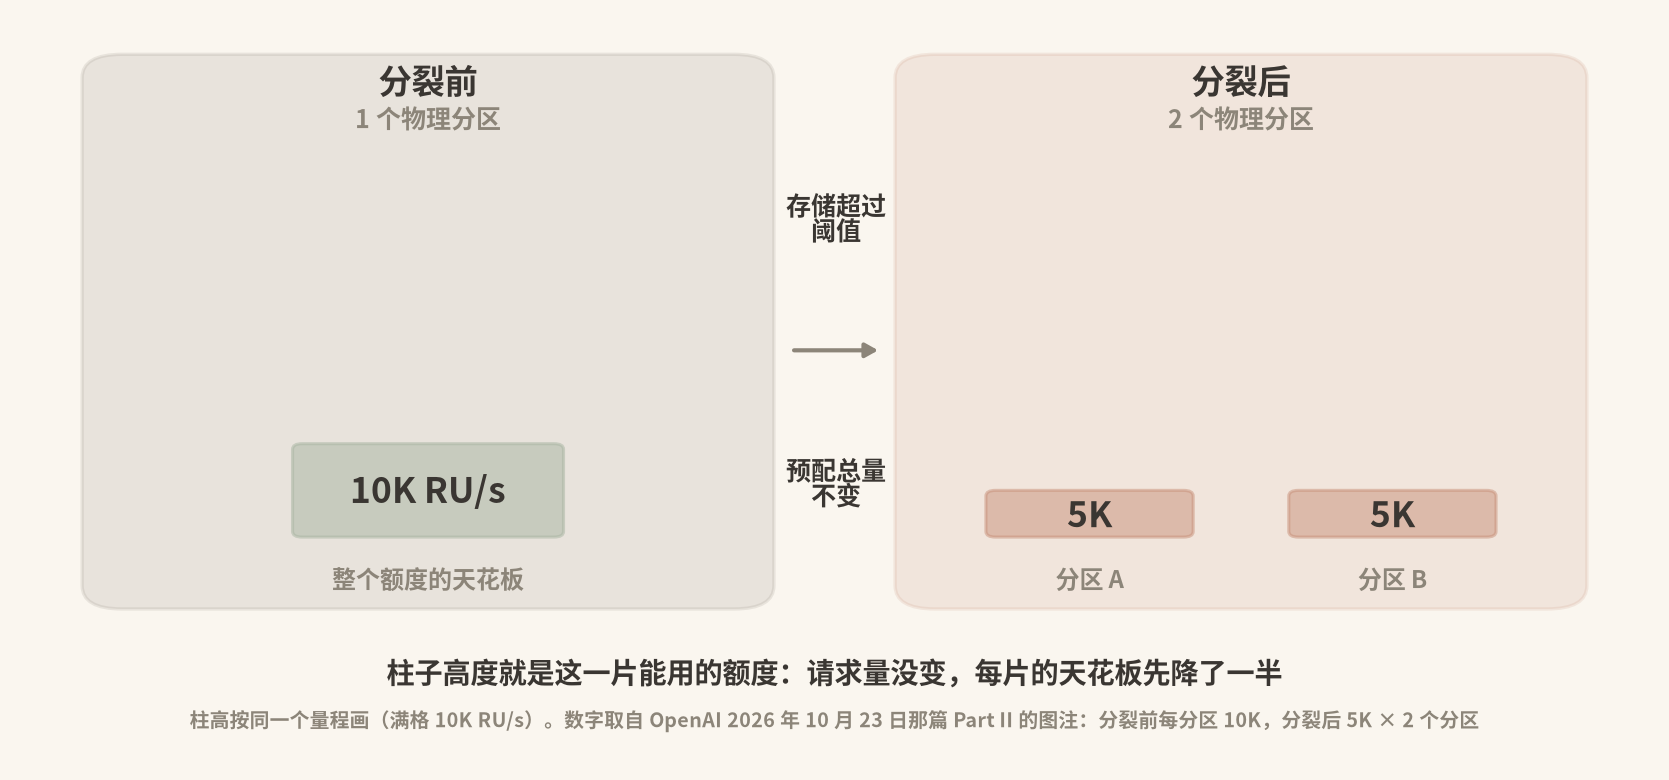
两句话叠起来就有事了。总预配吞吐不变,分区数变多,每个分区能分到的那份就变小。OpenAI 原文那张图注给了一组数,一个分区到存储上限就分成两个,每个孩子拿一半:
前:容量 10K RU/s 后:5K RU/s × 2 个分区
物理分区上限就是 10K RU/s,这是微软文档给的口径。「分割之后每片只剩一半」是 OpenAI 从这条上限和均分规则推出来的结论,微软文档没有把它写成一句官方结论,我照他们的说法写。
他们点名这在大存储、类 blob 的用例上会变成一种故障:请求速率和用量都没变,光数据在长,活跃负载的容量先掉下去了。
这里要停一下,因为这张图里藏着反直觉的地方。
你平时扩容的心智模型是「量涨了,加机器」。这个模型在预配均分的系统里是错的。存储增长会让分片数量增加,而分片数量增加会把同一份预配额度切得更碎。你的 QPS 曲线平得像条直线,容量曲线却在往下走。
任何「预配容量在分片间均分、分片数随数据量增长」的系统,长出来的都是这个形状。预配模式的分布式数据库算一类,按 range 手动切分的 MySQL 也算一类。
判断方法一句话。如果你的容量指标是容器级或集群级的总数,而执行限额的位置在更细的那一层,这个坑就在你脚下。
他们当时的土办法是个脚本,把每个容器预配的总吞吐和它的物理分区数对齐,让每片分到的额度不低于需要。这话翻译过来就是:容量这件事得有人盯着算,而且算的不是总量,是总量除以分区数。
我在自己这边把这件事写成了一个口径更小的检查,落在监控里大概是这个样子:
|
|
结构体里那几个字段,各家 SDK 的名字都不一样,我不编 API 名,你自己对一下能拿到哪个指标。这里真正要紧的不是这段代码,是那个除数:分区数必须进你的告警公式。只比预配总量和消耗量,你会在数据长到某个点之后,突然发现余量没了。
他们能并回去,是因为供应商替他们改了数据库
切出去的容器还能收回来吗。OpenAI 收回来了,靠三样东西:热键限流、请求分级,还有一个得供应商动手改的 serverless。前两样你今晚回去就能抄,第三样抄不了。
先说热键限流,哪个键最烫就先限哪个,避免一个热键把整条物理分区的额度吃干净。再说请求分级,批量插入、数据导出这类离线活降一个优先级,被限在前面,护住面向用户的交互请求。这两样都是你自己那层也能做的。
第三样才是拿回共享容器的手续,也是最难照抄的一件。
Cosmos 本来就有 serverless 模式,按用量付费、自动分裂,正好能治弱分区。可它有两个约束:只按存储量扩,而且每个物理分区封顶 5K RU/s。前一条是好消息,后一条对 RU 密集的用例是死路,等于把弱分区换成了天花板。
Azure 团队给他们做了一个改进版。每个物理分区能扩到 10K,而且除了按存储分裂,还能按 RU 用量分裂。原文说这两条一到位,他们就不用再手工盯容器、手工扩了。
这一件是全文最要紧的成本项,我把它单拎出来说:这是为 OpenAI 定制的,不是你在自己云账号里能勾上的开关。
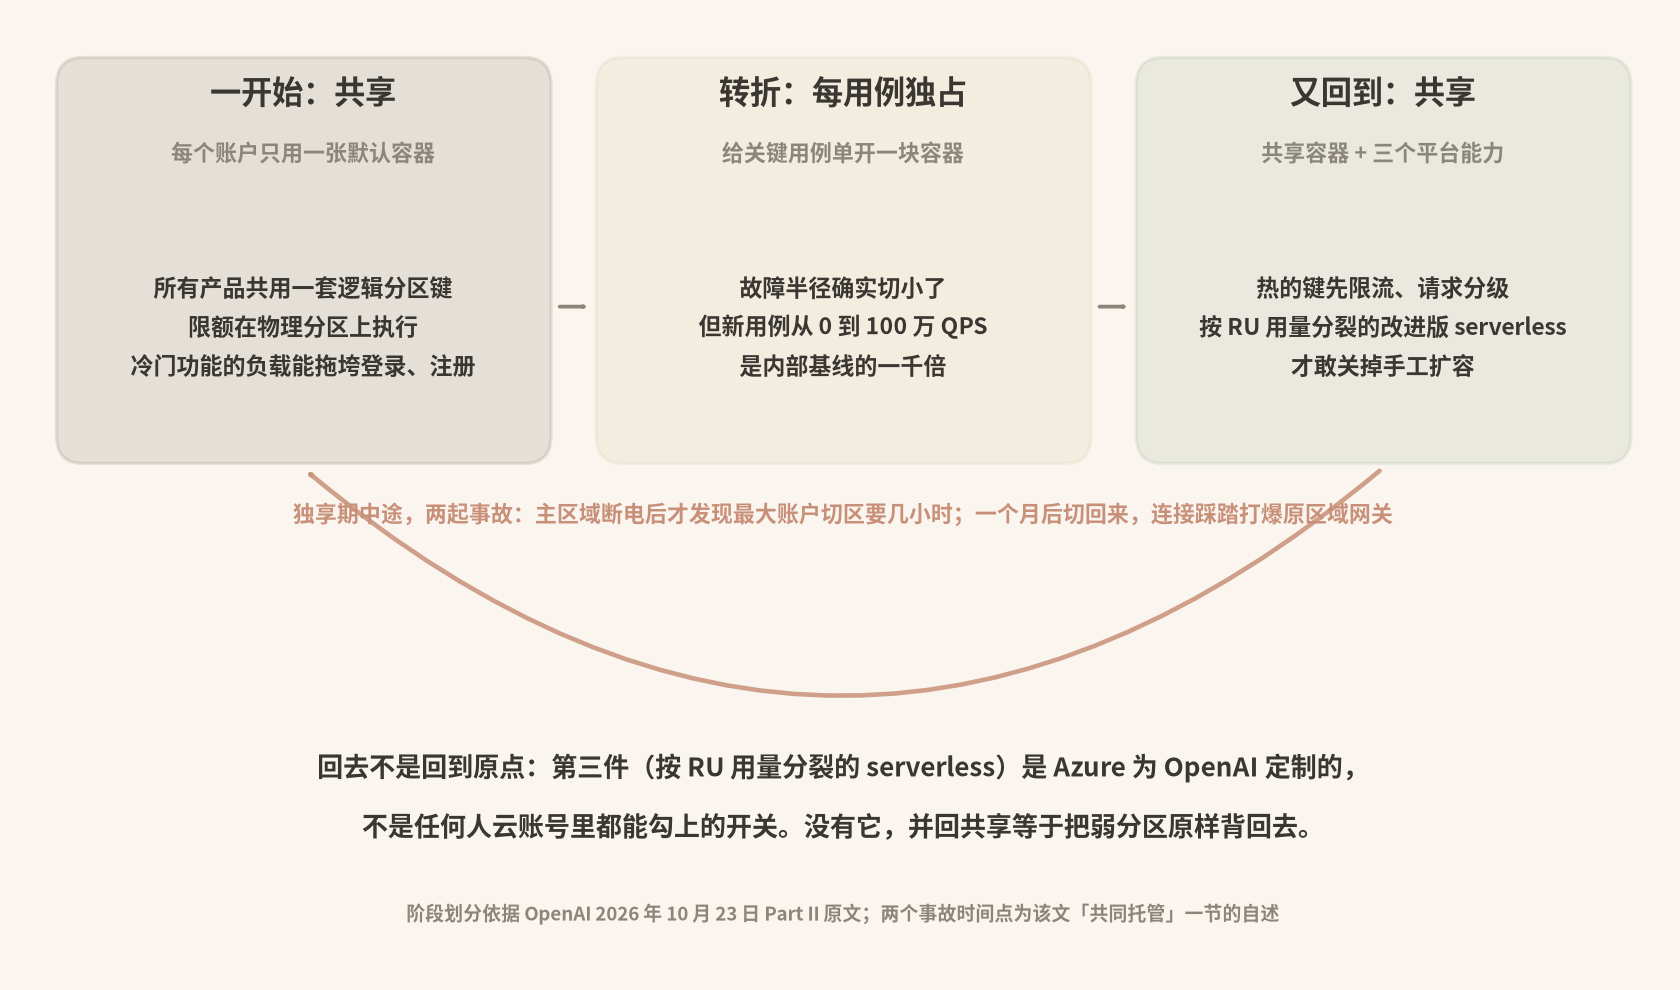
断掉的那一截就在这张图上。三段状态一路走过来,只有回程那道箭头是拼出来的。
差别在这里。你并回共享容器,但分片仍然只按存储分裂、每片仍然封顶 5K,那你就是把弱分区那一节的问题原样背回去了,还搭上了共享池的噪声邻居。共享这件事在你的环境里不一定省钱,可能是更贵。
并回去之后的收益也有前提。原文说共享容器让他们省掉了前期和持续的容量规划,隔离还在,之后几个月没有预配问题,也没有噪声邻居事故。原话如此,截至发稿没有第三方数据,也没有公开的事故记录能对上。
还有一个前提是数学上的。共享池要靠大数定律摊薄波动,你的总量得够大,新业务的涨幅才真的被稀释。十个客户、其中一个占八成流量的 SaaS,学这一套是自找麻烦,那个大客户本身就该单独放。
他们自己也没停在这。原文最后说,正在自研一套 exabyte 级的在线存储,用 Rockset 的 RocksDB Cloud 内核加 Raft 复制,文档模型跟 Cosmos 一样。
代价是峰值 QPS 更低,换来存算分离加物理复制。换存储引擎这件事,他们显然不打算停。
去年那两起事故就写在前面一段。主区域断电之后,才发现最大的账户切到备用区要几个小时。一个月后切回来,一批客户端同时连回原区域,把 gateway 打爆了。
一年前他们做的事是开容器。现在他们在换存储引擎。中间没有一步算终态。
判据不是它吵不吵,是它涨得可不可预测、你扩得动扩不动
绕到这里,那三个平台能力可以压成几个问题。有个顺序,从最不重要的开始。
先看它吵不吵。这块业务的增长是可预期的发布曲线,还是会突然冒出来一个热实体。前者适合独享,你能提前算,也能提前扩。后者是噪声邻居问题,该在共享层做热键限流,隔离反而会把不可预测的那部分成本变成你自己的待办。
再看这块负载是交互型还是离线型。离线型的正确处置是降优先级,不是搬走。搬得再远,它也会在别处跟别人抢。
真正决定成败的是中间这条:你能不能把扩容量写进发布流水线。 能,独享的运营成本就低一档,容器规格跟着服务清单一起走,发版即扩容。不能,独享就等于给每个团队发了一张「别忘了」的欠条。第一条还能靠补监控兜,这条只能改流程。
最后一条是硬约束,没得商量。合规或者数据驻留要求你物理隔离,那就别算成本了。
四条问题里,第一问会随业务漂移,后三条相对稳定。所以半年后业务变了,值得重算一遍的是第一问。产品从大促型变成长尾稳定增长,这种事一个季度就能发生。
顺手把一个缓存上的旧题也带走。他们那个集成缓存要解决跨区域的新鲜度,TTL 短了命中率掉,长了数据陈旧。显式失效干净,但部分失败会留下脏数据,多区域下还要跟复制赛跑。
他们最后走的是 CDC:订阅 Cosmos 的 change feed,写到哪儿就把哪儿的缓存置为失效,全局秒级。这条路跟 Meta 的 TAO 一个思路,能同时拿到高命中率和低陈旧度,代价是多一个消费者要运维、多一段延迟要接受。
真要动手,先别急着给新业务开独享。先把你手上每个容器的预配吞吐除以物理分区数,跟它最近的实测消耗比一遍。这一行算式跑出来的名单,比任何架构讨论都更能告诉你下一步该做什么。