
8 月 14 日,阿里放出 Qwen3.8-27B,开发者蹲这个版本蹲了好久。
原因就一句话:现在,一张 4090 就能跑"Opus级"Agent 了。
270 亿参数,量化后刚好塞进 24GB 显存,RTX 3090/4090、大内存 Mac 都能跑,还免费商用。
先看数据:多项榜单反超 Claude Opus 4.6 Max
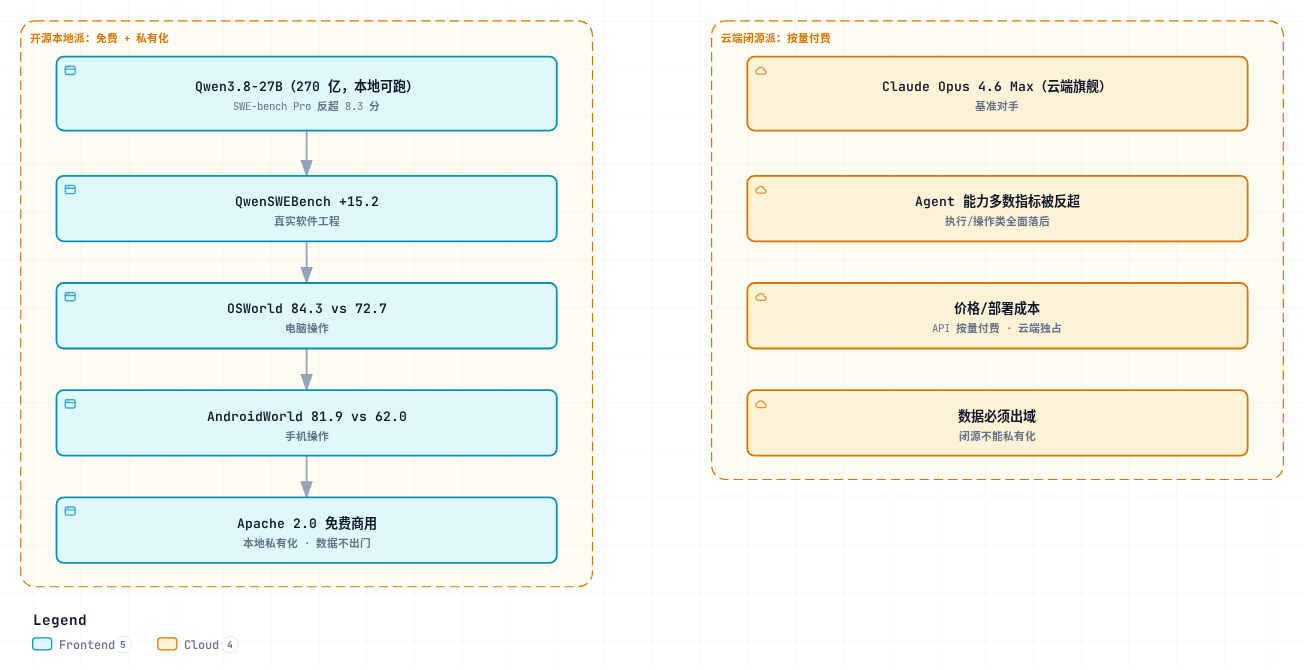
官方 Benchmark 里,27B 在软件工程和 Agent 评测上把云端旗舰 Opus 4.6 Max 干翻了好几项:
- SWE-bench Pro(Agent 编程):高出 8.3 分
- QwenSWEBench(真实软件工程):领先扩大到 15.2 分
- CoWorkBench(计算机/金融/法律/医疗专业长任务):70.7 vs 68.2
- OSWorld-Verified(电脑操作):84.3 vs 72.7
- AndroidWorld(手机操作):81.9 vs 62.0
- WebArena-Verified(浏览器操作):从上一代 48.8 涨到 64.8
注意 4 和 5——电脑操作和手机操作,这是 Agent 落地最直接的场景,27B 反超幅度最明显。
为什么 27B 能打:架构和配置都没缩水
尺寸小了,配置没缩水:
- 原生多模态:看图、读 PDF、理解图表、处理视频,都行
- 262K 原生上下文:还能扩展到 100 万 token——吃下大工程没问题
- 架构:64 层里 48 层用 Gated DeltaNet 线性注意力 + 16 层完整 Attention,按"3 层线性 + 1 层完整"循环。线性注意力降长序列的计算和显存压力,完整注意力隔几层做充分信息交互——这是 262K 上下文还能本地跑的关键
社区实测也很硬:有人把 FP8 版放到单张 GH200 上,10 个并发请求、262K 上下文,首批流式 token 都在 10ms 内返回;还有人让它看一部 1935 年的 11 分钟老电影,识别 96 个带时间戳的事件,157 秒跑完,误差只有 2 秒。
怎么跑起来
官方已经接好了 Transformers、vLLM、SGLang、TokenSpeed:
- 生产环境/高吞吐:用 SGLang 或 vLLM
- 本地玩家:HuggingFace 有量化版本,用熟悉的工具链直接部署
- 手里有 4090 或大内存 Mac,基本可以开始折腾了
模型卡:huggingface.co/Qwen/Qwen3.8-27B
丑话也说在前面
先说清楚限制,别瞎吹:
- “Opus级"是场景限定的:反超集中在 Agent 执行、代码、操作类任务;复杂深度推理、超长上下文,270 亿参数和云端旗舰还是有差距,别拿"270 亿反超 Opus"标题党
- 这是官方厂商 benchmark:你拿自己的真实任务跑一遍,比什么都靠谱
- 开源协议放心:Apache 2.0,你可以商用,也可以改了再发,免费,这点阿里一直做的到位
说白了:对于做私有化、做数据敏感业务的人,这是天上掉馅饼;对于普通用户尝鲜,它也确实能让你在本地跑个像样的 Agent,不用再蹭云端 API。
对程序员的直接意义
以前"本地跑 Opus 级 Agent"是想都不敢想的:旗舰模型都在云端,要么按量付费,要么数据出不了门。
Qwen3.8-27B 把门槛砸下来了:Agent 能力 + 多模态 + 262K 上下文,量化后 24GB 显存,免费商用,数据不出门。
对做私有化、做 toB、做数据敏感场景的人来说,这可能是 2026 年最值得关注的本地模型。
你准备用 27B 跑什么?评论区聊聊 👇