你写完一段 JavaScript 判断,跑得挺好。有人跟你说,把它换成神经网络,结果逐位一样,还能求导。
你点开仓库,标题写着 Turn your regular JavaScript code into a neural net。
往下滚两屏,文档第一句是:No tool converts existing JavaScript source into a program。
没有工具能把现有 JS 源码转成程序。它不做翻译,你得自己用它的原语,把那段判断手写一遍。
真动手之后最疼的那件事在这儿:同一个 if,为什么有时候只花 2 个操作,有时候要花 15 个,而且它不报错,只是变慢。
同一个比较,成本差 7 倍,而结果一位不差
先把最容易误解的地方钉住。它不编译你的代码,它给你四个原语:affine 做加权和,reglu 做 left×max(0,gate),boolean 把分数舍成 0/1,indexRead 读表。
你用普通 JS 调这些原语,跑一次,生成一个 Circuit。执行的时候,就是读一个 Float32Array,算加乘和 ReLU。
一个 (a > 4) ? 10 : 12 进去,出来是 max(0,a-4) - max(0,a-5),两个分支都算,再拿一个 bit 选。
选中那条分支本身也要钱。条件在 0..1 之间时,emitSelect 每个数 4 个操作、3 层。
真正的账在那个 bit 上。同一个 a >= b,emitCompare 会按你给的声明自动挑实现,挑到哪条,代价差一大截。
表里最便宜的一行是整数 bit:两个操作数都声明在同一个 grid 上,每个部分和不超过 2^24 个 grid 步长,>= 就是 2 个操作、2 层。=== 3 个操作。
没有 grid,退到符号级联。它把差值拆符号位,逐级乘 2 的幂再 clamp,直到任何非零差值(低到 2^-149)都被抬到至少 1。0 到 16,384 这个范围里,>= 是 15 个操作、14 层,=== 28 个。
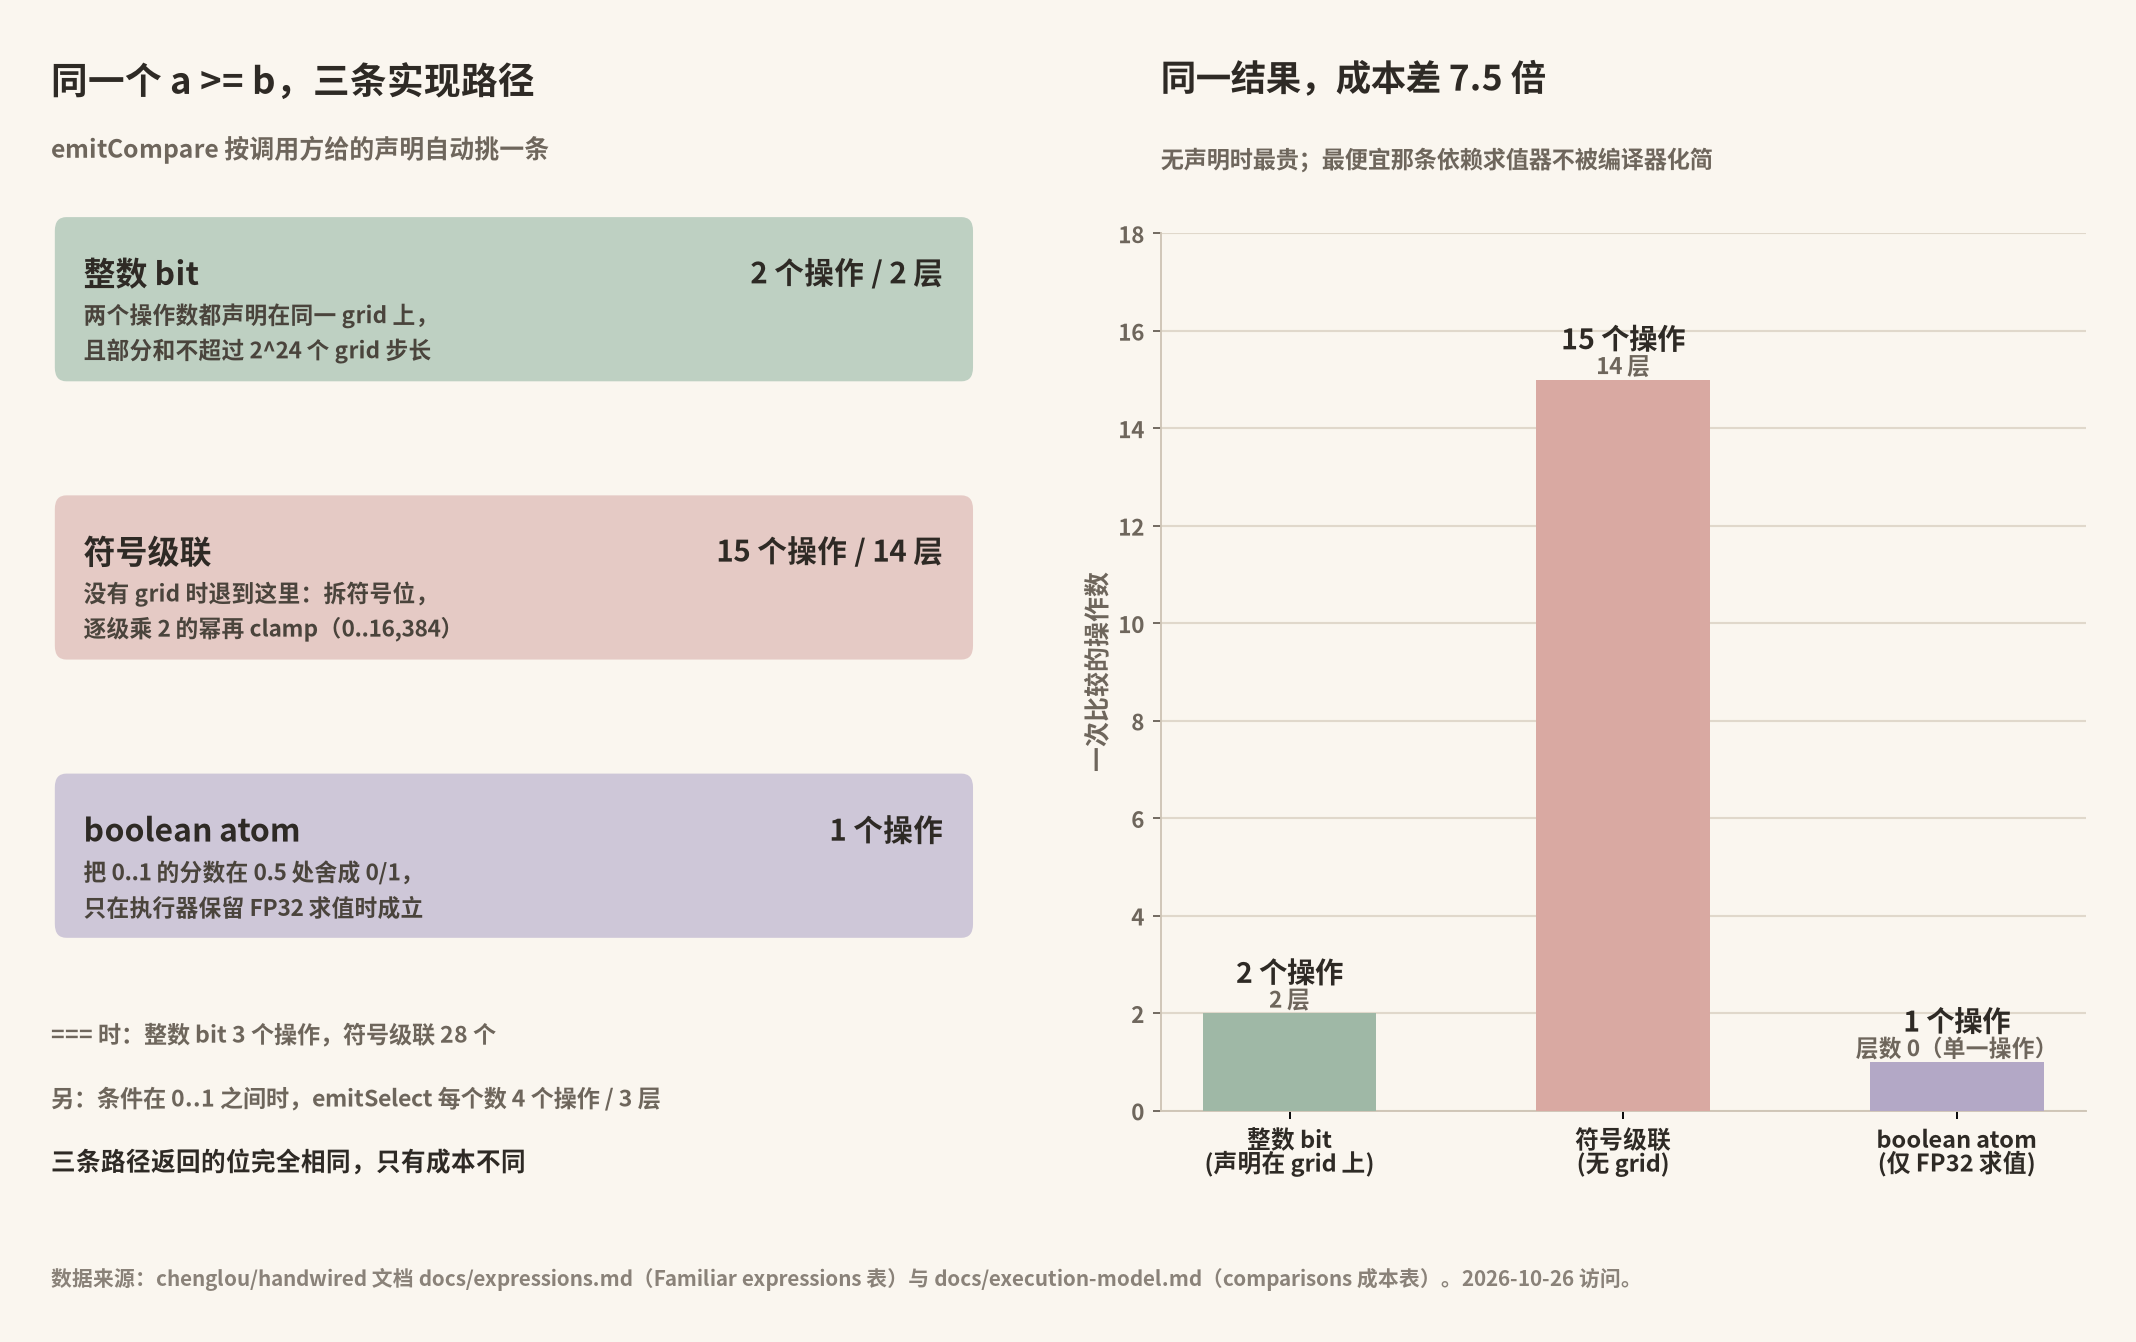
还有一条更便宜的:boolean atom。(x + 8,388,609) - 8,388,609,一个操作就把 0..1 的分数在 0.5 处舍成 0/1。
但它只在执行器保留 FP32 存储求值时成立。哪天编译器把这个加常数再减常数化简回 x,bit 就错了。
两条路返回的位完全一样。所以这类问题不看结果,看清单——同一个 if 花 2 个操作还是 15 个,取决于你在 assumeGrid 里声明了什么。
建完之后调 circuit.roundingPoints(),按 kind 数一遍 'integer bit' 和 'sign cascade' 各有几条,才知道自己站在哪一边。
作者自己在 HandwiredOS 的窗口命中测试里踩过这个。每个窗口四条边,声明都在 grid 上时每条边 2 个操作。
坐标范围一放大到 ±65,536 px,标题栏右边缘的距离就超过 2^24 个 grid 步长。那一条自动变成符号级联,每个窗口多 13 个操作。geometry 完全不给 grid 时,每条边多 13 到 14 个。
而 dock 项的宽度是除以 3 得来的,落在任何 grid 之外,只能改用 boolean atom。
到这里就能看出这套东西卖的到底是什么了。它卖的是结果和你那份 JS 引用实现逐位相同,不是省下来的开发时间。为了这个,它把每一处浮点判定都摊开来给你数。
声明是你签的字,它不会替你验
那次命中测试里最值得抄走的不是数字,是那句边界:assumeGrid、assumeRange 是调用方的承诺,不是证明。
builder 信你。你写了个假 grid,整数 bit 就变回小数,而且程序一句警告都不给。
它连梯度都按你说的话走。整数 bit 只在差值落在 -1 到 1 之间时给梯度,也就是 -1/grid 这么大。文档的原话是,这种情况只在你那条 grid 声明是假的时候才会发生。
所以这条链上有三道各自的闸,缺一道都不行。
- 声明阶段:
assumeGrid/assumeRange写下去。 - 构建阶段:
validateGrids、validateIndexReads走一遍。 - 修完之后:
roundingPoints()数 kind。
第二道闸尤其别跳。README 里有个特别好用的反例。
一段从 circuit.constant(0) 开始累加的写法,因为常量 0 不强加 grid,把它拿去比较就会吃到 15 个操作的符号级联。把累加改从第一项起,同样的比较变回 2 个操作的整数 bit。
代码看着几乎一样,成本差七倍。从常量 0 起头这个习惯,很多人生来就有。
这套设计里最值钱的不是那四个原语,是这三步连在一起:声明,量代价,再用验证函数兜住声明。缺了最后一步,前面写的东西就是一份没人签字的合同。
把循环改成树以后,CPU 上反而更慢
现在说那个最反直觉的地方。
神经网络没法提前退出。一个 findIndex 在普通 JS 里找到第一个命中就 break,在这里必须一次算完全部候选。
教科书给的解法是把循环改成树,log n 层,看起来漂亮。作者把这套改写试了一遍。结论是看情况,而且常常跟直觉相反。
他给的例子是文本流里的行底判定,条件沿项目单调翻转。计数法 3n+3 个操作、3 层。64 行时是 195 个操作。用 emitFirstActive 建树,447 个操作、34 层。
单调的时候,计数版更快。
换成任意分布,比如重叠窗口的命中,结论倒过来:树 316 个操作、31 层,链 127 个操作、127 层。作者在 patterns.md 的开头把这条讲得比数字更直接:CPU 上树经常比循环慢,所以下面好几个配方都写着「保留这个循环」。
为什么?因为 CPU 执行器计费跟操作数走,不跟层数走。
层本身也有钱,大约每 1,000 层 10 µs,花在拷贝每层读的值和写的结果上。
同样 16,384 个二项和,64 层 55 µs,1,024 层 65 µs,16,384 层 210 µs。这是 Bun 1.4.3 在 M5 Max 上的数,跑的是 bun lab/runtime-cost/layers.ts。
「减了操作、加了层」这个交换,只有在执行器按层计价的地方才划算。
CPU 上不是。所以 Knuth-Plass 那个最优断行程序,树形比链形慢 1.7 到 7.7 倍。作者自己在结论里也是这句:CPU 上树经常比循环慢,所以好几个配方都写着「保留这个循环」。你换掉的是操作数,加的是层费,而执行器只按操作数收钱。
顺带一个藏得更深的坑。emitArgmax 在近乎平局时有个 8.9e-8 的宽度带,树可能选中的候选和循环不同。需要精确的时候换 emitHighestScoreExact。
作者自己退回过:文本布局搬出程序,省了 4.5 倍
一个项目最该看的地方,是作者自己往回走了哪几步。
Notes 一开始把文本布局整个放进程序里算。
那版是 20,381 个活操作,一次求值 133 µs。
后来他换成浏览器原生的 <textarea>,程序掉到 4,251 个活操作,一次求值 25.1 到 25.3 µs,快了大约 4.5 倍。页面加载那个长任务从 114 到 117 ms 降到 57 ms。
还有一次 GPU 整体化的尝试。HandwiredOS 搬到 WebGPU,一次求值 2.2 ms,CPU 上是 81 µs,慢了 27 倍。因为在一张表里,shader 的语句是一条接一条顺序跑的。
那个 6.4 MB 的 shader 在 Metal 里 28 分钟没编译完。
容量也是写死的。Photos 为了省大约 300 个操作,用 2 个 spring 代替 12 个。代价是半秒内「关→开另一张→再关」时,第一张会跳回格子。
Text rows 硬上限定在 16,384 行。超限时的行为要你自己显式给:snap、carry、报告、丢弃,四选一。不给兜底,超限就是算错,而且没有输出提示。
我这些数字一个都没有复现。这台机器没有 M5 Max,也没有 Bun 1.4.3,全部引自仓库的 lab/status.md。
作者自己也写明,这些微秒值随 load average 变。同一份代码在 19 个标签页和 4 个标签页下会进不同的「快模式」,只能做相对比较。
把这些放一起,判据其实很清楚。
该搬进去的,是离散决策密集、每个数都能声明清楚范围的那类逻辑:命中测试、可见性标志、几个数之间的门槛判断、几百个候选里的选择。**判据只有一条:这个数你能不能对调用方说出它的 grid。**说不出来,搬进去就是给自己埋一条不报错的减速带。
别搬的是另外三类。每个框架都要算出整块布局的活,比如文本排版。单张大表要上 GPU 的活,因为它的语句会一条接一条顺序跑。输入可能带 Infinity 还能落进未选分支的活,因为 0 × Infinity 是 NaN。
还有一条最容易被忽略的:它的精确是「对 FP32 操作数精确」,不是对 float64 的 JS 精确。
宽度除以 244,再乘 1,732 减 24,FP32 的倒数先舍入了一步,得到 6.9999995。比 7 小一格。于是 columns >= 7 在它这里算出 0,在你那段 float64 的 JS 里算出 1。
这种差不是 bug。是两套数在打架。
先花二十分钟,数一遍你那段逻辑里的符号级联
真要用,第一个动作不是搬业务逻辑,是在仓库里跑一遍成本报告,看你的程序站在哪一边。
|
|
然后挑你代码里最热的那条判断,按这个形状写一遍:
|
|
写完数一眼:
|
|
排查的顺序也顺手记一下。
结果对但是慢了五六倍,先数 sign cascade,八成是某处 assumeGrid 没写或者写错了,尤其别从 circuit.constant(0) 起头累加。
平局附近和 JS 结果对不上,查 emitArgmax 那段 8.9e-8 的宽度带。搬到 GPU 上结果变了,查 boolean atom 是不是被 shader 化简掉了。
至于要不要现在接进生产,我的看法是别急。
这是一个单作者、825 次提交、9 个 open issue、最后推送停在 10 月 17 日的项目。作者把它当研究在做,status.md 里记着大半年的回滚和推翻。它是这个方向目前最好的一份工程记录,但适合读,不适合押。
真正值得现在拿走的也不是代码。
是那三个动作本身:把一个判定写成可以清点的形状,量出它到底花几个操作,再用一个验证函数把这件事从「我觉得我声明对了」变成「我验过」。
这套动作不依赖 Handwired。你手上任何一个把浮点判断摊开写的地方,都能照这个顺序做一遍:先写下你对这个数范围的承诺,再数它实际花了几个操作,最后用测试把承诺焊死。
三步里最容易被跳过的是第三步,而被跳过的也正是唯一能兜住前两步的那一步。
你现在那段逻辑里,有几条热判断是别人给你的 grid 声明在做主,而从来没被数过?