
智谱昨天发了 GLM-5.3,就是唐杰预告的那个"史诗级 plus"。
看完技术报告,最让我意外的是:基座根本没换。 参数还是 7530 亿左右,和 5.2 一模一样,所有提升都来自后训练——训练时间更长、任务环境更丰富、强化学习规模更大。
打个比方:课本没变,但换了一套更狠的刷题方法,成绩就上去了。
背后用的还是 5.2 攒下的那套家底:IndexShare(长上下文)、SAO(长程强化学习)、slime(大规模异步训练)。
现在国产三家各有各的打法:Kimi K3 卷参数(2.8 万亿),DeepSeek 卷价格,智谱闷头卷后训练。
编程到底啥水平,看图
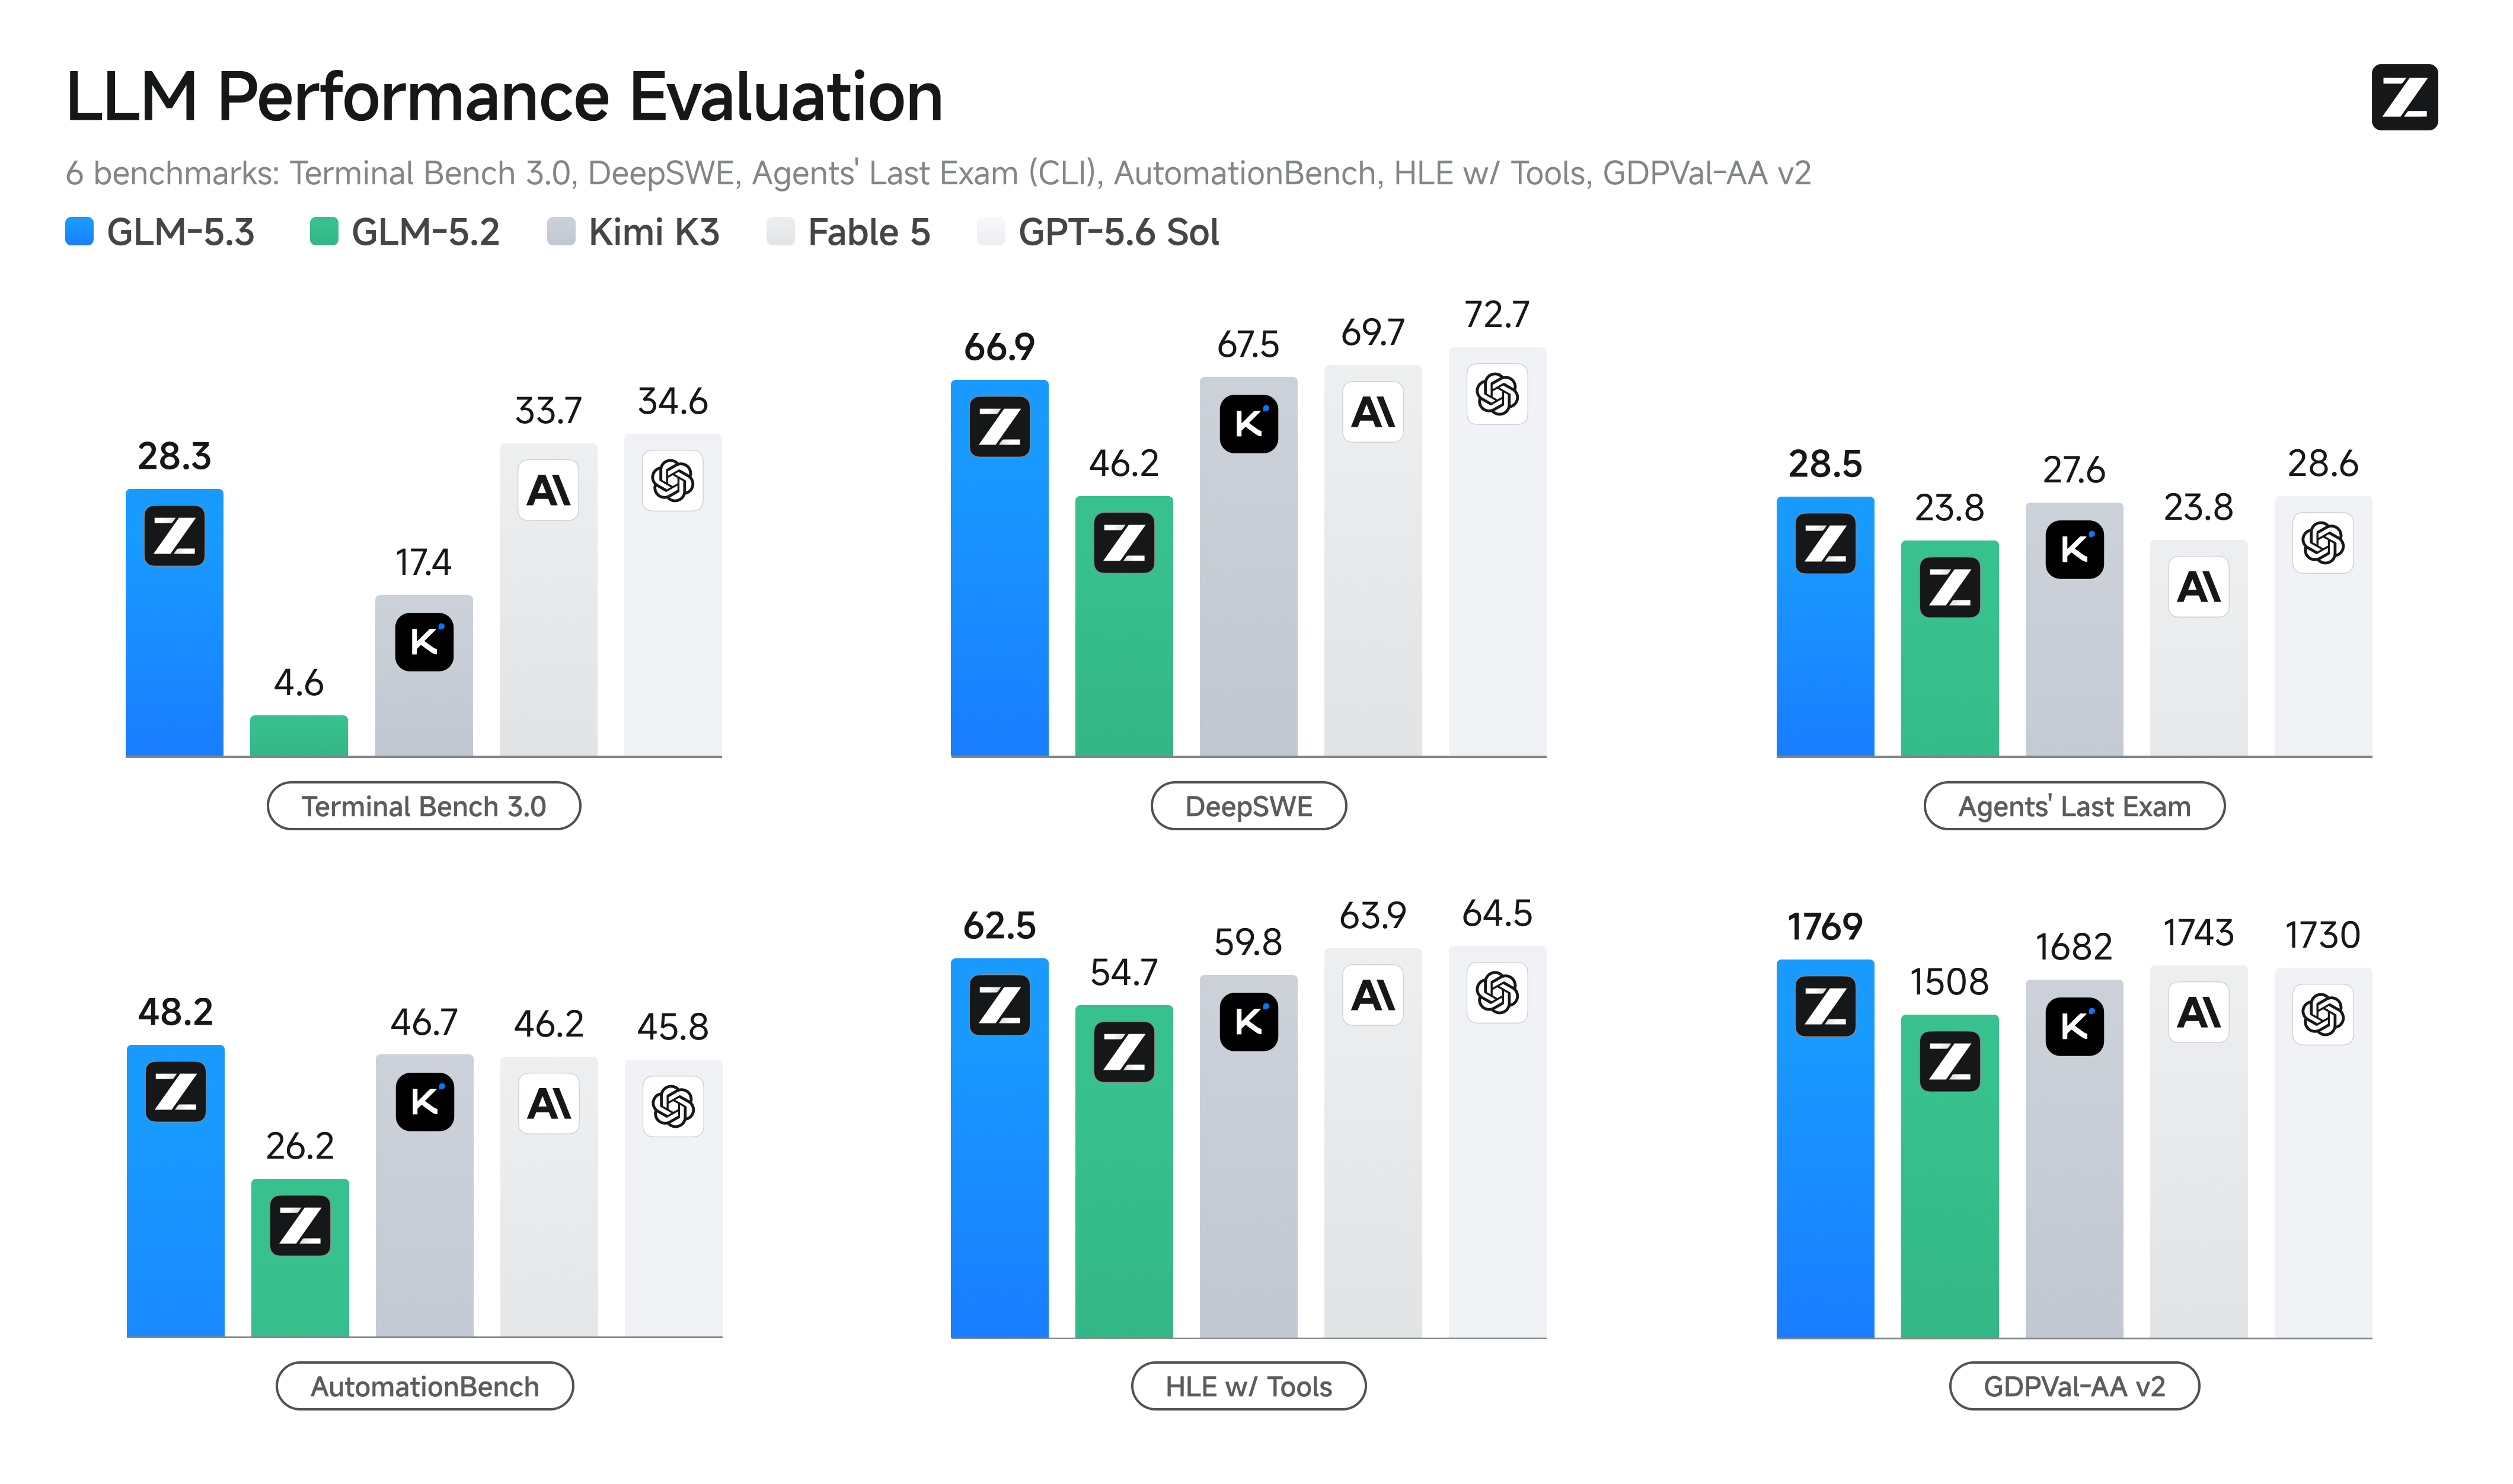
图里信息量大,挑几个重点说:
- Terminal Bench 2.1 拿了 88.2 分,跟 Kimi K3(88.3)基本打平,压过 DeepSeek(87.9)和 Opus 4.8(85.0)
- 智能体大考 Agents’ Last Exam 28.5 分,居然超过了 Fable 5(23.8)
- GDPval-AA v2 拿了 1769 分,Kimi K3、GPT-5.6 Sol、Fable 5 全在它后面
- 自家 Code Bench 的 High 档 31.4%,超过 Opus 4.8 的 29.5%,而且输出 tokens 不到对方一半——活干得更好,还更省钱
短板也得说:Max 档还是打不过 Fable 5(34.5% vs 39.5%),“比肩"是真的,“超越"还差点。
安全这块,是真干活的
漏洞推理 CyberGym 拿了 84.5%,比 Anthropic 的 Mythos 5(83.8%)和 GPT-5.6 Sol(83.6%)都高。
利用验证 ExploitBench 54.4%,是上一代 24.4% 的两倍多。
更实在的是:智谱联合清华、奇安信、腾讯玄武等十多家团队搞红队测试,在 269 个项目里挖出 2436 个漏洞,1097 个中高危,覆盖系统内核、操作系统、浏览器、通信协议,已经提交 CNNVD/CNVD 国家漏洞库。敢让 AI 写代码的前提,是 AI 自己先懂漏洞——这一点智谱是拿真东西说话的。
国产四强,一个月内都亮牌了
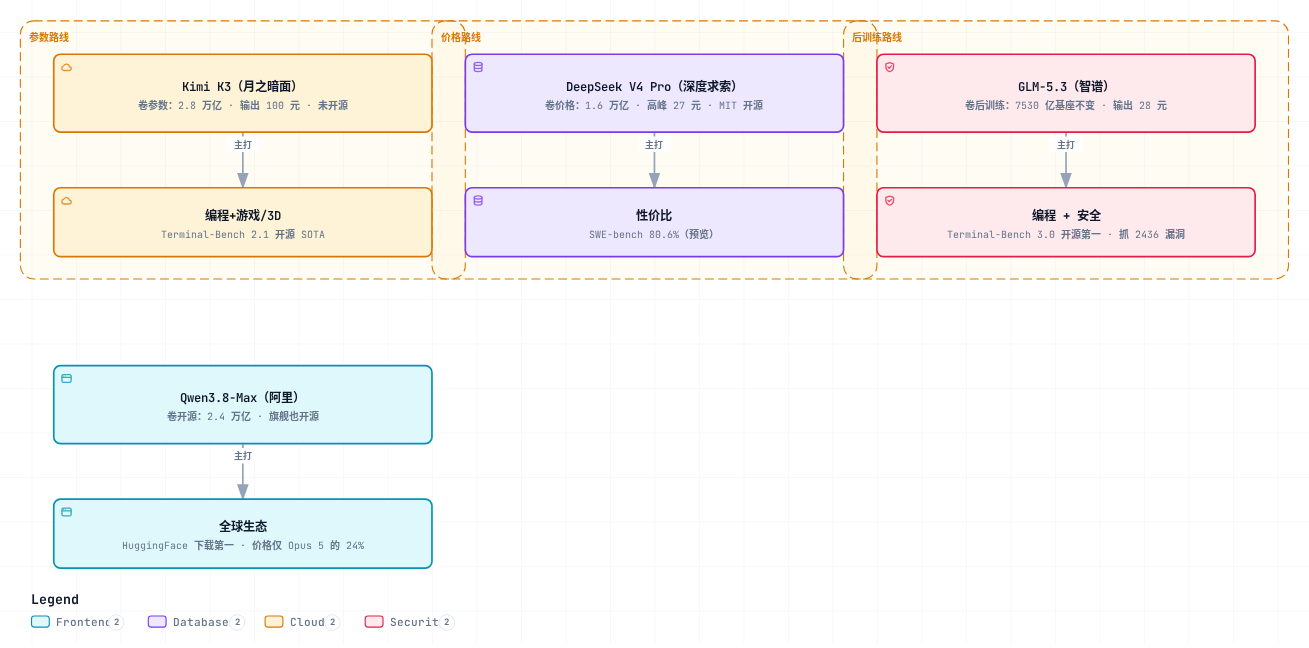
先认识一下第四家:Qwen3.8-Max(阿里,8 月 3 日发布)——2.4 万亿参数,走「卷开源」路线:旗舰级也宣布下周开源,输出价格只有 Opus 5 的 24%。GLM-5.3 官方对比表里它 Terminal Bench 2.1 拿 86.6 分(GLM 88.2、Kimi 88.3、DeepSeek 87.9),GDPval-AA v2 有 1739 分,综合能力排在 Kimi 和 GLM 之后,但开源生态全家第一。
除了性能路线,供应能力也得看——模型怎么交到你手上,差别很大:
- 开源:DeepSeek 全系 MIT 开源,能私有化部署;智谱官方说 5.3 权重两周后开源(等安全评估完);Qwen3.8-Max 也宣布下周开源——阿里这次把旗舰也放了(HuggingFace 下载量常年第一);Kimi K3 没开源,只能走 API
- API:三家都有,兼容 OpenAI SDK,切换成本低。但 DeepSeek 刚搞了出 V4-Pro 发布即撤回的事故——旗舰模型的供应稳不稳,也该算进选型评估里
- 安全合规:GLM 主动把漏洞交国家漏洞库,这个姿态国内少见
定价变局:海外降价,国产涨价
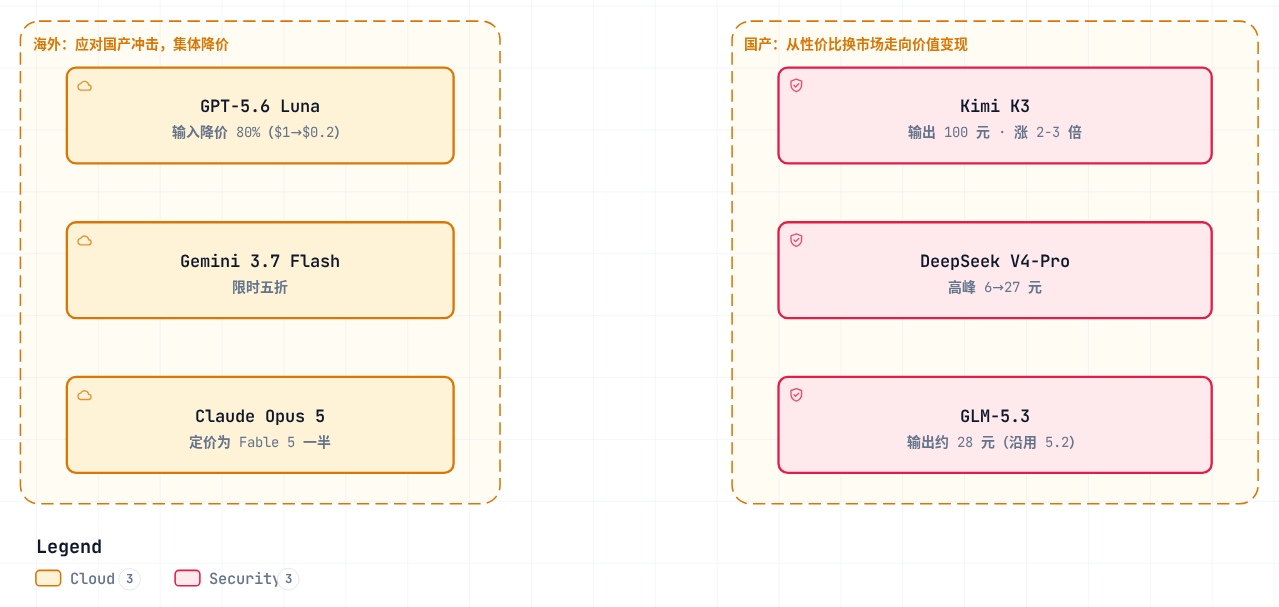
海外被国产卷怕了,集体降价:GPT-5.6 Luna 输入价降 80%,Gemini 3.7 Flash 五折,Opus 5 定价只有 Fable 5 一半。
国产这边反过来:Kimi K3 输出 100 元,DeepSeek 高峰 27 元,GLM-5.3 约 28 元,Qwen3.8-Max 输出价只有 Opus 5 的 24%(折算约 25-30 元档)。除了 Kimi 坚定站旗舰价位,另外三家几乎打平。中国大模型平均 API 输出价从 12.2 元涨到 21.9 元——靠白菜价抢市场的阶段,过去了。
怎么选,给你交个底
- 长上下文、游戏 3D 场景:Kimi K3(缓存命中才 2 元,真香)
- 预算敏感、想要开源权重自己部署:DeepSeek
- 编程加安全合规:重点试试 GLM-5.3
后面还有几个悬念:后训练的红利还能挖多久?开源之后安全管控扛不扛得住?智谱能不能靠编程生态立住护城河?走着瞧。
你上手 GLM-5.3 了吗?