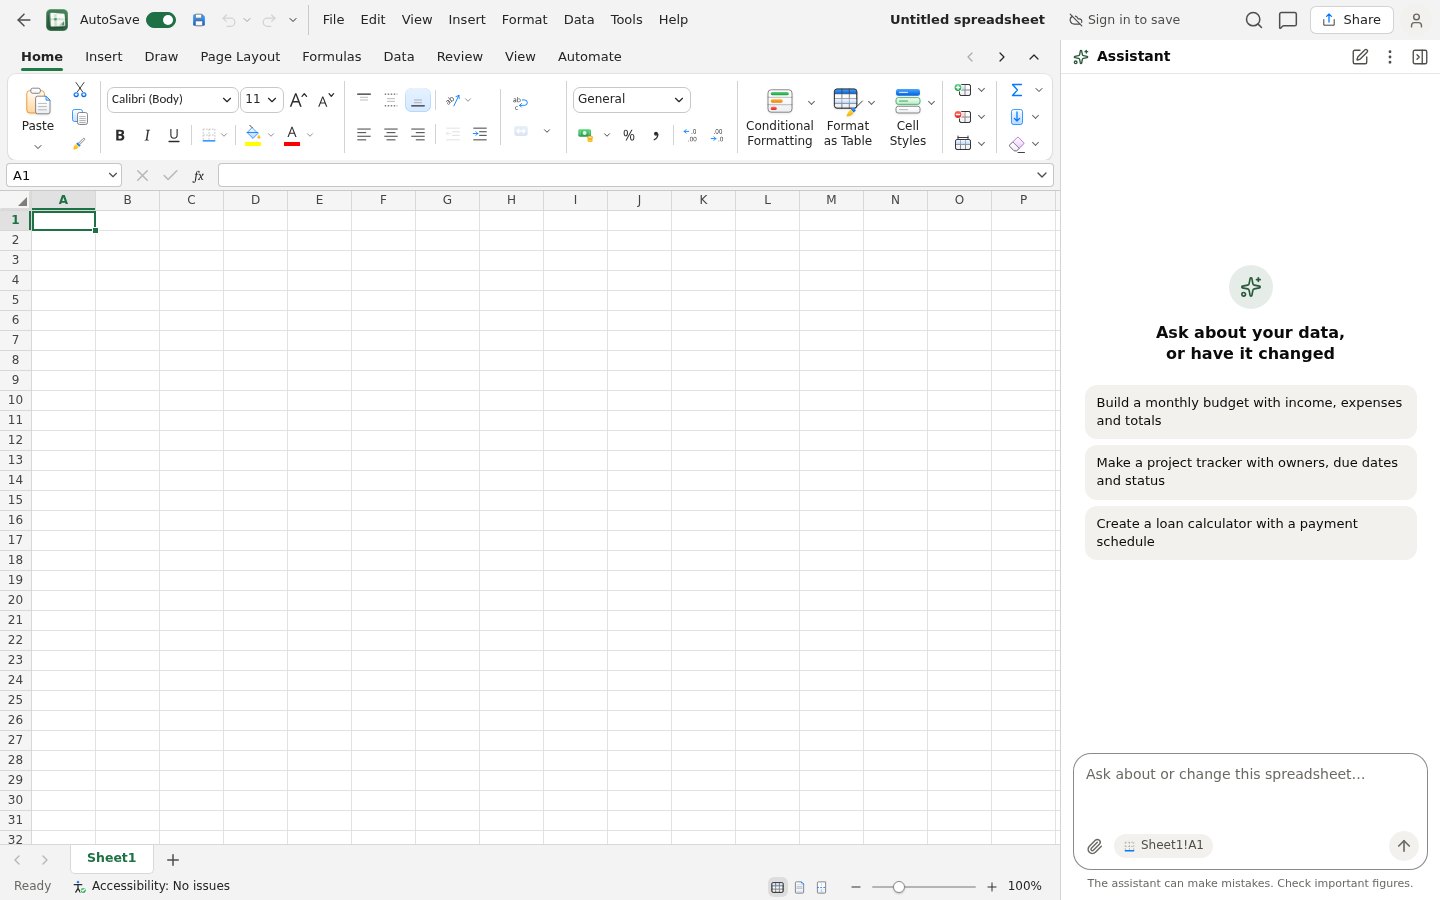
先在浏览器里敲一个地址:spreadsheet.puter.com。页面加载完之后,菜单栏、公式栏、A 到 O 的列标全在那儿,A1 单元格亮着绿框,右下角状态栏写着 Ready。不用注册,就能开始敲数字。
这就是那个仓库里的一个应用,来自 HeyPuter/everything。README 挂着一句话:把全世界的软件重建、开源,MIT 协议。底下九张表,从 Office 到 AutoCAD,每个应用写明替代谁,旁边挂个 Try it。
这个仓库 10 月 13 日创建,到今天 13 天,227 次提交,3884 颗星。媒体讲它的口径是“一个人用 AI 重写了全世界软件”。
我不太信这种话。所以我换了个验证办法:把 README 里每一行的 Try it 都点了一遍。
README 本来就是一份验收清单,我只换了一个判据
判断一个“替代品”做没做,最省事的说法是看它宣传了几项功能。宣传词没法验。能验的只有一件事:打开之后,屏幕上有没有能动手的地方。
我的操作很简单。用 Chromium 按 1440×900 打开每个链接,等页面加载完再等 3 秒,然后看页面上有没有出现菜单栏(File、Edit、View)、网格或者画布。有,算能用;没有,只算有个页面。
判据特意选成“有没有编辑界面”,不是“要不要登录”。这两样经常被混。有个应用显示 Sign in to save,但编辑器已经全部渲染好了。我能直接往里填字,只是暂时存不进云盘。另一个应用只有一个居中的 Sign in 按钮和一句介绍。
分界线在这里,不在登录与否。
51 个入口,结果分成五堆:
- 打开就是编辑器:14 个。Spreadsheet、Documents、Presentation、Whiteboard、PDF、Photo Studio、Vector Studio、Audio Studio、Music Studio、3D Studio、CAD、Parametric、Circuits、Building Design。
- 只有介绍页和入场按钮:25 个。Records、Meetings、Teamchat、Email、Calendar、CRM、Hiring、Fleet 这些都在这一堆。
- README 的 Try it 指向一个“Demo 地址还没给”的页内锚点:6 个。Notes、Wiki、Expenses、API Client 属于这类。
- 直接 404:1 个,Field Service。
- 另有 5 个小游戏,得单拎出来,不算替代品,不然分母就虚了。名字是国际象棋、双陆棋、跳棋、纸牌、数独。
点开是个登录框,不代表功能没写。但连登录框背后都只有一段介绍文字,那就是没写。
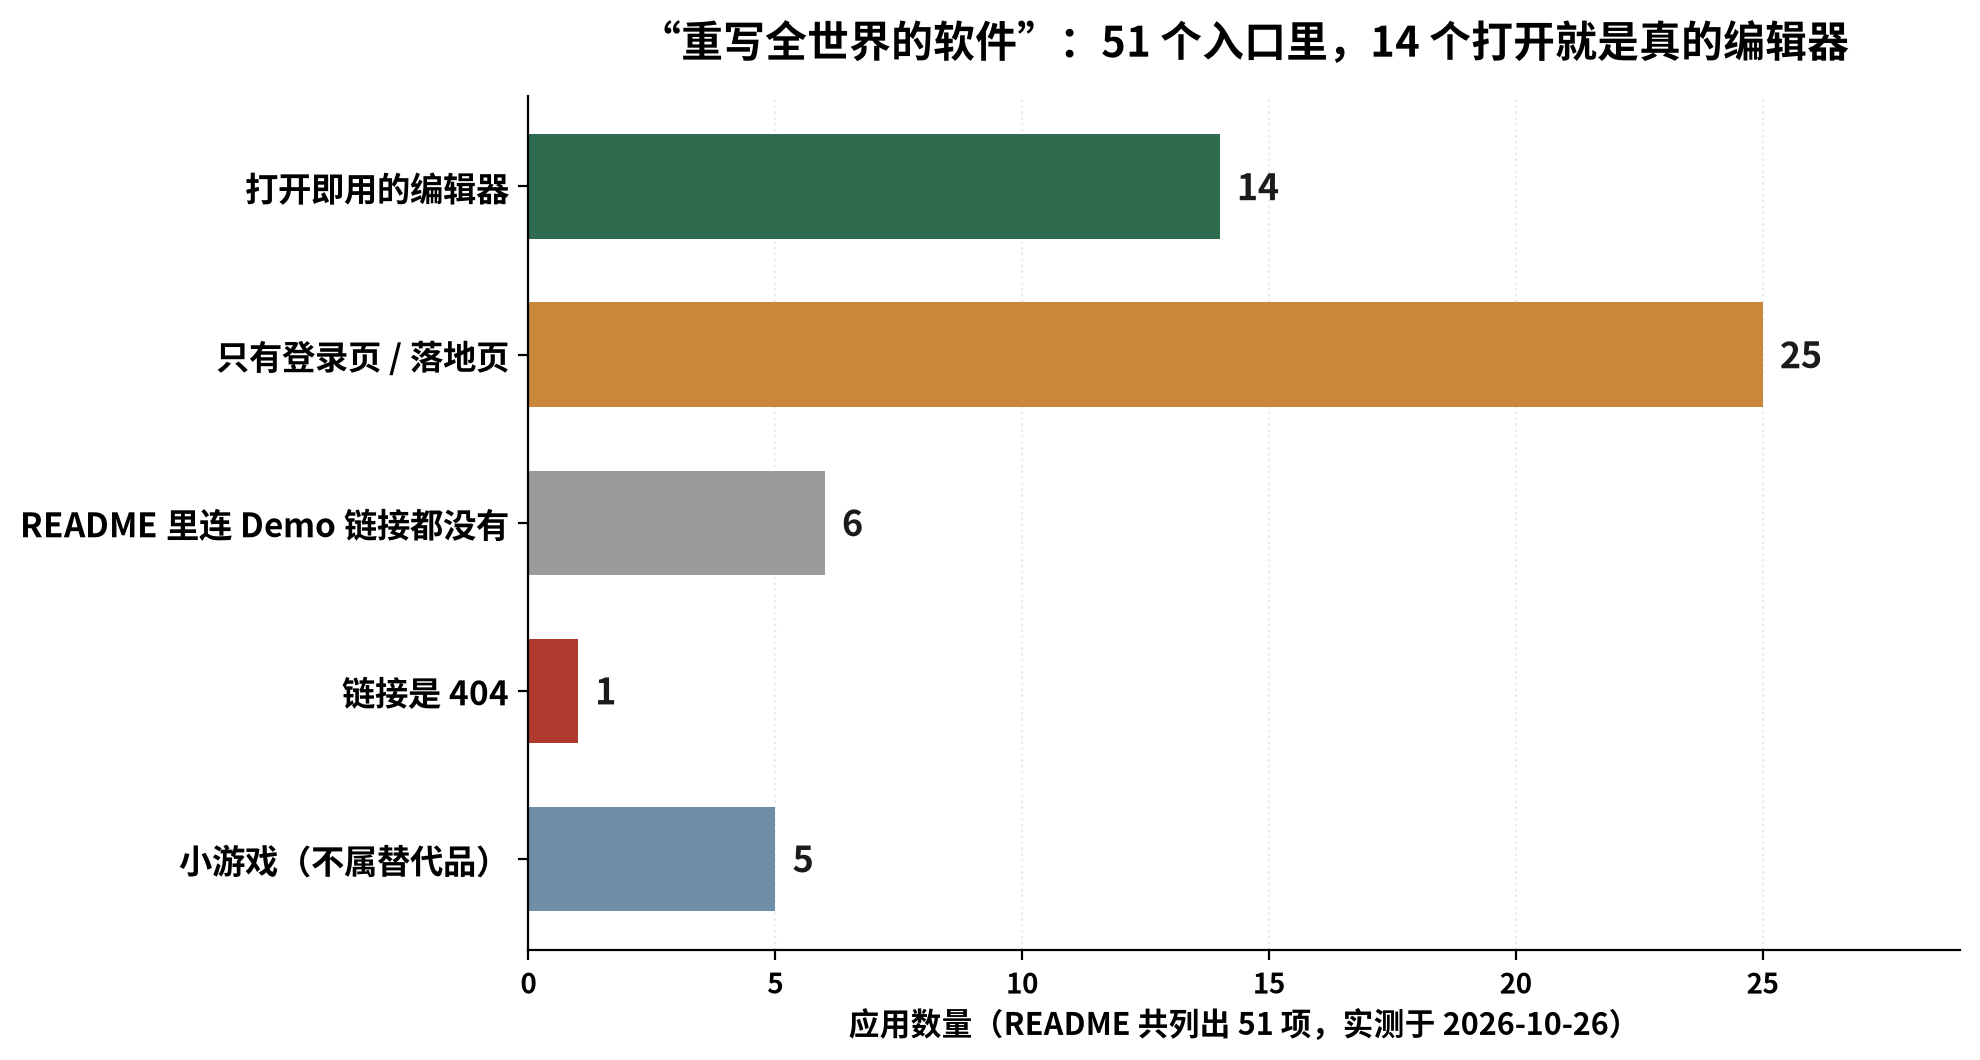
这张图是自己实测出来的,不是引用谁的说法。
14 除以 51,约等于四分之一。
对两拨人,这是同一个答案、相反的方向。想找替代品的人看到四分之一,大概就可以关页面了。对做工具的人来说恰好反着:这 14 个入口每一个都是可以拆开读的。
它给不了你“一边写前端一边铺五十个目录是什么体验”的答案,但把“先铺入口、再挑着填”这套打法演示清楚了。
真正被写了的只有两个目录,剩下的靠骨架铺得快
13 天铺开 51 个目录,听起来离谱。看一眼文件数就明白了,这件事在结构上是可以成立的。
仓库全量文件树 34216 个文件。documents 一个目录占了 13320 个,whiteboard 4777 个,spreadsheet 4151 个。剩下的应用,大多数只有几百个文件。
**铺开五十个目录的成本,和写完五十个软件的成本,差着一个数量级。**这几个数字就是那个差距的形状。
这里面的路径凡是沾 test 的,一共 17922 个文件,占 52%。按目录口径只算 tests 目录,是 17568 个,占 51%。两个数口径不同,结论一样:一半以上的文件是测试。
在开源圈这算正面信号,至少说明作者在拿测试当尺子量自己。但它也反过来标出了哪里是真的在写:测试最密的那两个目录,就是真的在写的那两个。
真正解释速度的是架构。这不是四五十个后端,它根本没有自建后端。
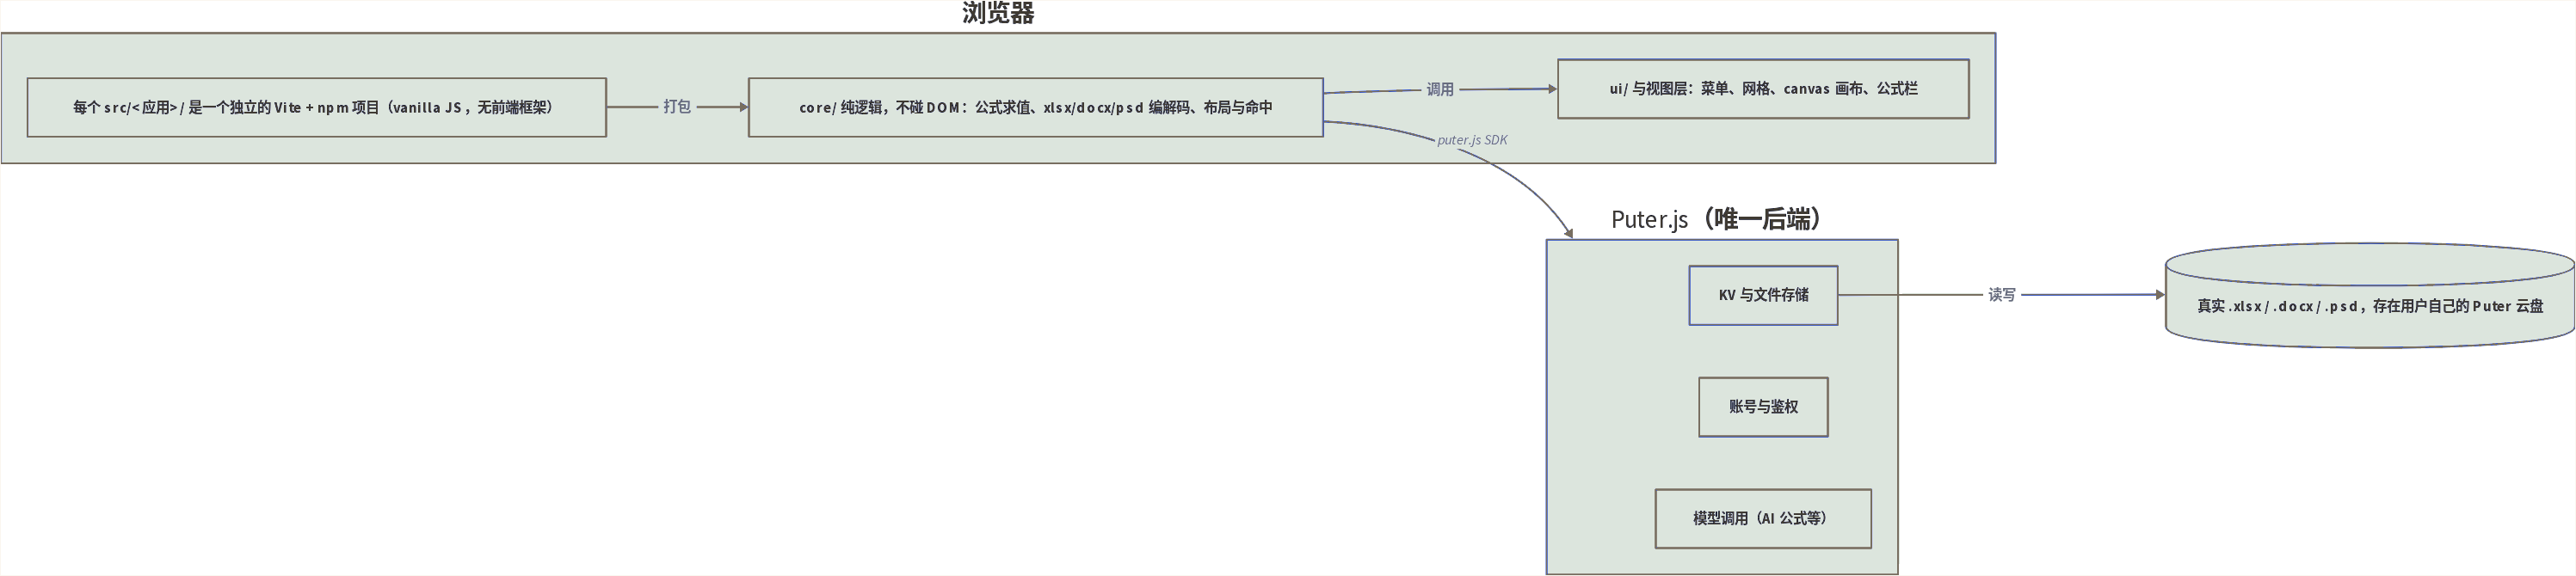
每个 src/<应用>/ 是一个独立的 Vite 项目,用 vanilla JS 写,没有 React 也没有 Vue。逻辑层 core 只管纯计算,不碰 DOM。视图层管菜单、网格、canvas。后端统一交给 Puter.js。
Puter.js 是 Puter 这家公司的 BaaS,鉴权、KV、文件存储、模型调用全是现成的。
Spreadsheet 的运行时依赖只有三个:@noble/hashes、@xmldom/xmldom、lucide。就这些。
所以“一个人 13 天做五十个软件”这句话,把因果装反了。准确的说法是:一个人用一套现成的前端骨架加一个现成的 BaaS,把五十个软件的入口先立起来,然后挑其中几个真的往里填。
填得最实的是 Spreadsheet。它的 src 目录有 534 个 JavaScript 文件,32 万多行代码,公式求值、图表、条件格式、协作都分开放在 core 底下。
这不是骨架。
作者自己写了一份“哪里没做完”的清单,比任何评测都狠
我最想看的东西不在 README,在 docs 目录里。
documents 底下有一份 docx 兼容路线图。它没有一句宣传词,就是一张勾选表:61 项没勾,1 项勾了。
每条还分类型。Missing 指特性根本不存在。Partial 指做了,但某种子集被拒、被忽略或者被限制。后者有 45 条。
开头两句写得很清楚,我直接引:
It is not a declaration of exhaustive schema coverage or native-reference layout equivalence.
还有一句更关键:
A feature being retained in XML, or appearing in an XML property-order list, does not mean it is rendered or editable.
意思是:XML 里存着这段内容,不等于它能渲染出来,也不等于用户能编辑它。
这句话把整个“格式兼容”生意的坑说完了。打开一个 docx,文件里的属性可能一个字节都没丢,但你在屏幕上看到的已经是另一份东西。
PSD 那边也是同一个路子。photo-studio 的审计文档写了 50 个样本,只有 01 到 06 走完了导入、渲染、原生工程、PSD 导出再导入的完整往返验证,第 07 个还在查。
文档里明说:在其他 PSD 软件里的验证还没做。
Spreadsheet 的自述也诚实。它说自己支持 510 多个公式函数,但单列了不支持的东西:Excel 数据模型透视表刷新、Slicer 操作、Office 自定义图标集。
有一处容易被误读,得说清。docx 文档里写着 “GitHub Actions remains disabled”,这句话指的是那份审计流程的自动化,不是整个仓库。
仓库根目录有 ci.yml 在跑。看到这句就推断“这项目连 CI 都关了”,是错的。
这些文档的存在本身,比它们写了什么更值得说。仓库里最能证明“作者知道自己在哪”的东西,不是那张应用墙的宣传图,是这几页没勾完的清单。
一个项目对自己缺什么记得这么清楚,比它宣传了什么可信得多。
该换的、该抄的,和动不了的那部分
回到选型。一个技术负责人看到这仓库,真正要回答的是两个问题,而且答案不一致。
能不能替代,答案基本是不能,边界也清楚。
单机、离线优先、数据不出自己的磁盘,这类需求上,Spreadsheet、Documents、PDF、Whiteboard 现在就能派上用场。
文件存进你自己的 Puter 云盘,是真实的 .xlsx 和 .docx,下载下来能在 Excel 里打开。给家里记账、临时改个 PDF、开会画个板子,够用。
一旦碰到这四件事,立刻停。
宏和插件生态,VBA 没了就是没了。版式保真的交付,给客户的合同、标书、论文排版都属这类。实时协同的冲突合并。合规审计。
还有一条容易忽略:它开源不等于能自托管。默认后端是 Puter 云,你要自己部署一套 Puter 才行,那是另一件事的工作量。
值不值得抄,答案是值得,但别抄整个仓库。
git clone 下来是 425 MB,51 个应用每个目录要单独 npm install,Node 22.12 以上。这不是拿起来就能跑的体量。要抄就抄三段。
公式求值怎么分层。core 里公式、图表、条件格式、协作各管一段,纯逻辑不碰 DOM,所以能单独测。想做在线表格的人,这一段的组织方式比任何教程都实在。
xlsx 往返的 sidecar 设计。它往文件里塞了一个隐藏 sheet 叫 _puter_meta,存自己的样式覆盖和图表模型。别的软件读文件时忽略它,它自己读回来。
这是“不改别人的格式,又能记住自己的状态”的一种解法。代价是文件在别的软件里会多出一张隐形表。
失败隔离怎么定规矩。docx 审计文档里有一条,我觉得是整份文档最值钱的一句:一个不支持的特性,不能毁掉文档其余部分的正常渲染。它们的做法是宁可进只读模式保住源文件,也不赌一把重排。
做过格式转换的人都懂这条有多重。
如果你只是想验证某个应用到底做没做,别点开首页就下结论。先去 src/<应用>/ 看有没有 src 和 tests,再看 package.json 里的 scripts,最后才看 README。
今天那 25 个只有登录页的应用里,不少目录是空的。
顺便说一句我这轮的局限。我没登录,所以登录之后那些应用能做到什么,我不知道,也不猜。**14 这个数字是“不登录能动手”的下限。**真实可用数可能更高,也可能高不了多少,这个得你自己登进去点一下。
一个仓库的宣传图和它的文档,通常是两个作者写的。这个仓库有意思的地方在于,它们是一个人写的,而且文档那份比宣传那份诚实。