9 月 4 日,openai/codex 一个 0.153.4 的热修上线后,只要你的 ~/.codex/config.toml 里没有显式写 model,下一次升级起,你的 Codex CLI 就默认跑在 GPT-6-Astra 上,而你大概率根本没注意到。
这条热修不是什么大新闻,但它悄悄改了一个默认值,正好踩中大多数团队都会踩的坑:工具替你选模型,升级替你做架构决策。这篇讲给所有把 Codex 接进 CI、多人团队或生产链路的开发者——四个具体动作:把模型钉死在 config、搞懂 Fast 模式的成本口径、分清 stable 和 alpha 双通道、以及 Bedrock 侧的路由别配错。不评论 Codex 和 Claude Code 谁强,只算清一次升级可能带走你多少确定性和多少钱。
一个热修能改变的,是你整个团队的推理后端
先说证据,都在官方 release notes 里,可查。
0.153.4(2026-09-04,#42874)这么写的:“Fixed Astra’s visibility in the bundled model picker and made it the bundled default when no model is explicitly configured."——翻译过来就是:当你没有显式配置模型时,Astra 成为打包默认。
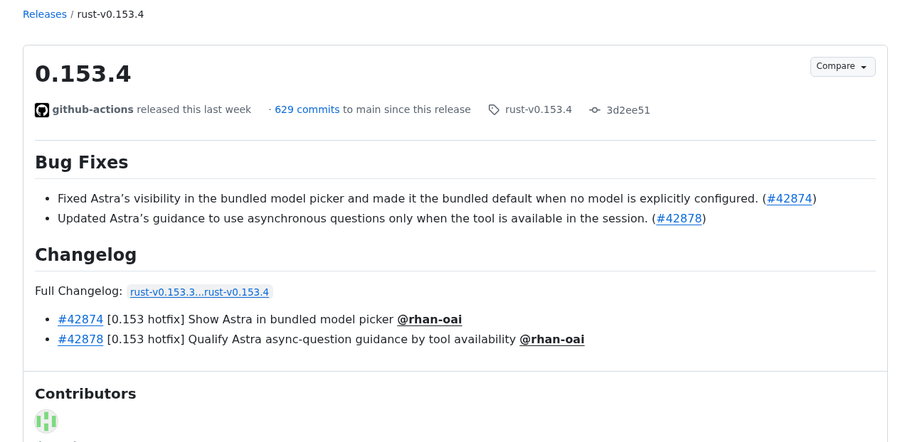
注意这个措辞。“bundled default” + “when no model is explicitly configured” 是两个叠加条件。它没有强制改掉你 config 里写死的 model = "...",它改的是未配置时的兜底值。问题恰恰出在"未配置"这三个字上——绝大多数人根本不知道自己有没有配过模型。
你查一下自己:cat ~/.codex/config.toml,如果里面没有 model 这一行,或者只有团队模板里抄来的一行 model = "gpt-5" 但没写 Astra,那 0.153.4 之后的每次 CLI 升级,你的请求都会打到 GPT-6-Astra。这不是你选的,是热修替你选的。
这事的危险性不在"Astra 好不好”,而在你的选型权和你的成本预算,被一个不声不响的 bugfix 接管了。对一个跑在 CI 里、脚本里、多人共用的 agent CLI 来说,模型就是它的"运行时",运行时被悄悄换掉,跟依赖被悄悄升级是一个性质。
默认值陷阱:为什么"没配就是安全"是错觉
多数人觉得"我没动配置,所以系统用默认,默认总是稳妥的"。对稳定不变的软件成立,对快速迭代的 agent 工具不成立。
Codex 的模型默认值不是一次定死的。它在 0.153 这一个版本号里就变了多次:
- 0.153.0(9-03):还只是把 Astra 放进模型目录,没动默认;
- 0.153.1(9-03,#42605):加了"通过 API 配置 Astra 但不改默认模型、不显示在 picker 里"的能力——注意,官方自己在做"配置新模型但不碰默认"这个操作,说明当时默认仍是旧模型;
- 0.153.4(9-04,#42874):把 Astra 设为未配置时的默认。
三天之内,默认值从"旧模型"跳到"Astra"。如果你在 9 月 3 日那天看了 0.153.0 的 release notes,觉得"只是加了新模型,不影响我",到 9 月 4 日晚上你就已经在用 Astra 了。验证一次默认值只能管一天,管不了下一次热修。
默认值陷阱就藏在这:默认值是一种会自己变化的常量,你用任何依赖锁定手段都没法锁它,除非显式声明。对编程 agent 这类"模型即运行时"的工具,model 这一行必须写出来。
默认值是会自己变化的常量——想锁住它,只能显式声明。
钉死模型,是今天就能做的最小动作
具体怎么做,给一份可直接照抄的清单,分三档:
第一档:个人机器(立刻做)
|
|
这一行就够了。加上它,你就不受"未配置兜底"影响。想换回旧模型,把 model 改成对应的模型名即可。运行时也可以用 codex --model gpt-5.6-sol 或 codex -c model='...' 临时覆盖,不污染配置文件。
第二档:项目级(团队共用)
在仓库根目录放 .codex/config.toml,把 model 写进去,让每个 clone 这个仓库的人都用同一个模型,而不是各自机器的全局配置。这样版本控制会记录模型变更,谁改了模型、什么时候改的,都在 git 历史里。
第三档:CI / 脚本 / 流水线(必须显式)
CI 里不要依赖任何配置文件默认值,直接在命令里传:
|
|
把模型名当作 CI 的一个环境变量或 pipeline 参数,这样升级 codex CLI 不会静默改变你的 CI 行为。CI 最怕你以为是旧模型、实际是新的——整个流水线的结果漂移了还没人察觉。
在 CI 里,模型名应该是个显式参数,而不是一个你假设的默认值。
Fast 模式:速度是拿真金白银换的
0.153.2(9-03,#42632)还改了一行文案:把 GPT-6-Astra Fast tier 的描述从 “1.5x” 更正为 “2x speed, increased usage”,并明确"只改显示文字,不改请求如何运行"。
“只改显示文字"这句话才是最值钱的信号:它说明 Fast 模式的实际倍率一直是 2x,只是文案写错了。你团队里如果有人在 9 月 3 日之前看到 “1.5x” 并按 1.5 倍去估预算,那他的预算模型从一开始就是错的。
Astra 的价格锚点(OpenAI 官方定价页,标准档、短上下文):
- 输入 $10 / 百万 token
- 输出 $50 / 百万 token
- 缓存输入 $1 / 百万 token,缓存写入 $12.50
- Fast 模式 = 标准价 ×2(即 $20 进 / $100 出)
- 超 272k token 的长上下文:输入 $20 / 输出 $75(Fast 再 ×2)
所以 Fast 是拿 2 倍单价换 2 倍速度,不是什么免费提速。个人写代码,体感是"更快了”;团队或 CI 里,token 预算直接翻倍。
这里有个工程判断:Fast 模式的成本是按倍率算的,不是按时间算的。你省下来的时间价值是否超过多付的一倍 token 钱,取决于你的场景。如果是开发者在本地交互式用,速度的价值可能高;如果是跑在 CI 里、一跑就是一整晚的批量任务,开 Fast 等于每百万 token 多付一倍,而你晚上也没有人等着它更快。批量场景默认别开 Fast,先看跑完的真实 token 消耗再说。
持久化 Fast 模式的方式(官方文档):config 里 service_tier = "fast" 加 [features].fast_mode = true,或者运行时用 flag。
双通道怎么选:stable 跟紧,alpha 别踩坑
Codex 是双发布通道。稳定线目前是 0.153.x(0.153.4 是 latest),alpha 线在 0.155.0-alpha 附近,离 main 分支还有数十个 commit,属于 pre-release。
选型原则很简单,但也容易被忽略:
- CI、团队、生产:永远跟 stable(latest 标签),别追 alpha。热修如 0.153.4 就是为 stable 线打的补丁,你只要跟 latest 就能拿到。
- 个人尝鲜 / 验证新特性:才上 alpha,而且每个 alpha 都要单独验证,因为 pre-release 随时可能改默认、改行为。
这里的坑是:很多团队"顺手"用了 npm i -g @openai/codex@latest 或类似方式,以为 latest 就是 stable。但 pre-release 也可能被某些安装路径带上,一旦装成 alpha,你就提前吃到了还没稳定的行为变更。在团队安装脚本里显式锁定版本号(例如固定到 0.153.4),而不是 @latest,是最稳的一招。
团队跟 stable 且锁版本号,个人才上 alpha 且逐个验证。
Bedrock 侧:模型 ID 和路由是两件事
如果你通过 AWS 用 Codex,Astra 的接入(0.153.3,#42805)有个特别容易配错的地方:它同时进了 Bedrock 的 Mantle 和 Runtime 两条路由,而两边的模型 ID 写法不一样。
- Mantle 端点(只在 us-west-2):模型 ID 用
openai.gpt-6-astra,不带 global / US 前缀,原样写; - Runtime 端点(不支持同区直连):跨区要用带地理前缀的 ID——US 地理用
us.openai.gpt-6-astra,全球用global.openai.gpt-6-astra。
一句话:Mantle 的 ID 原样带 openai.,Runtime 的 ID 要看你走的区。
多云接入时,很多人以为"模型名一致就万事大吉",结果在 AWS 里直接抄 OpenAI 侧的 gpt-6-astra,不带 openai. 前缀或地理前缀,就会 404 或路由到错误区域。这块没有"通用正确写法",只有"按你接的端点查文档"。
这套操作有个边界:别为了"锁定"而过度工程
这套操作有边界,说清楚什么时候不需要它。
如果你只是一个人、在自己的笔记本上交互式用 Codex,不接 CI、不跑批量、不看预算报表,那"钉死模型"对你更多是心理安慰,不是刚需——你随时能 codex --model 覆盖,成本敏感度也低。这套清单的价值密度,是随着"模型选择影响多少人、多少钱"而升高的:单人本地 < 项目团队 < CI 流水线 < 多云生产。
反过来说,如果你们团队已经把 Codex 接进了生产链路,那上面的每一档都值得做,而且趁早做。因为这类默认值变更从来不是最后一次——今天换默认模型,明天就可能换默认上下文长度、默认服务 tier、默认路由。你每一次都靠"事后看 release notes 再补救",不如把"模型显式声明"变成团队配置的基线纪律。
现在就能查:三分钟,三件事
不用大动干戈,按顺序来:
- 查自己:
cat ~/.codex/config.toml,看有没有显式model;没有就加上,model = "gpt-6-astra"(或你团队指定的模型)。一分钟,堵住默认值陷阱。 - 查团队:CI 和安装脚本里是
@latest还是锁版本?CI 的命令里有没有显式传--model?没有就补上,把模型名变成显式参数。 - 算一笔账:如果开了 Fast,看一眼最近一周的 token 消耗,按 2 倍单价算它比 Standard 贵了多少,再决定值不值。批量场景默认关 Fast。
你的推理后端不该由一次热修替你决定。把模型从"默认"改成"声明",花不了几分钟,是这周最省事的一笔改动。
参考与验证
- openai/codex Releases(0.153.4 默认模型变更 #42874、0.153.3 Bedrock #42805、0.153.2 Fast 文案 #42632、0.153.1 API 配置 #42605):https://github.com/openai/codex/releases (访问日期 2026-09-15)
- openai/codex 仓库 Star/Fork:124k★ / 19.1k fork(GitHub API 复核,访问日期 2026-09-15)
- GPT-6-Astra 定价(OpenAI 官方定价页 + 多家第三方汇总一致):标准档 $10 输入 / $50 输出、缓存 $1、Fast ×2、272k+ 长上下文 $20/$75;https://www.cloudzero.com/blog/gpt-6-pricing 、https://www.yottalabs.ai/post/gpt-6-astra-pricing-api-cost-2026 (访问日期 2026-09-15)
- Codex config 模型钉死 / Fast mode 持久化方式(官方文档)及 Bedrock Mantle/Runtime 路由:见 openai/codex 官方 docs(访问日期 2026-09-15)