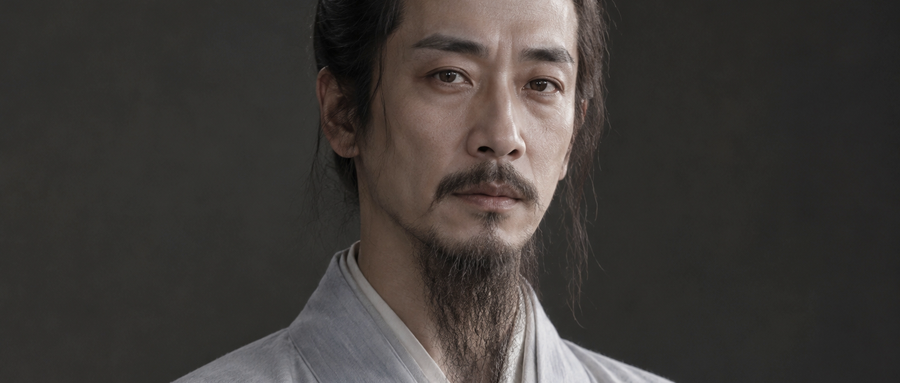
我最近做了条 18 秒的片子:一个唐代装束的人,在便利店过道里横向滑出一步,急停,顺手拉开冰柜拿了瓶酒。
【视频 01|18 秒成片】
发出去之后问得最多的不是"用的什么模型",是"为什么我写同样的提示词,出来的人像在滑冰"。
这篇把过程拆开讲。方法跟模型关系不大,换哪个工具都能用。
一句话生成,出来的东西像个 PPT
我第一版就是一句话:一个唐代诗人跳闪身步。
出来的东西不能说难看,只能说像个 PPT。人物每秒钟都在微微变形,衣服飘的幅度像被风吹的塑料袋,脚底在滑,不是跳。
连着废了三条,才想明白问题在哪。
我给的是"事件",不是"动作"。
“横向一闪"这四个字,在我脑子里是一个很具体的东西:重心先沉,腰腹发力,脚跟着走,落地砸住。但在模型那儿,它有一万种可能。它挑了一种最省力的,慢慢滑过去。
所以真正要做的,不是把提示词写得更华丽,是把"动作"这件事拆到模型能执行的程度。
下面五步,是我最后跑通的路子。
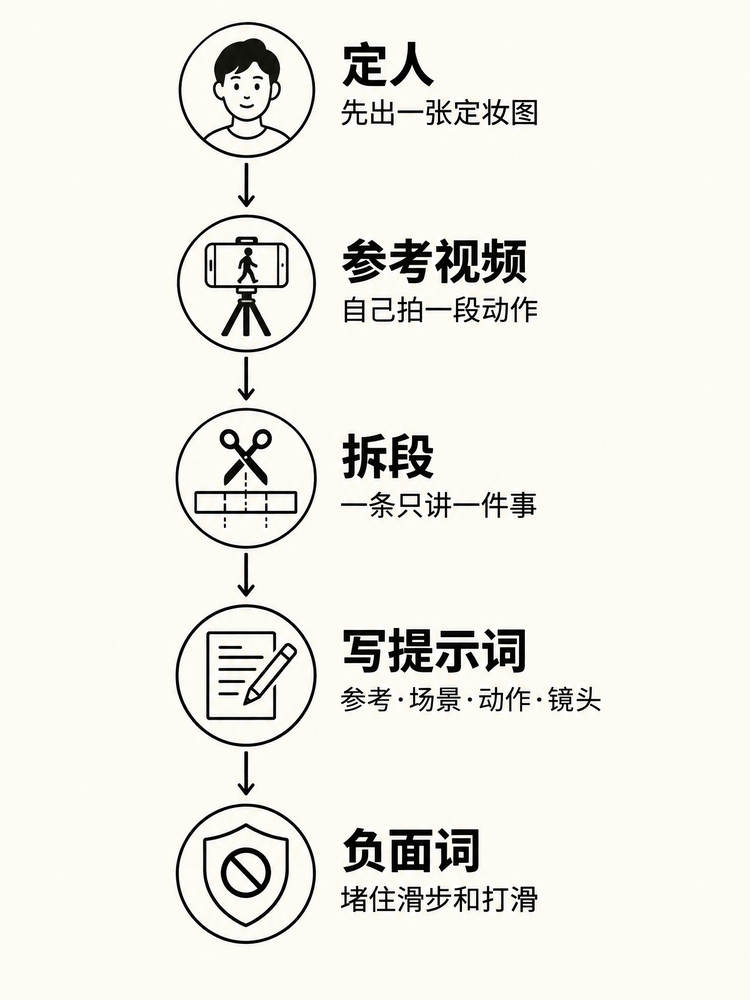
先把人钉死,别让模型每一帧重画一次脸
这一步最容易被跳过,但省不得。
视频模型是逐帧重绘的,每一帧都在重新猜这张脸长什么样。你不给它一个固定参照,它就会飘。飘得不明显的时候像没睡醒,飘得明显的时候直接换人。
做法是:先单独生成一张定妆图。
正面、半身、纯色背景、光打在侧上方、表情平静。人物特征一次说全,衣服颜色、发型、胡须、年龄段都写死。我用的提示词是这样:
|
|
出图之后先自己看一眼。脸是不是能看、衣服有没有穿错、有没有多余的手指。这一步不解决问题,后面每一段都会带着这个错误跑。
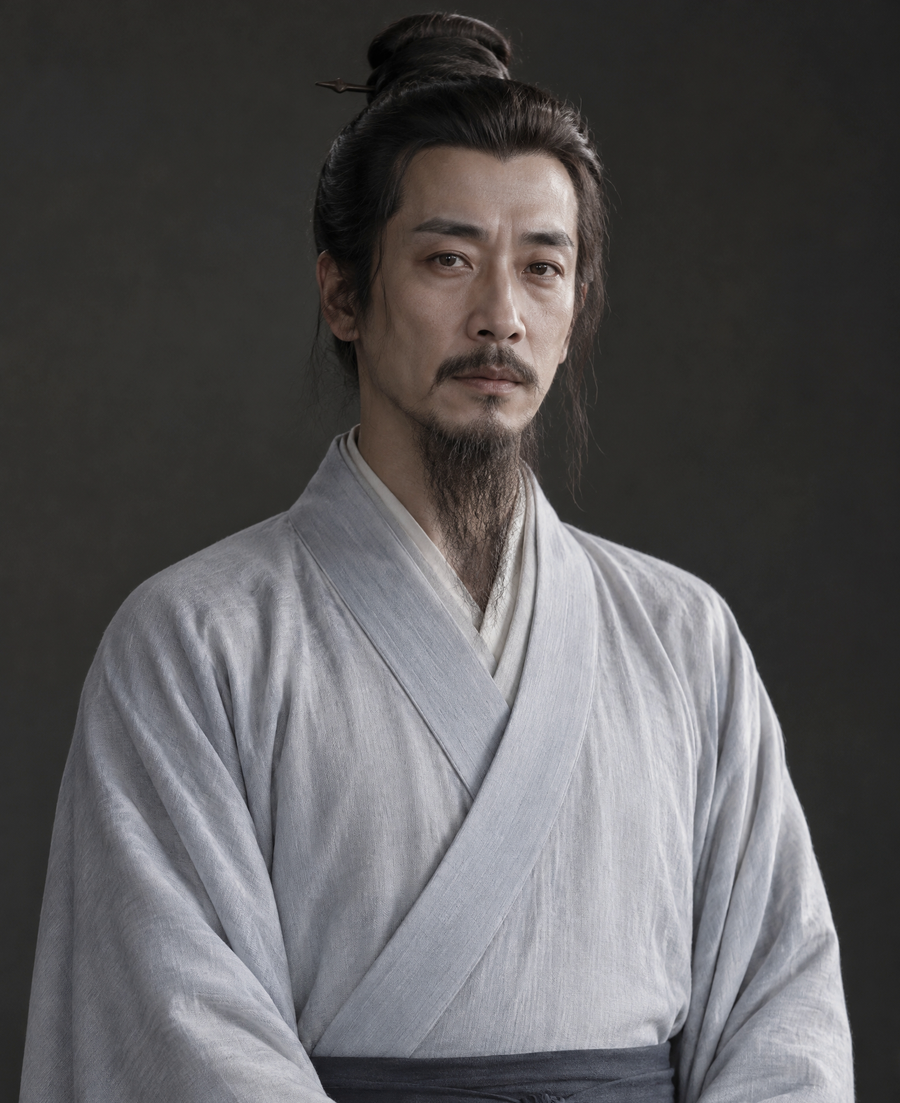
定妆图定下来,后面每一段都拿它当参考图。
拍一段你自己跳的舞喂进去,这是整条链路里提效最狠的一步
文字描述动作,模型永远在猜。给它一段参考视频,它就不用猜了,照着做。
我的做法很土:手机架在椅子上,竖屏,全身入画,在客厅跳了七八遍,挑最像的一段,剪到八秒。
【视频 02|自己拍的参考视频】
拍的时候注意三件事。
全身要进画面。 只拍上半身,模型学不到脚下的动作,出来还是滑。
别剪太快。 参考视频是给它学动作节奏的,不是给它看剪辑的。一镜到底最好。
不要用别人的视频,尤其别用明星的。 一方面是平台对真人素材有验证要求,另一方面,那个人的脸和身材会渗进你的画面,最后出来一个既不像你也不像他的东西。
自己拍,丑点没关系,动作对就行。
拆段,一条只讲一件事
我这条 18 秒的片子,拆成了三个 6 秒。
不是我想拆,是必须拆。六秒里塞进"起势、滑出、急停、表情"四个动作,已经满了。再往里加,模型就开始偷工减料:要么动作糊,要么人物开始漂,要么干脆跳帧。
三段的分工是这样的。
第一段,从水墨画里走出来。黑白墨色,人慢慢踱步,走到中间突然横着一闪,墨迹被带起来,画面同时从水墨转成实景。这一段是钩子,负责让人"哎?“一声。
第二段,便利店过道。货架一直延伸到画面深处,冷白灯管,他站定,腰腹一拧,滑出去,刹住。这一段是正片,负责让人看清楚动作。
第三段,冰柜前。跳完顺手拉开冰柜门,冷气涌出来,拿一瓶酒,拧开喝一口,看镜头。这一段是人设,负责让人笑。
拆段的判断标准很简单:一段里超过四个动作,就该拆。
提示词按顺序排,动作写成链条不写成结果
提示词不是写得越长越好,是要有顺序。我现在的写法是固定的六段:
参考对象 → 场景 → 动作链 → 镜头 → 光线 → 风格和节奏
拿第二段举例:
|
|
几个我自己试出来的细节。
动作要写成链条,不要写成结果。 不写"他跳了一段舞”,写"腰腹先拧,脚跟一蹬,滑出,落地刹住,肩膀还在晃”。一步接一步,模型才知道顺序。
“刹住"这个词必须出现。 不写它,模型就默认你要一个平滑的收尾,最后软绵绵地定在那儿。急停这件事,得明说。
镜头要写死。 固定、手持、跟随、推近,选一个。不写,它会自己给你加运镜,加完动作就看不清了。
光线一句话就够。 冷白灯管、暖黄路灯、侧逆光,这类词比"氛围感"有用一百倍。
负面词两头夹:正面写"刹住”,负面写"打滑"
负面词在这条片子里不是可选项。如果只留一样东西,我会留负面词。
|
|
里面最关键的是"滑步拖沓"和"脚底打滑"。模型对"横移加急停"这件事天然不擅长,它更愿意做成滑行,因为滑行在训练数据里更常见。正面提示词写"刹住",负面词写"打滑",两头夹,才压得住。
参数我一般这么定:竖屏 9:16,6 秒一条,1080P。参考图一张,参考视频一段,不超过十秒。声音关掉。
关声音这条,后面讲。
出片之后,卡点比调色重要
三段都出来之后,别急着调色。
先把片子接起来,找一段鼓点明显的音乐,把每一段"刹住"的那一帧,卡在重音上。卡准了,那个停的力道会放大一倍。卡不准,就还是滑。
这也是为什么建议生成的时候关掉声音。模型配的音跟你的音乐对不上,后期还得拆掉,不如一开始就不给它。
四个坑:参考视频是地基,提示词只是装修
坑一:以为提示词能替代参考视频。
不能。没有参考视频,什么模型都在滑。参考视频是地基,提示词是装修,顺序别搞反。
坑二:一条里塞五个动作。
我第三段本来是一条,开门、取酒、拧盖、喝、看镜头,五个动作挤在六秒里,人物的手直接穿模了。拆成两段各四秒,干净了。看到跳帧别硬压提示词,拆段。
坑三:拿网上的图当人物参考。
尤其是真人照片。一是平台有限制,二是那张脸的特征会一直跟着你,最后出来四不像。自己生成一张,或者用自己拍的。
坑四:一次生成就想成。
我这条片子废了七条。AI 视频现在的状态,就是得跑量筛。心里要有个预期:一条能用的,背后至少三四条废的。
工具用的是即梦里的 Seedance 2.0。选它的原因很实际:能同时吃参考图和参考视频,单条最长 15 秒,还支持 9:16 竖屏。
这三个能力正好对应拍参考视频和拆段这两步。换个只能文生视频的模型,这套流程要改一大半。参数就是上面那一组,没调过什么玄学设置。
这套方法不挑题材。
你想让一个历史人物跳热梗,想让自家猫做个人类动作,想让产品自己在桌上转一圈,流程都是一样的:先定人,再给动作参照,再拆段,再按顺序写,最后用负面词堵住那些一定会犯的错。
模型会越来越强,但"把一件事拆到可执行"这件事,还是得人来干。
今晚就可以试:不用写新提示词,把你上次那句一句话提示里的动作,拆成"先哪、次哪、最后刹在哪"三步,再配一张定妆图跑一次。同样一个模型,出来的东西滑不滑,差别就在这两步上。